
大模型原理与训练 / 系统课时
项目部署与复盘
项目部署与复盘
本课把已经训练完成的 Transformer 分类模型封装为可部署的 HTTP 服务,并通过容器完成启动与验收。完成后,你还会得到一套可复用的复盘框架,用于同时评价模型效果、服务性能、已知限制和下一轮改进优先级。
学习目标
- 将本地模型目录封装为可启动、可健康检查的推理服务
- 使用 Docker 完成构建、运行和接口验收
- 从效果、性能、稳定性和限制四个维度完成项目复盘
明确部署边界与验收标准
本课假设最终模型是一个兼容 Hugging Face Transformers 的文本分类模型,模型目录中至少包含 config.json、模型权重、分词器配置和词表文件。部署目标不是搭建完整生产平台,而是交付一个可重复启动、可调用、可验证的最小服务。
上线前先约定四项验收条件:服务启动后健康检查返回成功;预测接口能接收文本并返回标签与置信度;模型只在进程启动时加载一次;容器重建后仍能得到相同的接口结构。模型标签和值可能因训练任务不同而变化,但接口字段不应随意改变。
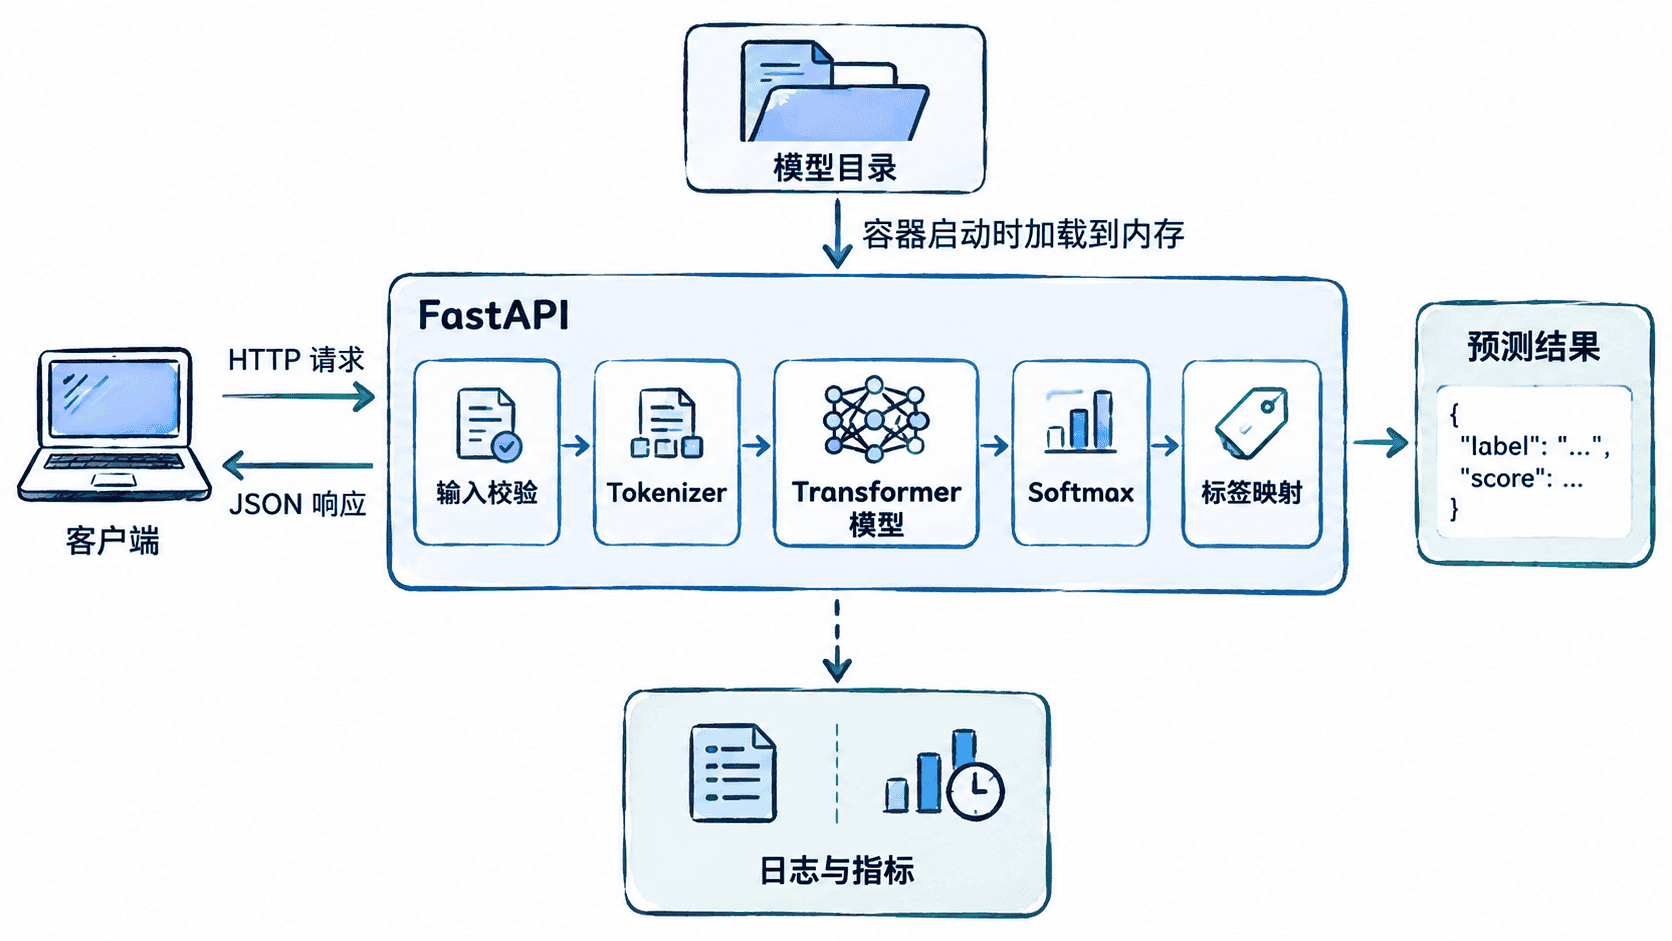
构建最小推理服务
创建 deploy 目录,并把训练完成的模型复制到 deploy/model。下面的服务会在启动阶段加载模型,使用 torch.inference_mode() 关闭梯度计算,并限制输入最大长度,避免异常长文本直接消耗过多内存。
app.py:
import os
import time
from contextlib import asynccontextmanager
from typing import Any

import torch
from fastapi import FastAPI
from pydantic import BaseModel, Field
from transformers import AutoModelForSequenceClassification, AutoTokenizer

MODEL_PATH = os.getenv("MODEL_PATH", "./model")
MAX_LENGTH = int(os.getenv("MAX_LENGTH", "512"))
runtime: dict[str, Any] = {}

@asynccontextmanager
async def lifespan(app: FastAPI):
    tokenizer = AutoTokenizer.from_pretrained(MODEL_PATH, local_files_only=True)
    model = AutoModelForSequenceClassification.from_pretrained(
        MODEL_PATH,
        local_files_only=True,
    )
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
    model.to(device)
    model.eval()

    # 只在进程启动时加载一次,避免每个请求重复读取模型文件。
    runtime.update(tokenizer=tokenizer, model=model, device=device)
    yield
    runtime.clear()

app = FastAPI(title="Transformer Model Service", lifespan=lifespan)

class PredictRequest(BaseModel):
    text: str = Field(min_length=1, max_length=2000)

class PredictResponse(BaseModel):
    label: str
    score: float
    latencyMs: float

@app.get("/health")
def health() -> dict[str, str]:
    return {
        "status": "ok",
        "modelPath": MODEL_PATH,
        "device": str(runtime["device"]),
    }

@app.post("/predict", response_model=PredictResponse)
def predict(request: PredictRequest) -> PredictResponse:
    started = time.perf_counter()
    tokenizer = runtime["tokenizer"]
    model = runtime["model"]
    device = runtime["device"]

    encoded = tokenizer(
        request.text,
        return_tensors="pt",
        truncation=True,
        max_length=MAX_LENGTH,
    )
    encoded = {name: tensor.to(device) for name, tensor in encoded.items()}

    with torch.inference_mode():
        logits = model(**encoded).logits
        probabilities = torch.softmax(logits, dim=-1)[0]

    class_id = int(torch.argmax(probabilities).item())
    label = model.config.id2label.get(class_id, str(class_id))
    latency_ms = (time.perf_counter() - started) * 1000

    return PredictResponse(
        label=label,
        score=round(float(probabilities[class_id].item()), 6),
        latencyMs=round(latency_ms, 2),
)requirements.txt:
fastapi
uvicorn[standard]
transformers
torchDockerfile:
FROM python:3.11-slim

WORKDIR /app

COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

COPY app.py .
COPY model ./model

ENV MODEL_PATH=/app/model
ENV MAX_LENGTH=512

EXPOSE 8000

CMD ["uvicorn", "app:app", "--host", "0.0.0.0", "--port", "8000"]
这三个文件与 model 目录放在同一目录后即可构建。配置生效的关键标志是容器启动时没有模型文件缺失错误,并且 /health 返回 status=ok。
构建、运行与接口验收
在 deploy 目录执行以下命令。示例使用 CPU 容器;若要使用 GPU,还需要匹配宿主机驱动、CUDA 运行时和对应的 PyTorch 镜像。
docker build -q -t transformer-service:1.0 .
docker rm -f transformer-service >/dev/null 2>&1 || true
docker run -d   --name transformer-service   -p 8000:8000   transformer-service:1.0 >/dev/null

until curl -fsS http://127.0.0.1:8000/health >/dev/null; do
  sleep 1
done

curl -sS -w '\nHTTP %{http_code}\n' http://127.0.0.1:8000/health
curl -sS -w '\nHTTP %{http_code}\n' \
  -H "Content-Type: application/json" \
  -d '{"text":"这门课程非常清晰"}' \
  http://127.0.0.1:8000/predict
预期输出:
{"status":"ok","modelPath":"/app/model","device":"cpu"}
HTTP 200
{"label":"<LABEL>","score":<SCORE>,"latencyMs":<LATENCY_MS>}
HTTP 200<LABEL>、<SCORE> 和 <LATENCY_MS> 由模型、输入文本和运行环境决定,实际值可能不同。验收时重点检查 HTTP 状态码为 200、字段齐全、score 位于 0 到 1 之间,并确认连续调用不会重复加载模型。
用指标完成项目复盘
复盘不能只写“模型效果不错”。应把离线效果和在线工程表现分开记录,并为每个结论保留可复现的证据。
| 维度 | 建议指标 | 结论写法 |
|---|---|---|
| 模型效果 | Accuracy、Macro-F1、各类别召回率 | 指明测试集版本,并说明弱势类别 |
| 服务性能 | P50/P95 延迟、吞吐量、冷启动时间 | 同时记录硬件、批大小和输入长度 |
| 资源占用 | 模型大小、常驻内存、显存峰值 | 区分加载后占用与请求峰值 |
| 稳定性 | 错误率、超时率、连续运行时间 | 记录失败请求样本和对应日志 |
| 可维护性 | 镜像大小、配置项、回滚步骤 | 确认模型与服务版本能一一对应 |
已知限制也要写成可行动的问题。例如:长文本会被截断,说明需要滑动窗口或长上下文模型;小类别召回率偏低,说明需要补充样本或调整损失函数;单进程吞吐不足,说明可以尝试批处理、多进程或专用推理引擎。每个限制后只保留一个优先级最高的改进动作,避免形成无法执行的愿望清单。
形成可追踪的改进计划
最终复盘建议输出一页结论:当前版本是否达到上线门槛、最重要的三项指标、两个已知限制和下一版本的一项主目标。主目标应能量化,例如“在相同硬件和相同测试集下,将 Macro-F1 提升到指定阈值,同时把 P95 延迟控制在目标范围内”。
发布时还要保存模型目录校验值、容器镜像标签、代码提交号和评测数据版本。这样出现结果回退时,才能判断问题来自模型权重、服务代码、依赖变化还是输入分布变化,而不是依赖人工回忆。
本课总结
- 一个可交付的模型项目必须同时包含模型文件、服务接口、容器配置和验收步骤
- 复盘应分开评价离线效果、在线性能、稳定性与资源占用
- 已知限制只有绑定证据、优先级和下一步动作,才会转化为有效迭代计划
下一课预告
下一课将把本次部署与复盘结果整理为版本化迭代清单,进一步建立模型、数据、代码和评测结果之间的可追踪关系。