
大模型原理与训练 / 系统课时
语言建模目标
语言建模目标
语言模型训练并不是让模型“记住整句话”,而是把文本转换成可计算的预测任务。本课将分别拆解因果语言建模与掩码语言建模,说明它们怎样构造输入、选择标签,以及哪些位置真正参与损失计算。
学习目标
- 说清因果语言建模与掩码语言建模各自在预测什么
- 根据原始文本构造训练输入、目标标签和有效监督位置
- 区分因果掩码、掩码词元与填充掩码的不同职责
训练目标决定什么
模型接收的是词元序列,训练目标必须明确“给定哪些信息,预测哪个词元”。优化器并不直接理解语义,它只会根据预测分布与目标标签之间的误差更新参数。因此,训练目标决定模型能看到的上下文、哪些位置产生梯度,以及模型最终更擅长理解还是生成。
因果语言建模
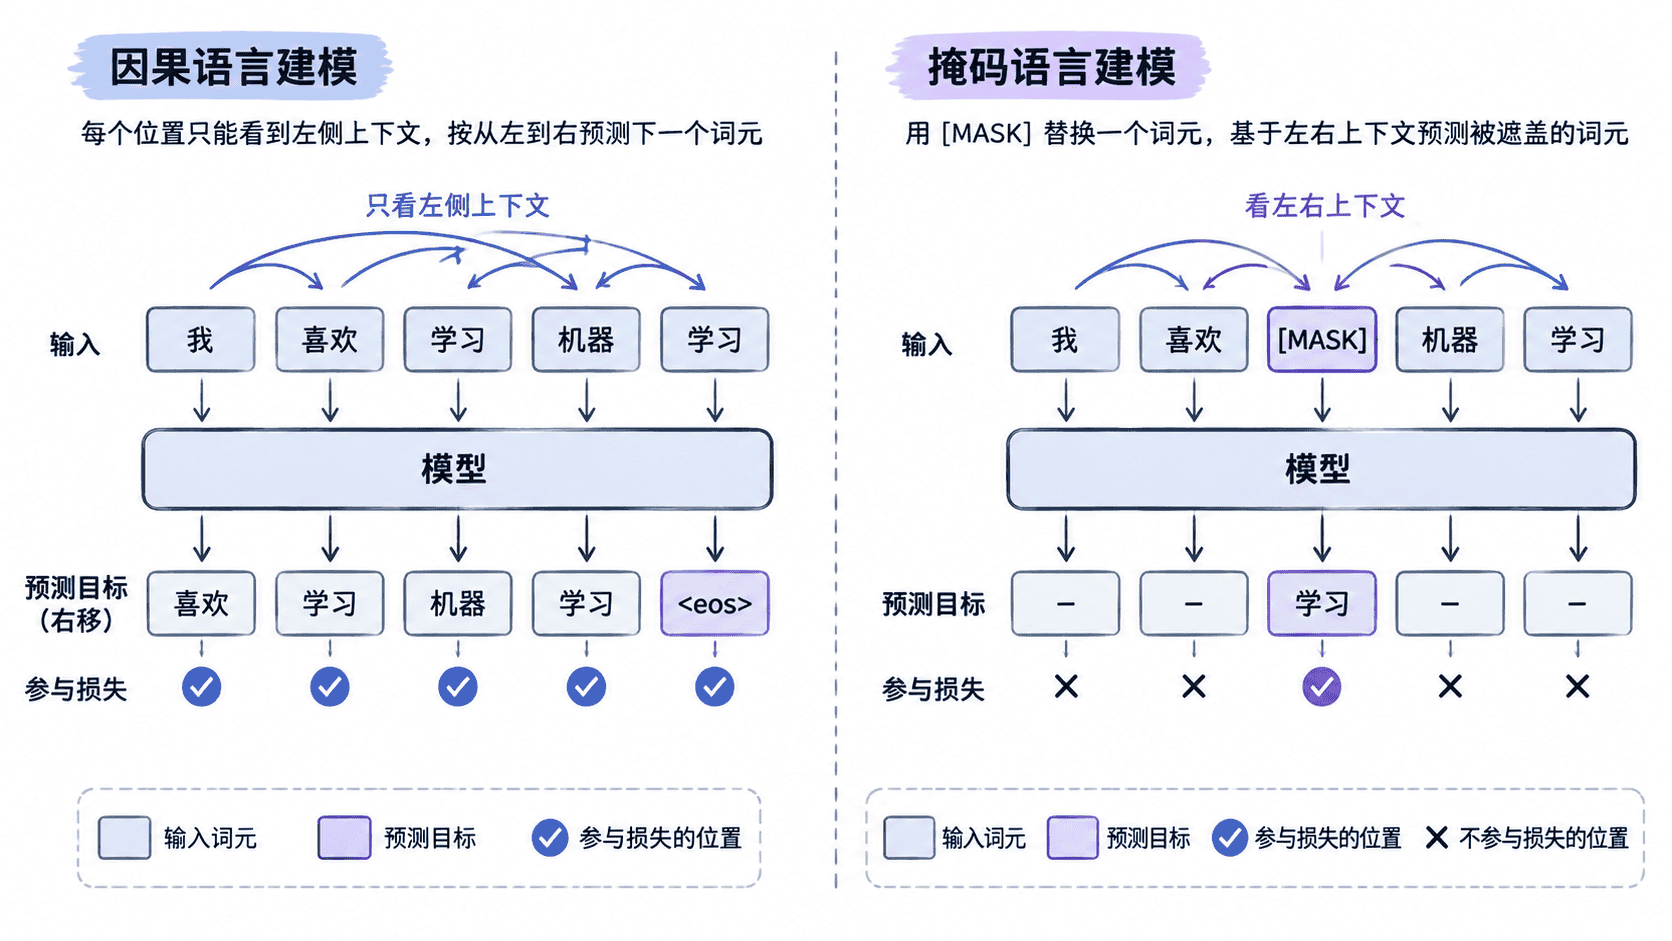
因果语言建模也叫自回归语言建模。给定序列 ,模型在第 个位置只能使用左侧词元 ,预测当前目标 :
例如原始序列是“我 喜欢 学习 AI”,训练输入可以看成“我 喜欢 学习”,标签右移一位后对应“喜欢 学习 AI”。实现中通常仍一次送入完整序列,但通过因果注意力掩码阻止当前位置看到未来词元。
这种目标与生成过程一致:模型根据已有内容预测下一个词元,再把新词元追加到上下文中继续预测。GPT 类生成模型通常采用这一目标。
掩码语言建模与关键边界
掩码语言建模先从序列中选出一部分位置,将原词元替换为 [MASK]、随机词元或原词元,再要求模型恢复被选中的内容。设被选位置集合为 ,其损失为:
例如“我 喜欢 学习 AI”可以变成“我 [MASK] 学习 AI”,标签只保留“喜欢”这一位置。模型能够同时利用左右两侧上下文,因此更适合学习双向表示,但训练方式与逐词生成并不完全一致。
| 对比项 | 因果语言建模 | 掩码语言建模 |
|---|---|---|
| 输入变化 | 通常保留原序列 | 选中位置被替换或扰动 |
| 预测目标 | 每个有效位置的下一个词元 | 只恢复被选中的词元 |
| 可见上下文 | 只能看左侧 | 通常可看左右两侧 |
| 常见用途 | 文本生成、续写、对话 | 表示学习、文本理解、预训练编码器 |
无论采用哪种目标,填充位置都不应参与损失。工程实现常把这些标签设为忽略值,例如 -100。掩码语言建模中,未被选中的普通词元通常也设为忽略值,而不是让模型复制全部输入。
因果掩码控制注意力可见范围;掩码词元是输入内容的一部分;填充掩码用于屏蔽批次对齐产生的无效位置。三者作用层级不同,不能互相替代。
本课总结
- 因果语言建模通过左侧上下文预测下一个词元,训练方式与自回归生成一致
- 掩码语言建模利用双向上下文恢复被选中的词元,只在指定位置计算损失
- 标签位移、有效监督位置和填充忽略规则共同决定实际训练信号
下一课预告
下一课将继续分析交叉熵损失,说明模型输出的词元概率如何与目标标签转换成一个可优化的标量。