
大模型原理与训练 / 系统课时
梯度与反向传播
梯度与反向传播
训练神经网络时,真正需要解决的问题是:损失函数发生变化后,每个参数应向哪个方向调整、调整多少。本课通过一个最小计算图说明梯度如何沿依赖关系反向传播,并把结果转化为一次可验证的参数更新。
学习目标
- 读懂计算图中的前向计算与反向依赖
- 使用链式法则计算参数梯度
- 解释梯度下降如何根据梯度更新参数
从损失函数追到参数
设模型只有一个线性计算:
损失函数采用平方误差:
前向传播按照“输入 → 预测值 → 损失”的顺序计算结果;反向传播则从损失出发,沿相反方向计算每个中间量和参数对损失的影响。
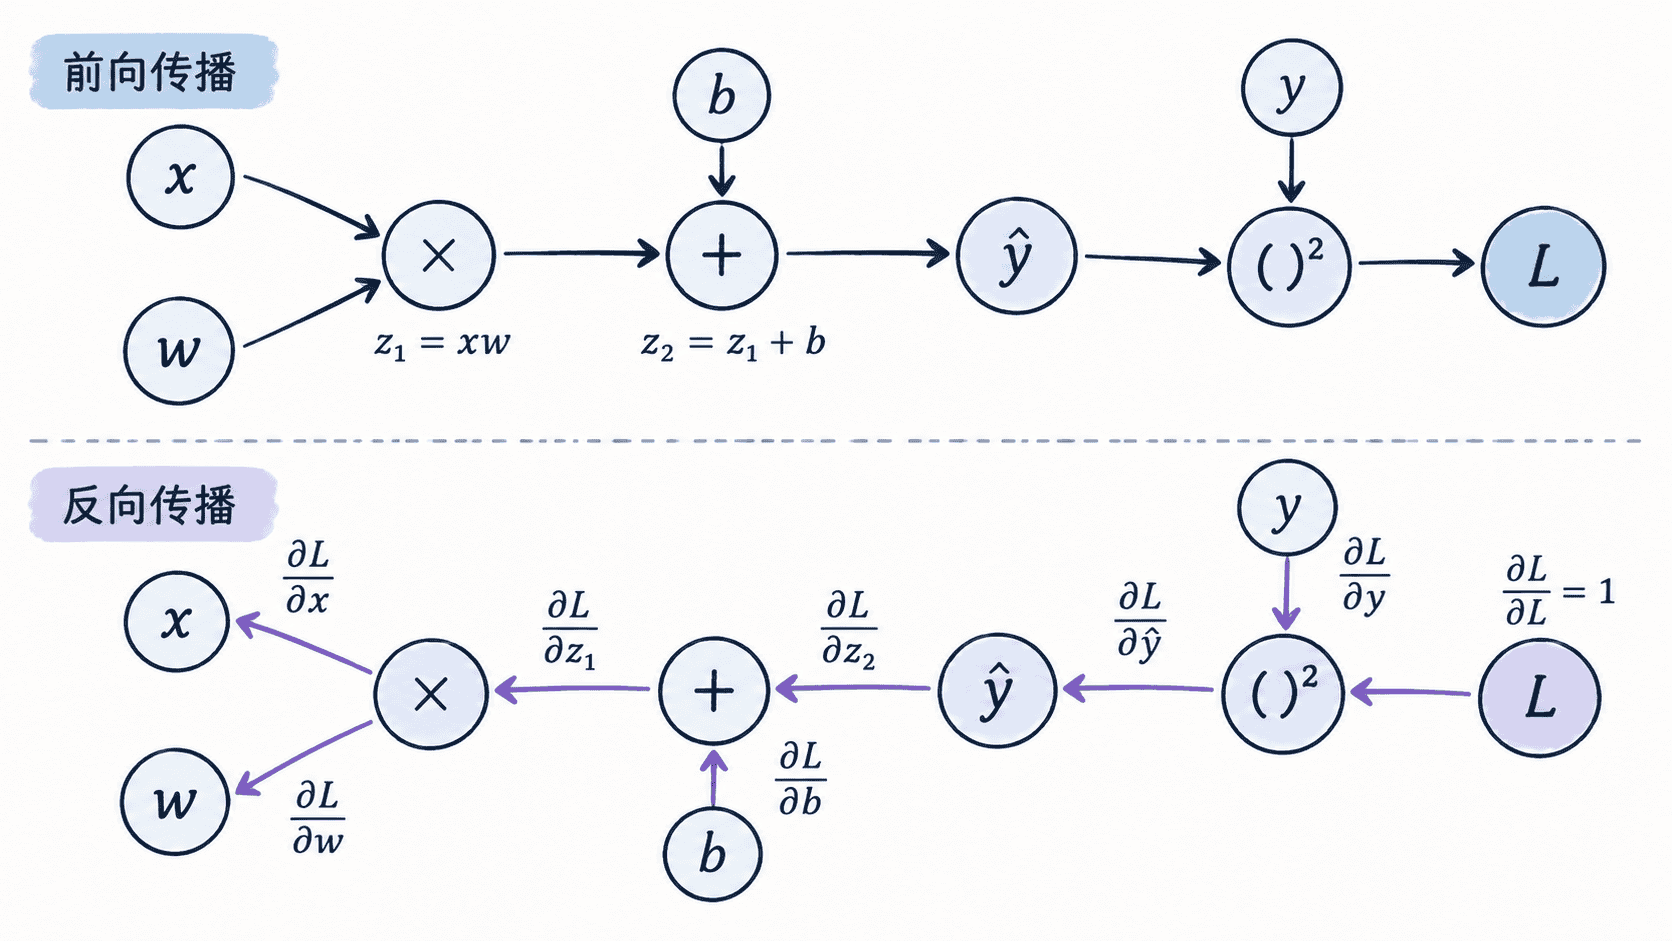
链式法则如何传递梯度
反向传播不是重新求一次完整函数,而是把复杂函数拆成多个局部运算。若变量 影响 ,而 又影响损失 ,则:
对本例先求预测值的梯度:
再继续传播到参数:
每个节点只需保存前向计算所需的值,并在反向阶段提供自己的局部导数。深层网络中的自动微分框架,本质上就是按计算图逆序执行这一过程。
用代码验证一次反向传播
下面的完整 Python 示例手工计算梯度,并执行一步梯度下降:
python
def main():
    x = 2.0
    y = 5.0
    w = 3.0
    b = 1.0
    learning_rate = 0.1

    # 前向传播:先得到预测值,再计算平方误差
    prediction = w * x + b
    loss = (prediction - y) ** 2

    # 反向传播:先求损失对预测值的梯度,再传到参数
    grad_prediction = 2 * (prediction - y)
    grad_w = grad_prediction * x
    grad_b = grad_prediction

    w -= learning_rate * grad_w
    b -= learning_rate * grad_b
    new_loss = (w * x + b - y) ** 2

    print(f"loss={loss:.1f}")
    print(f"grad_w={grad_w:.1f}, grad_b={grad_b:.1f}")
    print(f"updated_w={w:.1f}, updated_b={b:.1f}")
    print(f"new_loss={new_loss:.1f}")

if __name__ == "__main__":
    main()
预期输出:
text
loss=4.0
grad_w=8.0, grad_b=4.0
updated_w=2.2, updated_b=0.6
new_loss=0.0
结果表明,梯度为正时,梯度下降会减小参数;这一步更新恰好让预测值从 变为 。真实模型通常经过许多批次迭代,不会保证一步就把损失降到零。
梯度更新与常见问题
最基本的参数更新规则是:
其中 是学习率。学习率过大可能越过较优位置并导致损失震荡,过小则会使训练非常缓慢。Transformer 训练还会使用 AdamW、学习率预热和梯度裁剪,但它们都建立在正确梯度之上。
梯度消失表示梯度在多层连乘后接近零,前层参数几乎无法更新;梯度爆炸则表示梯度快速放大,使参数更新不稳定。残差连接、归一化和合理初始化,都是缓解这些问题的重要手段。
梯度表示当前位置最陡的上升方向;梯度下降使用其反方向更新参数。梯度大小不是参数重要性的绝对度量,它还受到输入尺度、损失缩放和网络结构影响。
本课总结
- 反向传播沿计算图逆序计算梯度,核心规则是链式法则
- 参数梯度由上游梯度与当前节点局部导数共同决定
- 优化器根据梯度更新参数,学习率决定每一步的调整幅度
下一课预告
下一课将学习残差连接与层归一化,理解它们如何改善深层网络中的信息传递和训练稳定性。
按自己的节奏,确认真正理解。