
大模型原理与训练 / 系统课时
归一化与残差连接
归一化与残差连接
Transformer 能堆叠许多层,关键不只是注意力机制本身,还在于残差连接保留原始信息、层归一化控制特征尺度。本课将拆解两者的计算方式,并比较 Pre-LN 与 Post-LN 的结构差异。
学习目标
- 解释残差连接为何有利于信息和梯度传播
- 理解层归一化的计算对象与作用
- 区分 Pre-LN、Post-LN 以及批归一化
残差连接保留直接通路
设某个子层的输入为 ,子层变换为 ,残差连接的输出是:
这条加法支路让输入可以绕过复杂变换直接到达后续层。即使 暂时学得不好,网络仍能保留 中的原始信息;反向传播时,梯度也能通过恒等路径直接传回前层。
对 求导可得到:
其中 表示恒等映射。公式中的 是残差结构有利于缓解梯度消失的关键,但它并不保证训练一定稳定,仍需配合归一化、初始化和合适的优化策略。
层归一化稳定单个样本
层归一化会对一个样本在特征维度上的数值进行标准化。对长度为 的向量 ,先计算均值与方差:
再进行归一化与仿射变换:
防止分母为零, 与 是可学习参数,使网络能够恢复或重新调整合适的特征尺度。LayerNorm 不依赖同一批次中的其他样本,因此适合序列长度变化和小批量训练。
Pre-LN 与 Post-LN
残差连接和层归一化的先后顺序会影响训练行为。原始 Transformer 常写成 Post-LN:
现代深层 Transformer 更常采用 Pre-LN:
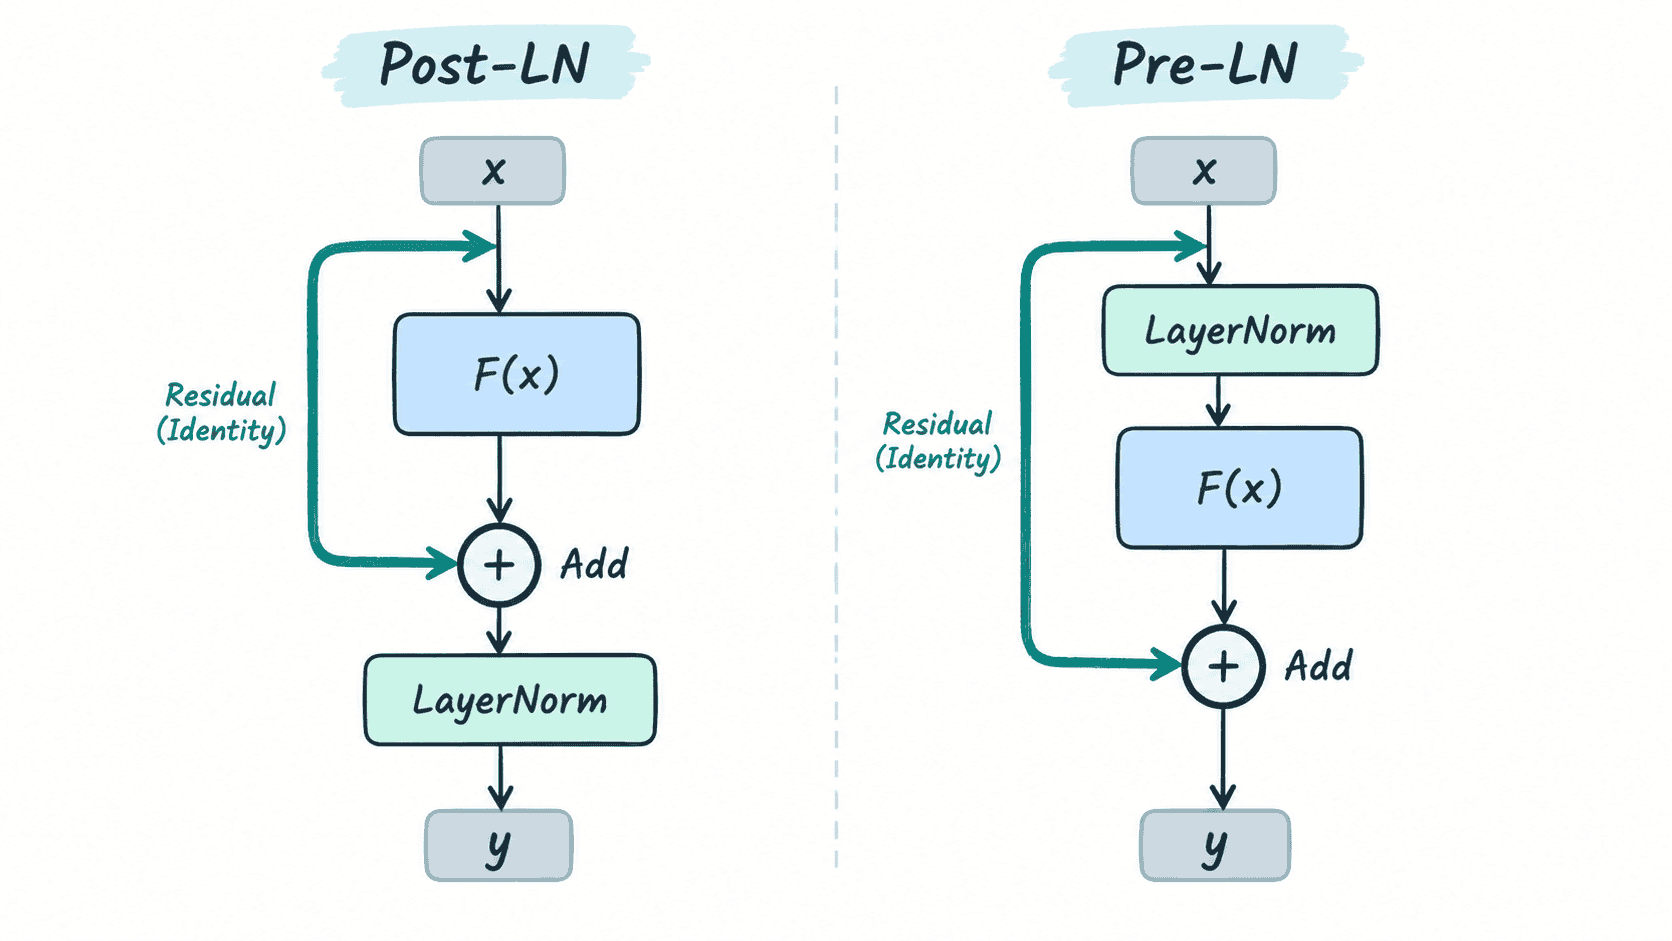
Pre-LN 中,残差主通路不经过归一化后再传向下一层,梯度路径通常更直接,深层模型更容易训练。Post-LN 会在相加后统一规范输出,但随着层数增加,往往对学习率预热和初始化更敏感。
两种结构都能工作,不能只凭名称判断优劣。阅读模型代码时,应确认归一化发生在子层之前还是残差相加之后。
用最小示例观察数值变化
下面用纯 Python 实现一次“残差相加后做层归一化”。为突出核心过程,示例令 、:
import math

def layer_norm(values, epsilon=1e-5):
    mean = sum(values) / len(values)
    variance = sum((value - mean) ** 2 for value in values) / len(values)
    scale = math.sqrt(variance + epsilon)
    return [(value - mean) / scale for value in values]

def main():
    x = [1.0, 2.0, 3.0, 4.0]
    sublayer_output = [0.5, -0.5, 1.0, -1.0]

    # 残差连接要求两个向量形状一致,才能逐元素相加
    residual = [a + b for a, b in zip(x, sublayer_output)]
    normalized = layer_norm(residual)

    print("residual:", residual)
    print("normalized:", [round(value, 4) for value in normalized])
    print("normalized_mean:", round(sum(normalized) / len(normalized), 4))

if __name__ == "__main__":
    main()
预期输出:
residual: [1.5, 1.5, 4.0, 3.0]
normalized: [-0.9428, -0.9428, 1.4142, 0.4714]
normalized_mean: 0.0
输出说明残差连接先融合原输入与子层结果,LayerNorm 再把该样本的特征重新中心化。实际模型还会学习 和 ,因此最终输出不一定保持均值为零、方差为一。
与 BatchNorm 的边界
BatchNorm 通常按批次统计某个通道的均值和方差,训练结果会受到批量大小与样本组成影响。LayerNorm 则在单个样本内部沿特征维度统计,训练和推理时使用同一种计算方式。
在 Transformer 中,张量常写作 [batch, sequence, hidden]。LayerNorm 通常只处理最后的 hidden 维;它不会把不同 token 或不同样本混在一起求均值。实际实现时还要确保残差两端形状一致,否则无法逐元素相加。
本课总结
- 残差连接通过恒等通路保留输入,并为梯度提供更直接的传播路径
- LayerNorm 在单个样本的特征维上归一化,降低数值尺度波动
- Pre-LN 与 Post-LN 的差异在于归一化和残差相加的先后顺序
下一课预告
下一课将进入 Transformer 的核心模块,分析自注意力如何根据查询、键和值动态聚合序列信息。