
大模型原理与训练 / 系统课时
模型导出
模型导出
模型导出的目标不是简单复制权重文件,而是把可执行推理逻辑、参数和输入输出契约转换为独立运行时能够加载的计算图。本课将完成一次 ONNX 导出与数值对齐验证,并说明动态形状和不支持算子的处理顺序。
学习目标
- 区分训练检查点、计算图和独立推理产物
- 完成模型导出、图结构检查与运行时加载验证
- 识别动态形状、控制流和算子兼容性带来的边界问题
导出产物包含什么
训练检查点通常保存参数和优化器状态,仍依赖原框架代码重建模型。计算图格式则记录算子、张量连接、常量权重以及输入输出名称,使推理引擎能够按图执行。PyTorch 当前推荐使用基于 torch.export 的 ONNX 导出路径,并通过 dynamo=True 捕获规范化计算图。:contentReference[oaicite:1]{index=1}
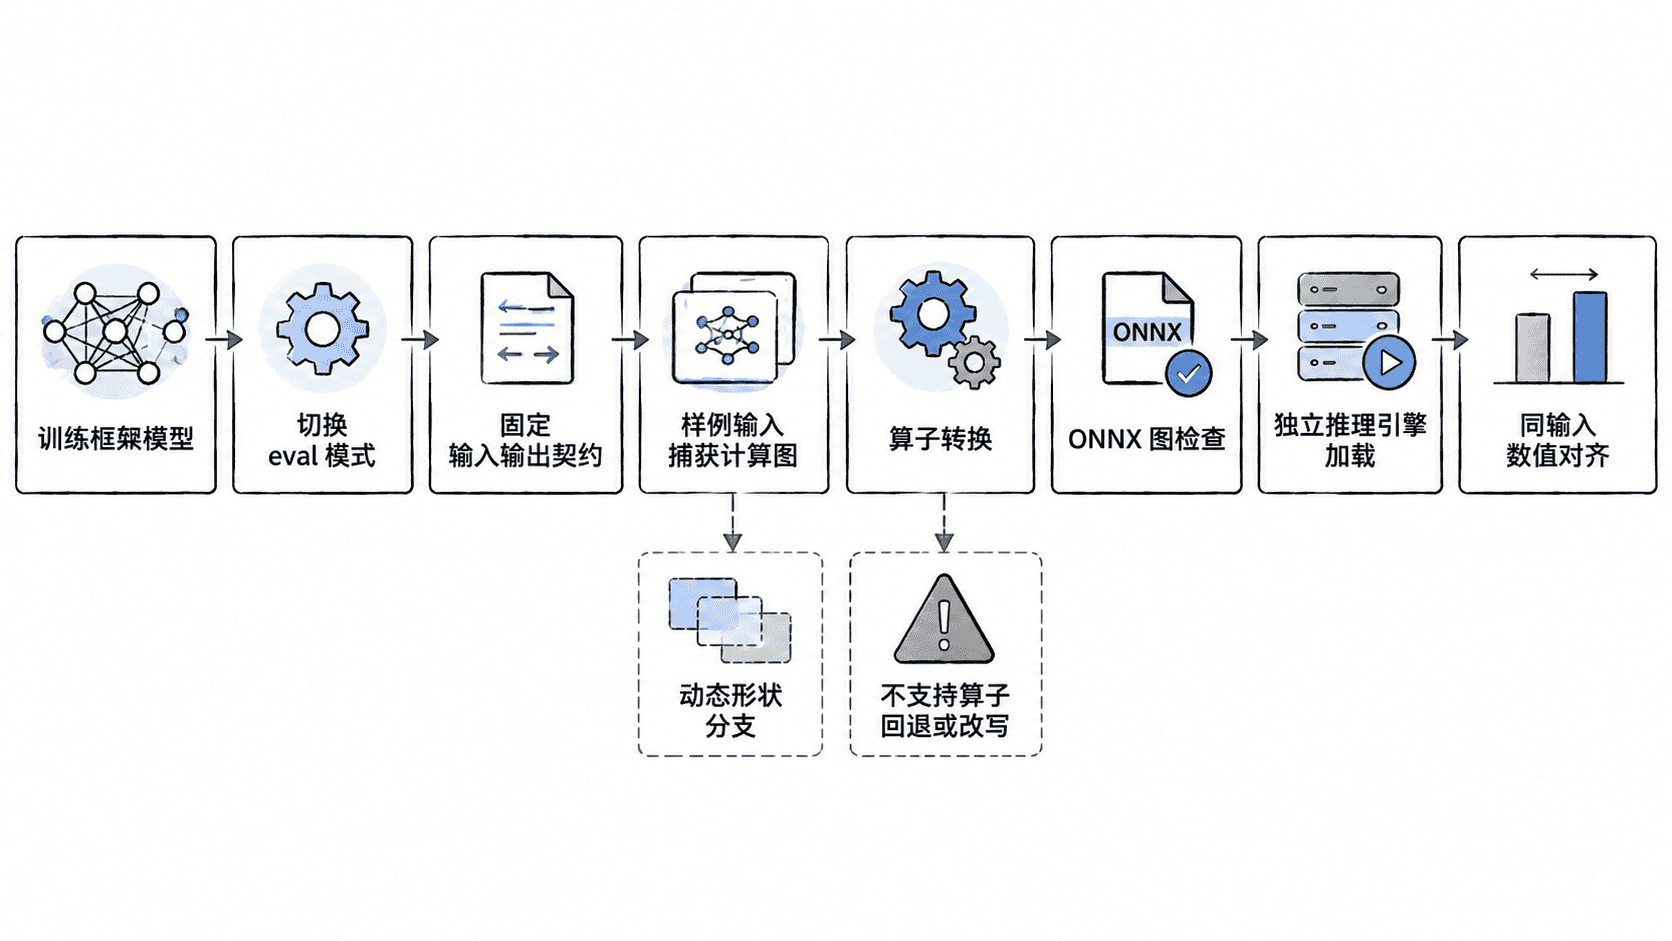
导出前必须调用推理模式并关闭随机行为,例如停用 Dropout。样例输入不仅提供数值,还决定图捕获时看到的参数类型、张量秩和形状约束,因此不能随意用与生产请求不同的占位输入。
先固定推理契约
导出失败常常不是模型本身有问题,而是契约没有提前定义。至少要明确以下内容:
| 契约项 | 需要固定的内容 | 验证方式 |
|---|---|---|
| 输入 | 名称、数据类型、张量维度、掩码含义 | 用真实预处理结果打印形状和类型 |
| 输出 | 名称、数量、维度与后处理语义 | 对同一输入比较框架与运行时输出 |
| 动态范围 | 批大小、序列长度是否可变 | 使用多组合法长度重新执行推理 |
| 数值容差 | 最大绝对误差或相对误差阈值 | 自动化断言而不是人工查看少量数字 |
| 运行时版本 | ONNX opset 与目标引擎支持范围 | 在部署镜像内加载并执行产物 |
固定形状最容易导出,但只能接受与样例一致的维度。需要可变批大小或序列长度时,应显式声明动态形状;PyTorch 文档也指出,默认会记录样例输入形状,动态输入需要通过 dynamic_shapes 配置。:contentReference[oaicite:2]{index=2}
主示例:导出并校验 ONNX
示例使用一个最小文本分类器聚焦导出流程。运行前需要安装兼容版本的 torch、onnx、onnxscript 和 onnxruntime。真实 Transformer 的步骤相同,只是计算图更大、算子兼容性检查更多。
import os

import numpy as np
import onnx
import onnxruntime as ort
import torch
from torch import nn

class TinyTextClassifier(nn.Module):
    def __init__(self, vocab_size: int = 32, hidden_size: int = 8) -> None:
        super().__init__()
        self.embedding = nn.Embedding(vocab_size, hidden_size)
        self.norm = nn.LayerNorm(hidden_size)
        self.classifier = nn.Linear(hidden_size, 2)

    def forward(
        self,
        input_ids: torch.Tensor,
        attention_mask: torch.Tensor,
    ) -> torch.Tensor:
        hidden = self.norm(self.embedding(input_ids))
        mask = attention_mask.unsqueeze(-1).to(hidden.dtype)

        # 掩码平均池化避免填充位置参与句向量计算。
        pooled = (hidden * mask).sum(dim=1) / mask.sum(dim=1).clamp_min(1.0)
        return self.classifier(pooled)

torch.manual_seed(7)
model = TinyTextClassifier().eval()
input_ids = torch.tensor([[2, 5, 9, 0]], dtype=torch.int64)
attention_mask = torch.tensor([[1, 1, 1, 0]], dtype=torch.int64)
output_path = "tiny_text_classifier.onnx"

with torch.no_grad():
    reference = model(input_ids, attention_mask).cpu().numpy()

# dynamo=True 使用当前推荐的 torch.export 基础导出路径。
torch.onnx.export(
    model,
    (input_ids, attention_mask),
    output_path,
    input_names=["input_ids", "attention_mask"],
    output_names=["logits"],
    opset_version=18,
    dynamo=True,
)

onnx_model = onnx.load(output_path)
onnx.checker.check_model(onnx_model)

session = ort.InferenceSession(
    output_path,
    providers=["CPUExecutionProvider"],
)
runtime_output = session.run(
    ["logits"],
    {
        "input_ids": input_ids.numpy(),
        "attention_mask": attention_mask.numpy(),
    },
)[0]

print(f"exported: {os.path.abspath(output_path)}")
print("input_names:", [item.name for item in session.get_inputs()])
print("output_names:", [item.name for item in session.get_outputs()])
print("output_shape:", list(runtime_output.shape))
print(f"max_abs_diff: {np.max(np.abs(reference - runtime_output)):.8f}")
预期输出
exported: <PATH>/tiny_text_classifier.onnx
input_names: ['input_ids', 'attention_mask']
output_names: ['logits']
output_shape: [1, 2]
max_abs_diff: <FLOAT>
<PATH> 取决于运行目录,<FLOAT> 取决于框架、导出器和运行时版本。验收时应为最大误差设置明确阈值;只要图能加载但输出偏差超限,仍应判定导出失败。
导出失败的定位顺序
先检查模型是否处于 eval() 模式,以及样例输入的数据类型、形状和设备是否正确。随后检查错误是否来自不支持算子、Python 数据结构、数据依赖控制流或自定义算子。不要一开始就关闭全部优化,否则会掩盖真正的不兼容位置。
若图能生成但运行时无法加载,应核对 opset、运行时版本和外部权重文件是否完整。若能够运行但结果不一致,应逐层缩小模型,比较中间张量,并重点检查掩码、归一化、整型除法、插值和精度转换。
动态形状与生产验收
声明动态批大小或序列长度后,至少使用最短、典型和上限长度各验证一次。动态并不意味着任意形状都合法,模型内部的整除关系、位置编码上限和缓存布局仍可能限制输入范围。
最终产物应在真实部署镜像中完成冷启动、首次推理、重复推理和并发压测。验收清单至少包含文件完整性、输入输出名称、数值容差、动态范围、峰值内存和目标硬件延迟,避免只在开发机上确认“导出成功”。
本课总结
- 模型导出把推理逻辑、权重和输入输出契约固化为独立运行时可执行的计算图
- 导出完成后必须同时执行图结构检查、目标运行时加载和同输入数值对齐
- 动态形状、不支持算子与版本兼容性应在部署镜像内用多组真实输入验证
下一课预告
下一课将继续围绕推理部署,分析批处理、缓存和并发调度如何影响 Transformer 服务的吞吐与延迟。