
大模型原理与训练 / 系统课时
词元嵌入
词元嵌入
词元编号只是离散标签,本身没有大小、方向或相似度。词元嵌入通过一次矩阵查表,把每个编号转换成可训练的连续向量,使 Transformer 能够在统一的向量空间中处理文本。
学习目标
- 理解嵌入矩阵的形状和查表过程
- 说明词元向量如何通过训练被更新
- 区分输入嵌入与经过 Transformer 后的上下文表示
从编号到连续向量
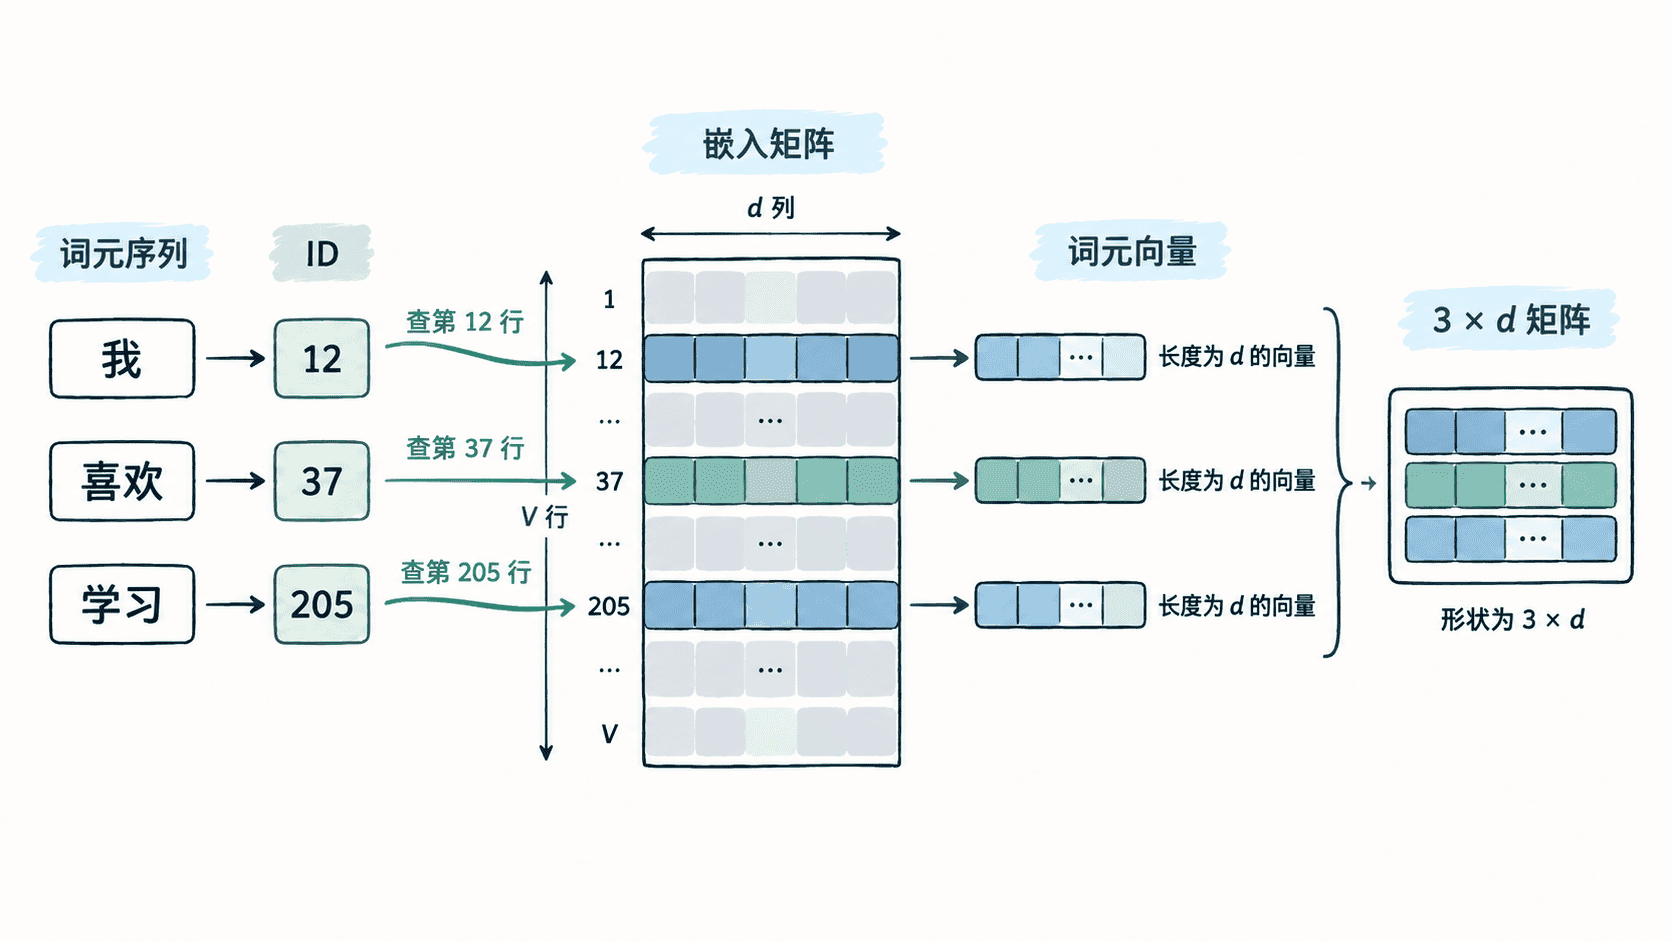
假设词表大小为 ,嵌入维度为 ,模型会维护一个矩阵 ,其形状为 。矩阵的每一行对应一个词元编号,因此编号 的嵌入就是:
这里不是用编号做数值计算,而是把编号当作行索引。编号 100 不表示它比编号 20 更大或更重要,它们只是指向嵌入矩阵中的不同位置。
查表后的形状
若一个样本包含 个词元,输入 ID 的形状可以写成 ,查表后就得到 的向量矩阵。批量输入包含 个样本时,常见输出形状为 。
例如,三个词元编号分别查到三行向量:
| 词元 ID | 嵌入向量示意 |
|---|---|
| 12 | |
| 37 | |
| 205 |
这些数值在训练开始时通常是随机初始化的。它们没有人工规定的含义,语义关系来自后续训练目标不断调整。
嵌入为什么能够学习
嵌入矩阵是模型参数的一部分。前向计算使用某些词元对应的行,损失反向传播时,梯度会更新这些被访问的向量,使它们逐渐更适合预测、分类或生成任务。
同一个词元编号在输入层总是查到同一行,因此初始词元嵌入是静态的。不过,相同词元进入不同句子后,会与其他词元发生注意力交互,最终形成不同的上下文表示。
与上下文表示的区别
输入嵌入回答的是“这个词元从哪个起点进入模型”。Transformer 层输出回答的是“这个词元在当前上下文中表示什么”。例如“苹果手机”和“吃苹果”中的“苹果”可以拥有相同的输入嵌入,但经过上下文计算后得到不同向量。
实际模型还可能把词元嵌入与位置嵌入、片段嵌入相加。相加后的结果才作为 Transformer 第一层的输入,因此嵌入层不仅承载词元身份,也为顺序和句段信息提供入口。
参数量与设计取舍
词元嵌入的参数量约为 。扩大词表可以减少拆分长度,但会增加矩阵行数;提高嵌入维度可以提供更大的表示空间,但也会增加参数量、显存占用和计算成本。
一些语言模型会让输入嵌入矩阵与输出预测矩阵共享权重,以减少参数并强化输入、输出词表之间的对应关系。这种做法称为权重绑定,但是否采用取决于具体模型结构。
本课总结
- 词元嵌入本质上是按词元 ID 从 矩阵中查找对应行
- 嵌入向量是可训练参数,其语义来自损失函数驱动的梯度更新
- 输入嵌入是固定起点,上下文表示则会随句子环境发生变化
下一课预告
下一课将继续补充位置信息,理解为什么只靠词元嵌入还无法让 Transformer 区分词序。