
大模型原理与训练 / 系统课时
注意力分数计算
注意力分数计算
得到 Query 和 Key 后,下一步是计算每个词元对其他位置的相关性。本课将从单个点积扩展到完整分数矩阵,并通过形状推导确认每一行、每一列和每个元素的准确含义。
学习目标
- 理解 Query 与 Key 点积为何能表示匹配程度
- 推导注意力分数矩阵的形状与元素含义
- 能用一个小型数值示例验证矩阵计算结果
从单个点积到分数矩阵
设第 个词元的查询向量为 ,第 个词元的键向量为 ,两者的原始注意力分数为:
点积会把两个同维向量压缩成一个标量。方向越一致,结果通常越大,表示第 个位置更关注第 个位置;结果较小或为负,则表示匹配程度较弱。这个分数此时还不是概率,只是归一化前的相似度。
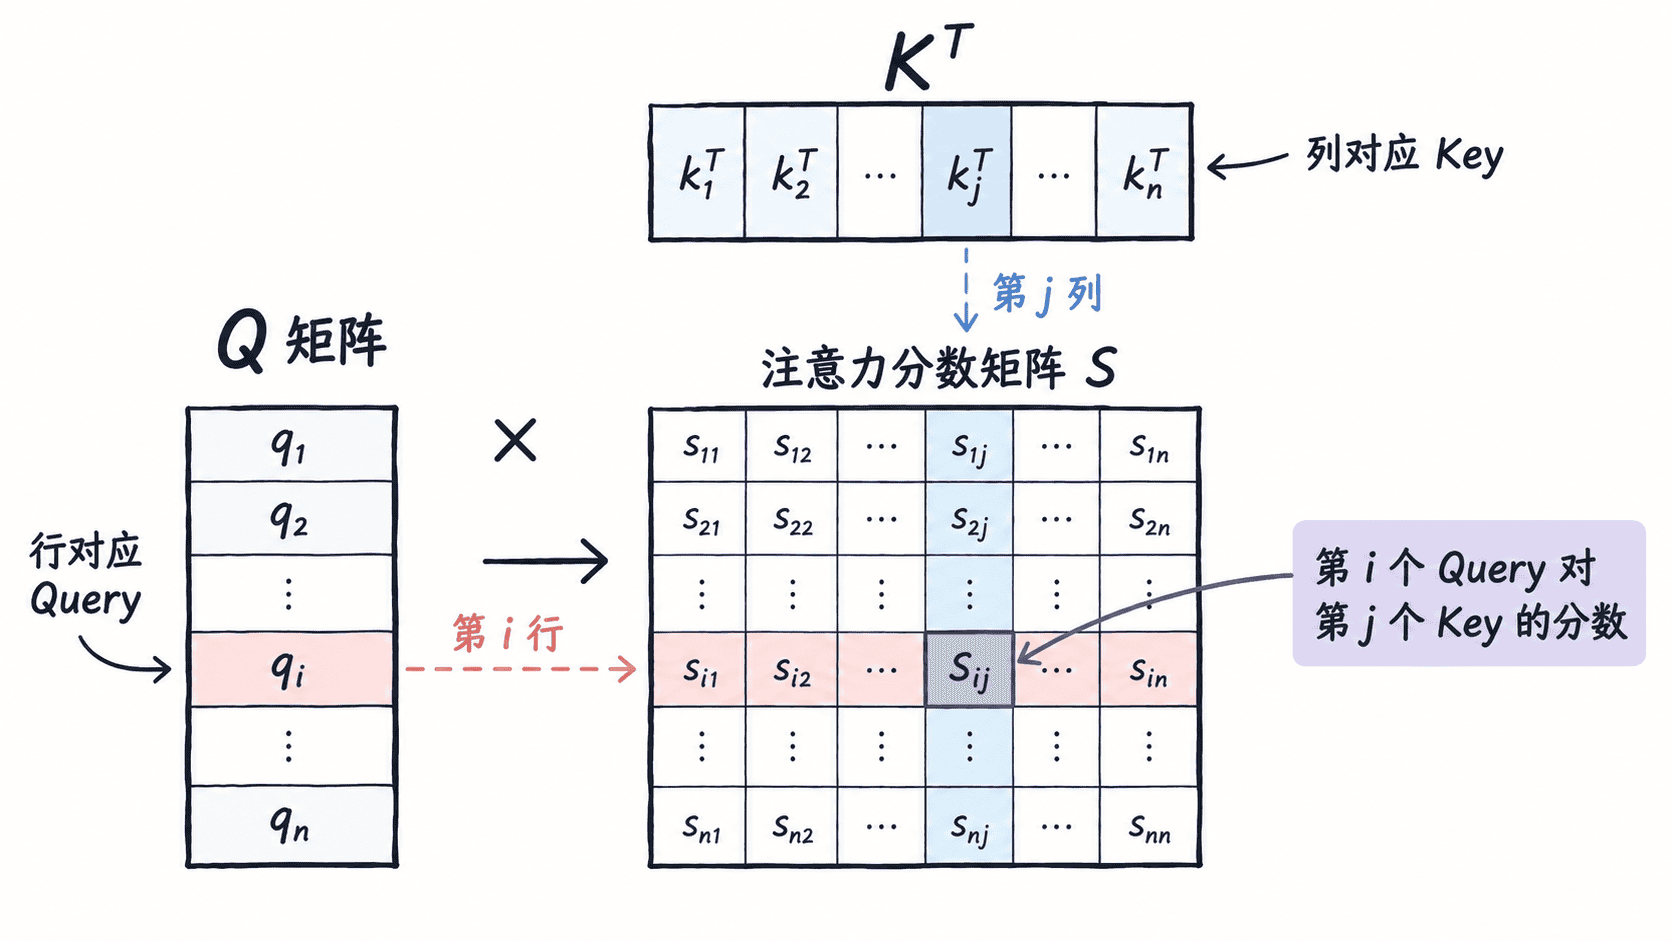
若 和 的形状都是 ,需要让每个 Query 与每个 Key 都计算一次点积。把 转置后即可批量计算:
矩阵形状推导为:
因此, 的行数和列数都等于序列长度。第 行表示第 个 Query 对所有 Key 的分数,第 列表示所有 Query 对第 个 Key 的分数,元素 就是 与 的点积。
数值示例与验证
下面使用 3 个词元、每个向量 2 维的例子。代码直接计算 ,便于核对每个分数来自哪一组点积。
import numpy as np

Q = np.array([
    [1.0, 0.0],
    [0.0, 1.0],
    [1.0, 1.0],
])

K = np.array([
    [1.0, 0.0],
    [1.0, 1.0],
    [0.0, 1.0],
])

# K.T 把每个 Key 放到列方向,使所有 Query 可一次完成点积
scores = Q @ K.T

print(scores)
print(scores.shape)
预期输出
[[1. 1. 0.]
 [0. 1. 1.]
 [1. 2. 1.]]
(3, 3)
例如第二行第三列等于 1,因为 与 的点积为 1。第三行第二列等于 2,因为 。输出形状为 ,对应 3 个 Query 分别与 3 个 Key 比较。
缩放与计算边界
当 较大时,点积的绝对值往往随维度增大。过大的分数进入 Softmax 后容易让分布过于尖锐,使梯度变小。缩放点积注意力因此使用:
缩放不会改变矩阵形状,也不会改变元素的行列含义,只是控制数值范围。当前阶段得到的仍是未归一化分数,后续还需要结合掩码并执行 Softmax,才能成为可用于加权 Value 的注意力权重。
计算时不能直接使用 。当二者形状同为 时,通常无法相乘;即使特殊维度碰巧可乘,结果也不是“每个 Query 对每个 Key”的分数矩阵。左侧 决定结果的行,右侧 决定结果的列,因此 表示第 个 Query 对第 个 Key。
本课总结
- 单个注意力分数是 Query 与 Key 的点积,表示两者的匹配程度
- 会生成 分数矩阵,每行对应一个 Query
- 除以 只调整数值尺度,不改变矩阵结构
下一课预告
下一课将把分数矩阵经过缩放、掩码和 Softmax 转换为注意力权重,并解释权重如何作用于 Value。