
大模型原理与训练 / 系统课时
生成异常排查
生成异常排查
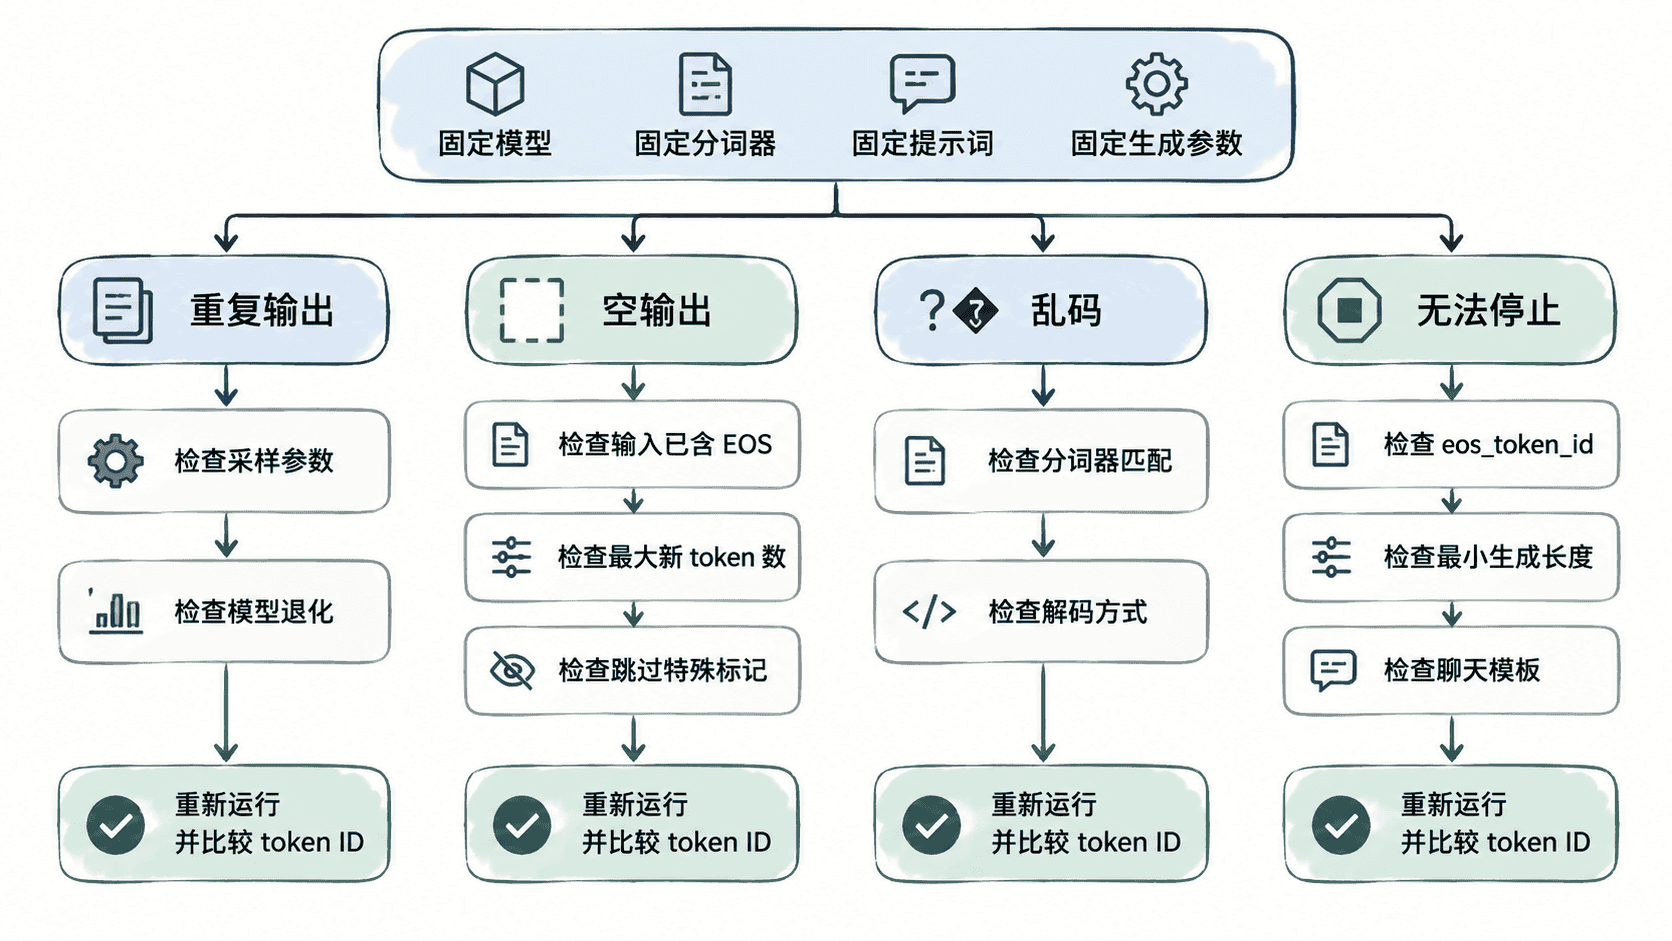
模型能够完成前向计算,不代表生成链路一定正确。本课针对重复输出、空输出、乱码和无法停止四类常见异常,建立从固定输入、检查分词器与特殊标记,到调整解码参数和停止条件的定位方法。
学习目标
- 为生成问题建立可重复的最小测试条件
- 根据异常现象定位提示词、分词器、解码参数或停止条件
- 使用诊断脚本核对输入长度、生成 token 和特殊标记配置
先固定最小可复现条件
排查前先固定模型目录、分词器目录、提示词、随机种子和全部生成参数。不要一边修改提示词,一边修改采样策略,否则即使结果恢复正常,也无法确认真正生效的改动。
对于聊天模型,还要固定聊天模板。训练时使用了角色标记而推理时直接拼接纯文本,可能造成空输出、答非所问或重复角色标签。优先使用分词器提供的 apply_chat_template,并确认是否需要附加生成提示。
同一模型应只配套使用它自己的分词器和词表文件。模型权重与分词器版本不一致时,token ID 会映射到错误文本,乱码、异常符号和停止标记失效都可能同时出现。
使用诊断脚本观察 token 级结果
下面的脚本从本地模型目录加载模型和分词器,使用确定性解码,并同时打印特殊标记、输入长度、生成长度和生成文本。运行前把环境变量 MODEL_PATH 指向实际目录;脚本要求已安装与模型兼容的 PyTorch 和 Transformers。
import os
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_path = os.environ.get("MODEL_PATH")
if not model_path:
    raise SystemExit("请先设置 MODEL_PATH=<PATH>")

prompt = os.environ.get("PROMPT", "请用一句话解释注意力机制。")
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

tokenizer = AutoTokenizer.from_pretrained(
    model_path,
    local_files_only=True,
)
model = AutoModelForCausalLM.from_pretrained(
    model_path,
    torch_dtype="auto",
    local_files_only=True,
).to(device)
model.eval()

eos_id = tokenizer.eos_token_id
if eos_id is None:
    raise RuntimeError("分词器未定义 eos_token_id")

pad_id = tokenizer.pad_token_id
if pad_id is None:
    pad_id = eos_id

inputs = tokenizer(prompt, return_tensors="pt")
inputs = {name: value.to(device) for name, value in inputs.items()}

# 先关闭采样,避免随机性干扰定位
with torch.inference_mode():
    output_ids = model.generate(
        **inputs,
        max_new_tokens=64,
        do_sample=False,
        repetition_penalty=1.1,
        no_repeat_ngram_size=3,
        eos_token_id=eos_id,
        pad_token_id=pad_id,
    )

input_length = inputs["input_ids"].shape[1]
new_token_ids = output_ids[0, input_length:]
text = tokenizer.decode(new_token_ids, skip_special_tokens=True)

print(f"eos_token_id={eos_id}, pad_token_id={pad_id}")
print(f"input_tokens={input_length}, generated_tokens={new_token_ids.numel()}")
print(f"generated_ids={new_token_ids.tolist()}")
print(f"text={text!r}")
运行命令:
MODEL_PATH=<PATH> python diagnose_generation.py预期输出结构如下,实际 token ID、长度和文本由模型决定:
eos_token_id=<ID>, pad_token_id=<ID>
input_tokens=<N>, generated_tokens=<N>
generated_ids=[<ID>, <ID>, ...]
text='<GENERATED_TEXT>'
若 generated_tokens 大于 0 而 text 为空,通常说明生成结果全部是被 skip_special_tokens=True 移除的特殊标记。此时应临时改为不跳过特殊标记,查看模型到底生成了什么,而不是直接认定模型没有输出。
按异常现象定位根因
重复输出
先把 do_sample 设为 False,确认重复是否仍然存在。确定性解码仍严重重复,可能是模型微调数据重复、训练退化或提示词模板错误;只有采样时重复,则优先调整 temperature、top_p、repetition_penalty 和 no_repeat_ngram_size。
惩罚参数不是越大越好。过高的重复惩罚会破坏专有名词、代码和必要复述,甚至造成不自然跳词。应先用轻度惩罚稳定复现,再回到验证集评估内容质量。
空输出
检查 max_new_tokens 是否为 0,输入末尾是否已经带有 EOS,以及聊天模板是否把“助手开始回答”的提示补齐。还要区分“模型没有生成”和“解码后看不见”:直接打印新生成 token ID,并分别使用 skip_special_tokens=True 和 False 解码即可判断。
若输入长度已经达到模型上下文上限,框架可能截断提示词或没有剩余生成空间。应打印输入 token 数,并用 max_new_tokens 控制新增长度,不要混淆 max_length 的总长度语义。
乱码
乱码首先检查模型权重、分词器、词表和特殊标记配置是否来自同一版本。若使用字节级分词器,还应让分词器统一完成解码,不要自行把 token ID 转成字符或对中间字节重复执行 UTF-8 解码。
若只有流式输出乱码,可能是多字节字符被分块拆开。流式实现应按 token 或完整字节序列增量解码,并保留未完成字符的缓冲区,而不是把每个网络分片单独转成字符串。
无法停止
确认模型配置和分词器中的 eos_token_id 一致,并将它显式传入 generate。如果聊天模型使用多个结束标记,应按模型文档传入允许的结束 token 列表。min_new_tokens 过大也会强制模型忽略提前出现的 EOS,表现为明明已经回答完仍继续生成。
最后检查自定义停止词。字符串停止条件必须考虑分词后可能由多个 token 组成,简单比较最后一个 token 往往无效;同时要防止停止词出现在提示词中时被误判为新生成内容。
恢复采样时逐项放开参数
诊断阶段应从确定性解码开始。确认模型、分词器、聊天模板和停止条件正确后,再逐项恢复采样参数。每次只改一个变量,并保留生成文本、token ID、输入长度和完整参数,才能判断变化来自哪里。
一个稳妥的恢复顺序是:先启用 do_sample=True,再设置中等 temperature,随后加入 top_p,最后根据重复情况微调惩罚参数。不要同时叠加温度、Top-K、Top-P、束搜索和多个重复惩罚,否则输出变化难以解释。
修复后的验收标准
同一组提示词至少覆盖短文本、长文本、包含特殊符号的文本和接近上下文上限的文本。验收时不仅看“能生成”,还要确认输出可解码、能在预期结束标记处停止,并且多次运行的随机性符合所选策略。
若问题来自微调数据或模型退化,调整解码参数只能缓解表象。此时应回查训练样本中的重复模式、结束标记、聊天模板和标签遮罩,确认模型在训练阶段学到的是正确的回答边界。
本课总结
- 生成异常应先固定模型、分词器、模板、提示词和参数,再从 token 级结果定位
- 重复、空输出、乱码和无法停止分别对应不同检查路径,不能只靠统一调高或调低采样参数
- 解码参数只能修正推理策略,训练数据或模板错误仍需回到训练链路处理
下一课预告
下一课将把训练显存和生成异常的排查方法整理为可复用的上线前检查清单,并通过固定输入与指标记录减少重复试错。