
大模型原理与训练 / 系统课时
模型量化
模型量化
模型量化不是简单地把文件压小,而是用更少的比特表示权重或激活,并在可接受的精度损失内换取更低显存、更小带宽压力与更快推理。本课将用一个可运行示例说明量化公式、收益边界和部署验收方法。
学习目标
- 说明缩放因子、零点和反量化在低比特表示中的作用
- 比较 FP16、INT8、INT4 对大小、显存、速度和精度的影响
- 建立包含质量、延迟、内存与产物大小的量化验收流程
量化实际改变了什么
浮点权重可以取大量连续数值,而低比特整数只能表示有限区间。量化因此需要先确定缩放因子 和零点 ,再把浮点值映射为整数:
推理时可用 近似恢复原值。 与 的差就是量化误差;位宽越低,可表示的离散点越少,误差风险通常越高。
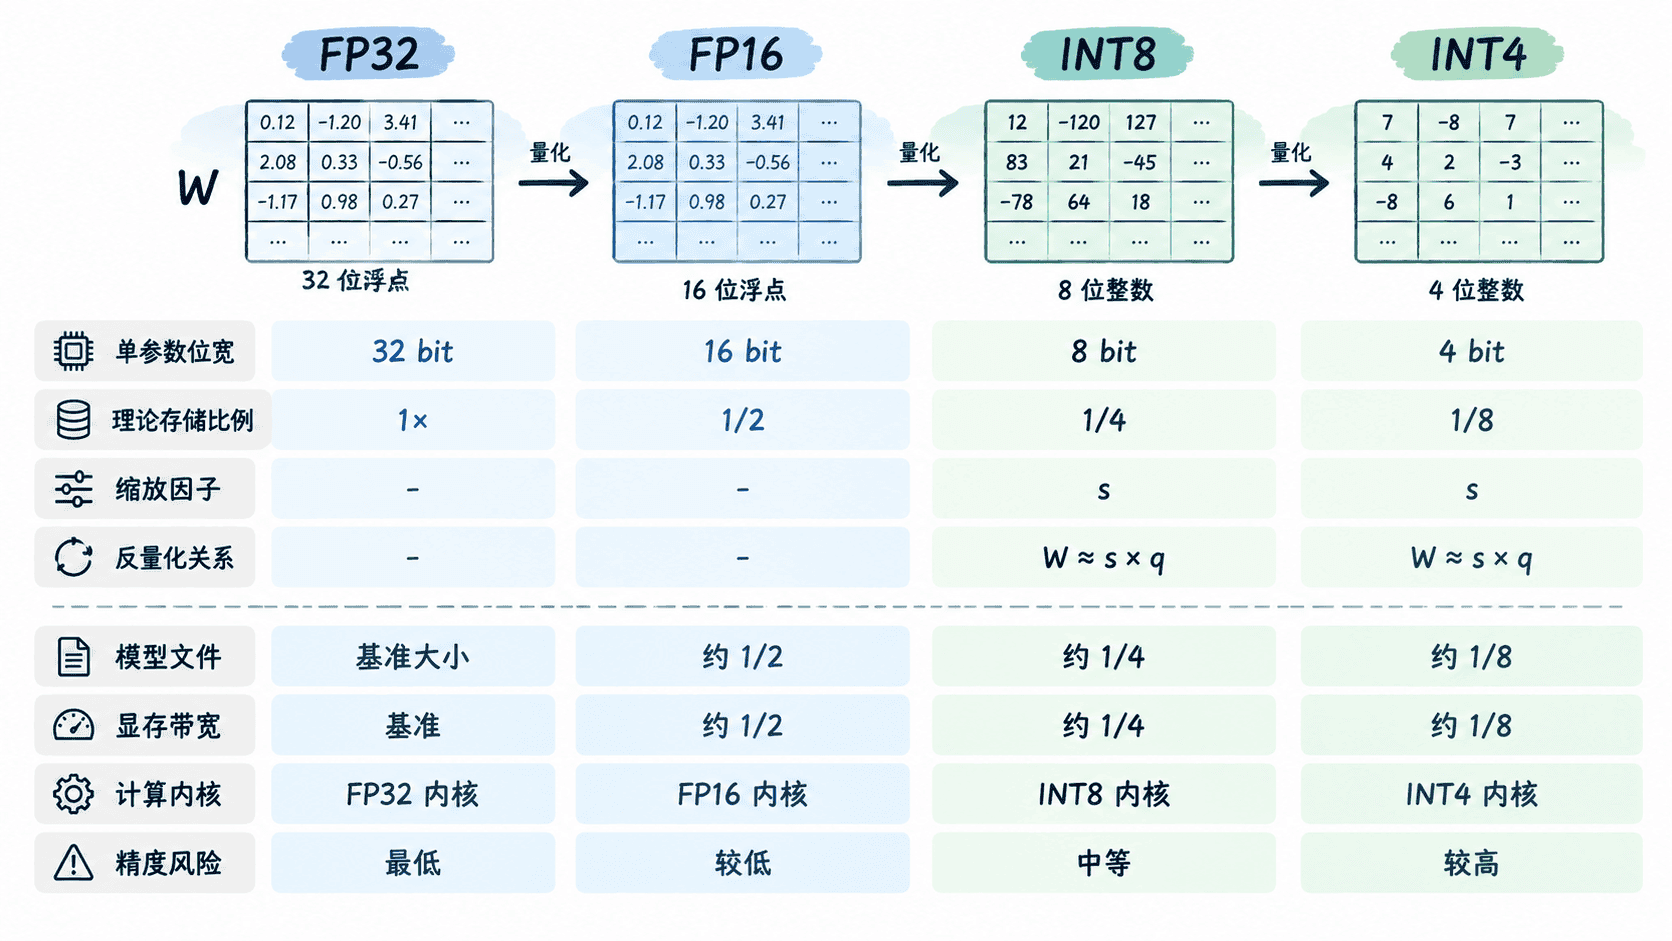
对称量化通常让零点为 0,便于矩阵乘法实现;非对称量化允许整数区间更贴合偏移后的数据分布。实际模型还会按整张量、按通道或按分组保存不同缩放因子,以减小局部极值造成的精度损失。
四个指标必须一起评估
| 指标 | 可能收益 | 不能直接下结论的原因 |
|---|---|---|
| 模型大小 | FP32 改为 INT8 时,权重理论存储约降至四分之一 | 产物还包含缩放因子、元数据、对齐填充和未量化层 |
| 峰值显存 | 权重常驻空间和内存带宽压力下降 | KV Cache、激活和运行时工作区可能仍占主要部分 |
| 推理速度 | 支持低比特内核时,矩阵计算和访存可能更快 | 硬件、批大小、序列长度与算子融合都会改变结果 |
| 任务精度 | 合理校准后可能只出现轻微下降 | 异常值、敏感层和校准样本偏差会放大误差 |
因此,“文件变小”只能证明压缩生效,不能证明服务更快。量化后的模型必须在目标硬件、真实批大小和典型序列长度下重新压测。
选择合适的量化路径
训练后量化先使用已有模型完成转换,成本最低。权重量化只压缩线性层权重,适合大模型快速落地;动态量化在运行时确定激活范围;静态量化则用代表性数据预先校准激活范围。PyTorch 的动态量化接口会把指定模块替换为动态权重量化版本,而当前量化开发正逐步集中到 torchao,工程选型应以实际框架版本文档为准。:contentReference[oaicite:0]{index=0}
当训练后量化无法满足精度要求时,可采用量化感知训练,让模型在训练阶段模拟舍入和截断误差。它通常需要更多训练成本,但能让参数主动适应低比特表示。
主示例:模拟对称 INT8 量化
下面使用 NumPy 把一组浮点权重映射到 。示例同时执行反量化并计算平均绝对误差,便于观察“压缩表示”和“数值恢复”的关系。
import numpy as np

weights = np.array([-1.0, -0.25, 0.0, 0.5, 1.2], dtype=np.float32)

# 对称 INT8 量化使用绝对值最大值确定缩放因子,零点固定为 0。
scale = float(np.max(np.abs(weights)) / 127)
quantized = np.clip(
    np.round(weights / scale),
    -127,
    127,
).astype(np.int8)

# 反量化只恢复近似值,用于评估量化误差。
restored = quantized.astype(np.float32) * scale
mae = float(np.mean(np.abs(weights - restored)))

print(f"scale: {scale:.6f}")
print("quantized:", quantized.tolist())
print("restored:", np.round(restored, 4).tolist())
print(f"mae: {mae:.6f}")
预期输出
scale: 0.009449
quantized: [-106, -26, 0, 53, 127]
restored: [-1.0016, -0.2457, 0.0, 0.5008, 1.2]
mae: 0.001339
这个例子只有一个缩放因子,属于按张量量化。真实 Transformer 常对不同通道或分组分别计算缩放因子,以避免少量异常值把整个张量的有效精度拉低。
部署验收与常见错误
先保存未量化基线,再固定同一批评测样本、预处理逻辑和生成参数。量化后至少比较任务指标、首 Token 延迟、后续 Token 吞吐、P50/P95 延迟、峰值显存和产物大小;任何一项异常都应能回退到基线模型。
常见错误包括只看模型文件大小、用少量随机文本做校准、在不同硬件上比较速度,以及把所有层强制设为同一位宽。更稳妥的做法是保留输入输出层、归一化层或异常值明显的层为较高精度,再逐层定位精度下降来源。
本课总结
- 量化通过缩放、舍入和截断把连续浮点值映射为有限整数,并引入可测量的近似误差
- 低位宽能减少权重存储与带宽压力,但实际加速取决于硬件内核、运行时和负载形态
- 量化验收必须同时覆盖质量、延迟、吞吐、峰值内存和部署产物大小
下一课预告
下一课将把训练框架中的模型转换为独立推理引擎可读取的计算图,并验证导出前后输出是否一致。