
大模型原理与训练 / 系统课时
多查询与分组查询注意力
多查询与分组查询注意力
本课解决一个直接影响大模型推理速度的问题:查询头很多时,是否必须为每个头都保存独立的键和值。你将比较 MHA、MQA 与 GQA 的头部组织方式,并能根据 KV Cache 占用和效果需求选择方案。
学习目标
- 说明 MHA、MQA、GQA 在查询头与键值头数量上的差异
- 计算三种结构的单层 KV Cache 占用
- 理解减少键值头为何主要改善推理带宽与并发能力
三种结构真正改变了什么
注意力仍然使用查询 与键 计算权重,再对值 加权求和。三种结构的核心区别不是查询头数量,而是键值头是否共享。
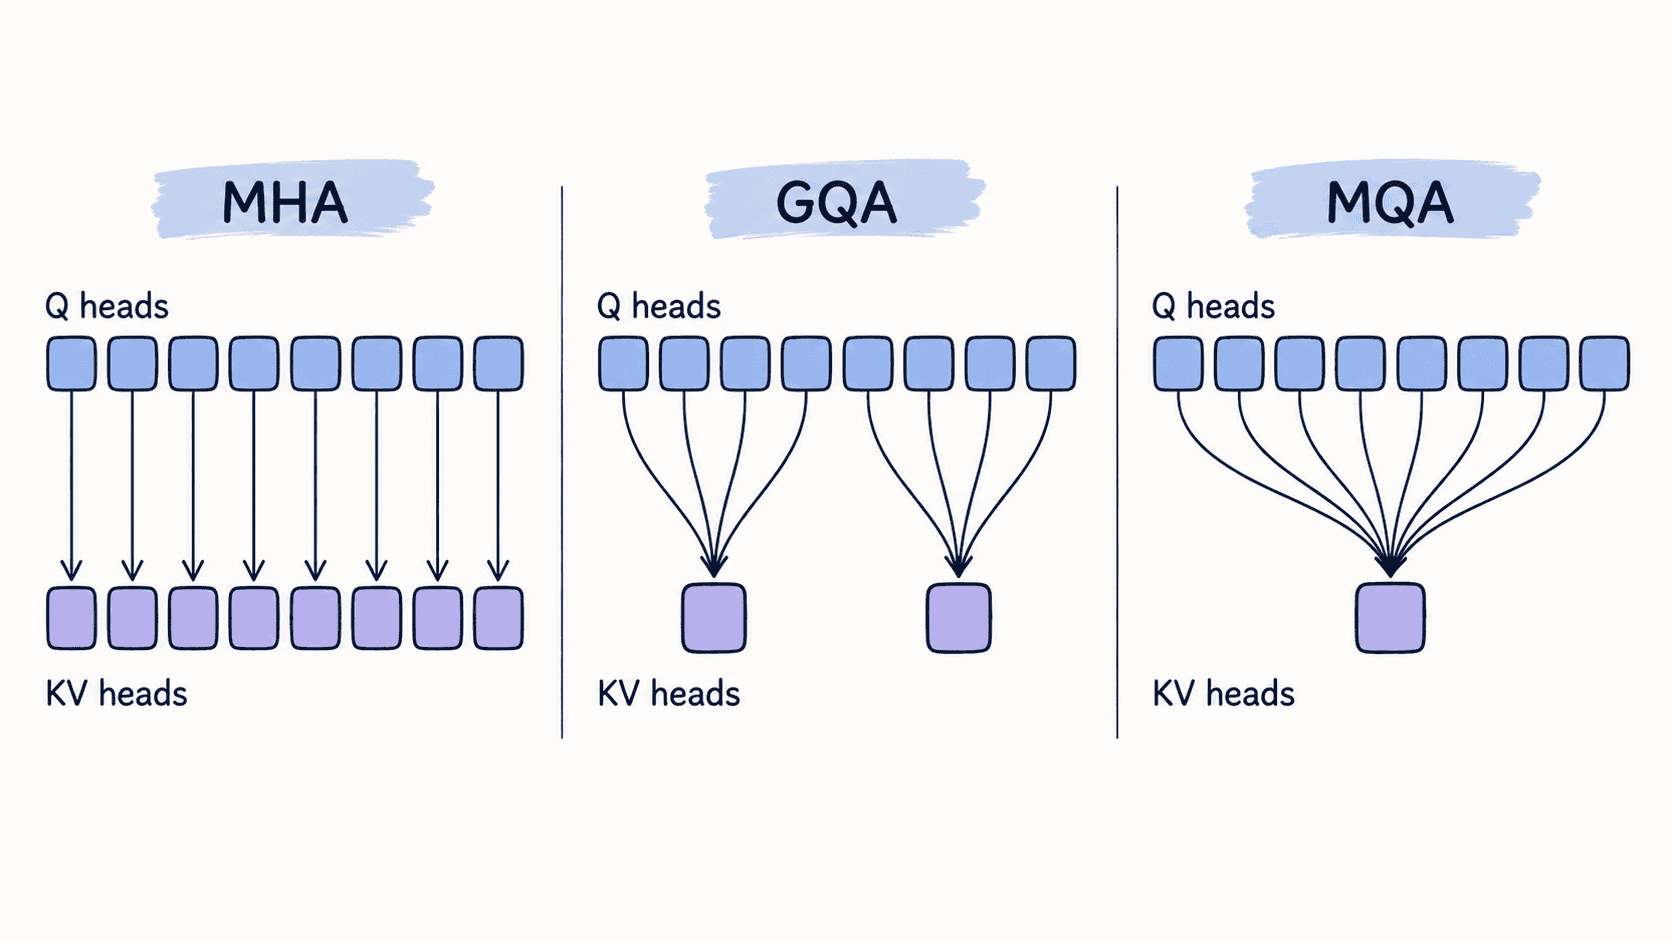
MHA 中,查询头数与键值头数相同,每个查询头拥有独立的 、。表达能力最充分,但缓存最大。MQA 只保留一组键值头,所有查询头共享同一份 、,缓存最小。GQA 将多个查询头分成若干组,同组查询头共享一组键值头,在质量与成本之间折中。
当查询头数为 、键值头数为 时,必须满足 能被 整除。每组包含的查询头数为 。
KV Cache 为什么差异明显
自回归生成会缓存历史 token 的键和值,避免每一步重复计算。若批量大小为 、已缓存长度为 、每个头维度为 ,单层缓存元素数为:
系数 2 分别对应键和值。只要查询头数不变,缓存大小就与键值头数 成正比。以 32 个查询头为例,GQA 使用 8 个键值头时,缓存约为 MHA 的四分之一;MQA 只有 1 个键值头时,约为三十二分之一。
这种节省主要降低显存占用和读取 KV Cache 的带宽压力,因此在长上下文、较大批量和高并发解码中尤其明显。训练阶段仍需处理完整序列,收益通常没有逐 token 推理那么突出。
用代码比较缓存占用
下面的 Python 程序计算 fp16 条件下,单层 KV Cache 的理论占用。示例固定查询头数为 32,只改变键值头数。
def kv_cache_mib(
    batch_size: int,
    sequence_length: int,
    query_heads: int,
    kv_heads: int,
    head_dim: int,
    bytes_per_element: int = 2,
) -> float:
    if query_heads % kv_heads != 0:
        raise ValueError("query_heads 必须能被 kv_heads 整除")

    # K 和 V 各保存一份,因此元素数量乘以 2。
    total_bytes = (
        2
        * batch_size
        * sequence_length
        * kv_heads
        * head_dim
        * bytes_per_element
    )
    return total_bytes / (1024 ** 2)

def main() -> None:
    configs = {
        "MHA": 32,
        "GQA": 8,
        "MQA": 1,
    }

    for name, kv_heads in configs.items():
        size = kv_cache_mib(
            batch_size=1,
            sequence_length=4096,
            query_heads=32,
            kv_heads=kv_heads,
            head_dim=128,
        )
        print(f"{name}: {size:.1f} MiB")

if __name__ == "__main__":
    main()
预期输出:
MHA: 64.0 MiB
GQA: 16.0 MiB
MQA: 2.0 MiB
这里计算的是单层、单批次且不包含其他激活和框架开销的理论值。实际模型还要乘以层数,并考虑缓存布局、量化格式和内存对齐。
如何选择并避免误判
追求最高质量且显存充足时,可以使用 MHA。服务长上下文或高并发模型时,GQA 往往是更稳妥的默认选择,因为它显著缩小缓存,同时保留多组键值表示。MQA 适合对吞吐和显存极度敏感的场景,但共享程度最高,模型质量可能更依赖训练设计。
不要把“键值头更少”理解成注意力计算完全按相同比例下降。查询头仍然存在, 与输出投影仍需执行;最明显的收益来自 KV Cache 容量和显存带宽,而不是把所有计算量都缩小到原来的同一比例。
本课总结
- MHA、GQA、MQA 的关键差异是键值头从独立到分组共享再到完全共享
- 单层 KV Cache 与键值头数量成正比,GQA 常用于平衡质量和推理成本
- 减少键值头主要缓解长上下文解码时的显存与带宽压力
下一课预告
下一课将继续优化注意力计算,理解分块计算与在线 Softmax 如何避免显式保存完整注意力矩阵。