
大模型原理与训练 / 系统课时
交叉注意力
交叉注意力
交叉注意力解决的是“解码器下一步该从输入序列读取什么信息”。它让解码器当前位置生成查询,同时把编码器输出作为可反复检索的记忆,从而把已经生成的上下文与原始输入对齐。
学习目标
- 说清交叉注意力中查询、键和值分别来自哪里
- 根据张量形状追踪注意力分数和输出
- 区分因果自注意力与交叉注意力的职责和掩码
交叉注意力的本质
设解码器当前隐藏状态为 ,编码器最终输出为 。交叉注意力先分别投影出查询、键和值:
- 查询 ,表示解码器当前位置正在寻找什么
- 键 ,用于判断每个输入位置与查询的匹配程度
- 值 ,保存匹配后真正要读取的内容
因此,交叉注意力不是让解码器只看某一个固定输入位置,而是为每个目标位置计算一组对全部源位置的权重,再对编码器信息做加权汇总。
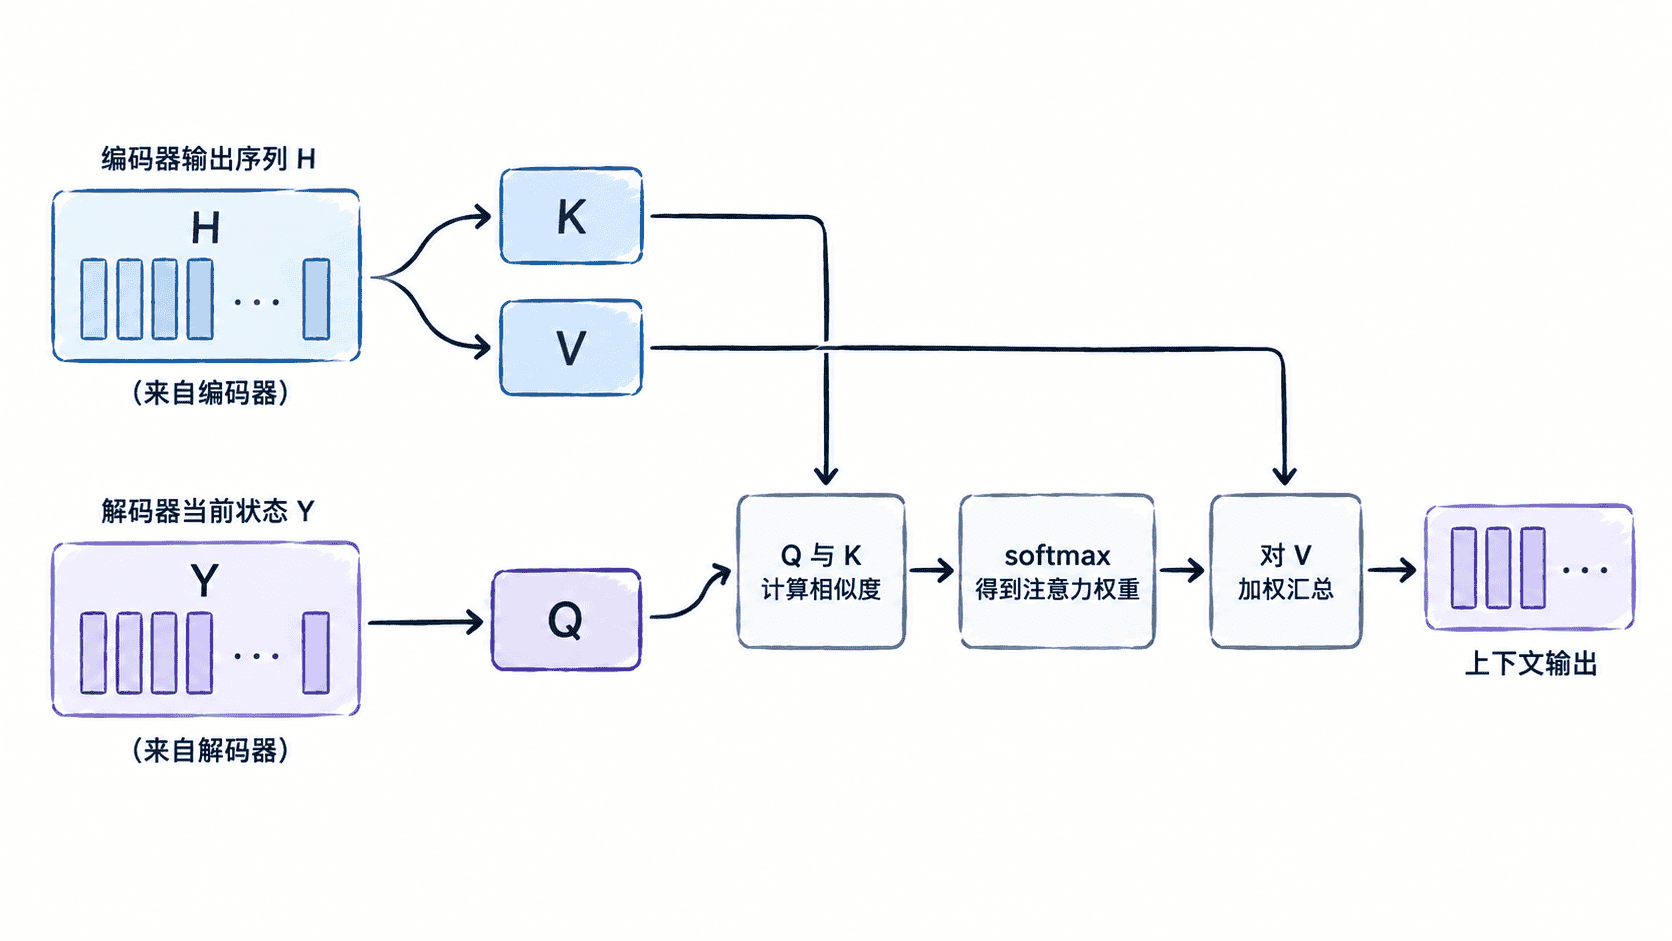
计算可概括为:
其中 通常是编码器侧的填充掩码,用来屏蔽补齐位置;普通编码器—解码器任务不会对源序列使用因果掩码,因为解码器需要访问完整输入。
从形状理解计算过程
假设批大小为 ,目标长度为 ,源长度为 ,单头维度为 。各张量的典型形状如下:
| 张量 | 形状 | 含义 |
|---|---|---|
| 每个目标位置的查询 | ||
| 每个源位置的匹配索引 | ||
| 每个源位置携带的内容 | ||
| 每个目标位置对全部源位置的分数 | ||
| 为每个目标位置汇总出的源信息 |
关键是分数矩阵最后两个维度为 。第 行表示第 个目标位置对全部 个源位置的关注分布,因此源长度和目标长度不需要相等。
与自注意力的区别
| 对比项 | 因果自注意力 | 交叉注意力 |
|---|---|---|
| 查询来源 | 解码器当前序列 | 解码器当前序列 |
| 键和值来源 | 解码器当前序列 | 编码器输出 |
| 主要目的 | 建模已生成目标词之间的依赖 | 从输入序列读取相关信息 |
| 典型掩码 | 因果掩码与目标填充掩码 | 源序列填充掩码 |
| 分数矩阵 |
两者通常连续出现:解码器先通过因果自注意力整理“我已经生成了什么”,再通过交叉注意力查询“输入里哪些内容与当前生成位置最相关”。交叉注意力输出随后进入前馈网络继续变换。
本课总结
- 交叉注意力的 来自解码器, 和 来自编码器输出
- 注意力分数形状为 ,每个目标位置都能读取完整源序列
- 因果自注意力负责目标侧依赖,交叉注意力负责源目标对齐
下一课预告
下一课将把因果自注意力、交叉注意力和前馈网络组合起来,实现一个可运行的解码器层。
按自己的节奏,确认真正理解。