
大模型原理与训练 / 系统课时
构建训练数据集
构建训练数据集
本课完成一个可直接送入 Transformer 的双语序列数据管道:从原始句子建立词表,完成词元化、定长切分、输入与标签错位构造,再用批次整理函数生成掩码。最终你将得到形状稳定、语义对齐且可直接训练的张量。
学习目标
- 实现包含特殊标记的最小词表与词元化流程
- 正确构造解码器输入、预测标签和填充掩码
- 使用
DataLoader整理不同长度样本并验证批次形状
数据处理目标
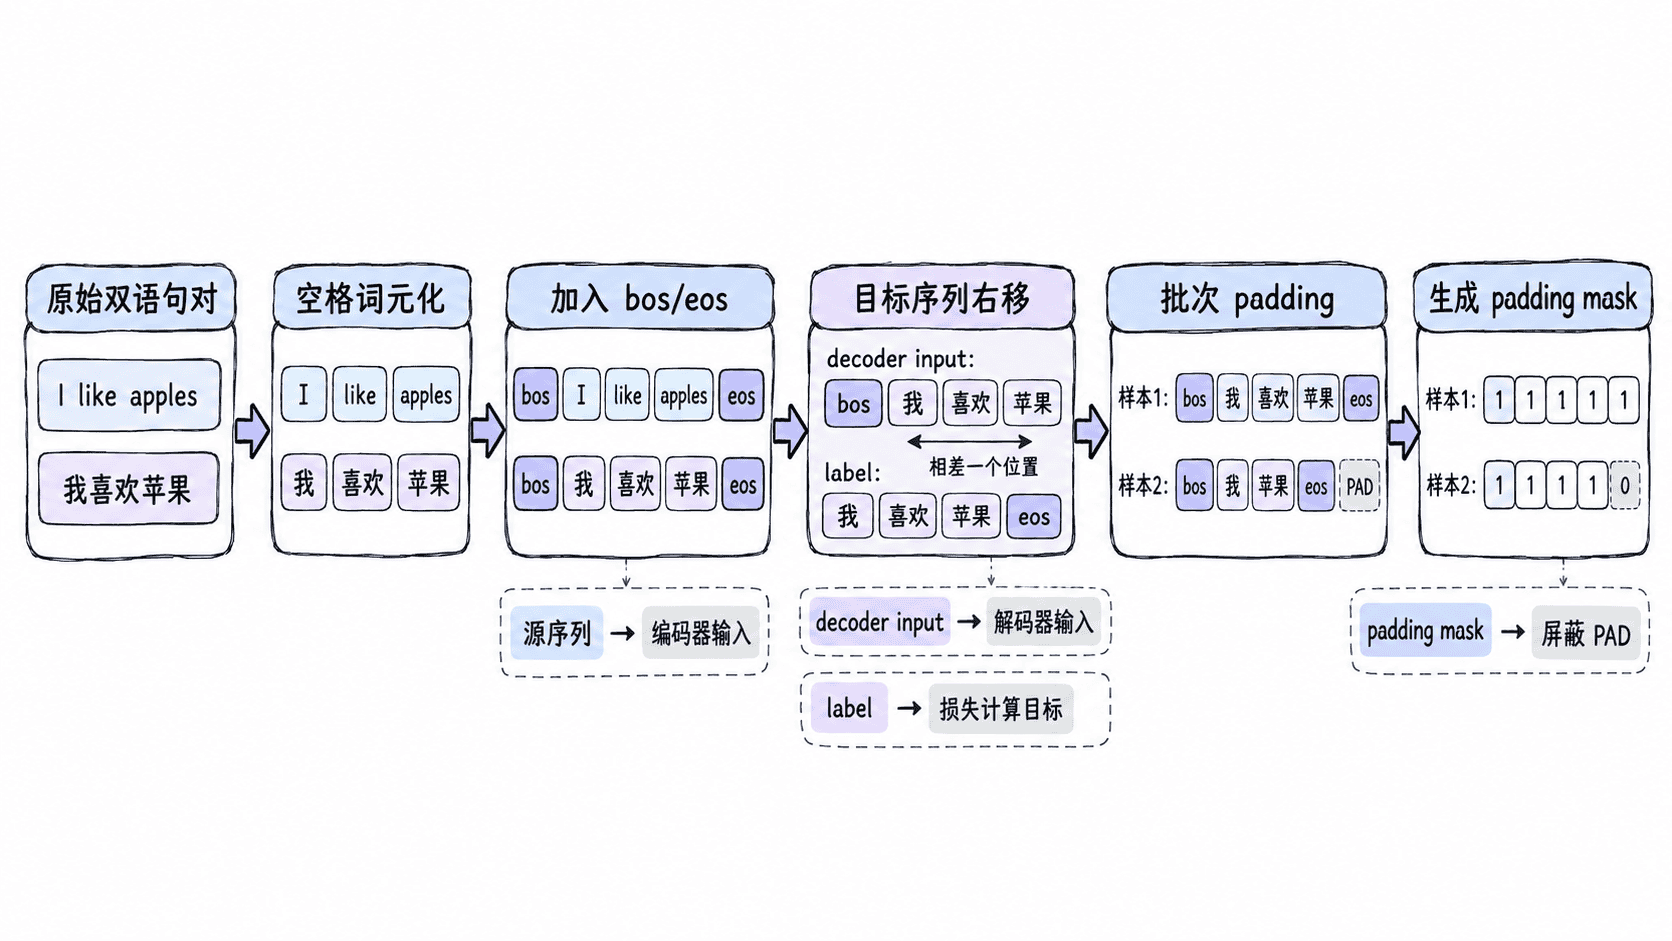
序列到序列训练需要同时准备源序列和目标序列。源序列通常加入 <bos> 与 <eos>;目标序列则拆成两份:解码器输入以 <bos> 开头,标签以真实首词开头并以 <eos> 结束。两者相差一个位置,模型才能学习“根据已有目标词预测下一个词”。
批次中的句子长度不同,因此需要用 <pad> 补齐。填充值本身不能参与注意力和损失计算,所以数据管道还要生成布尔掩码,后续模型会据此忽略填充位置。
完整实现
下面的示例使用一个极小的中英句对集合。为保证示例独立可运行,词元化采用空格切分;真实项目可以替换为 BPE、WordPiece 或 SentencePiece,而后续样本构造逻辑保持不变。
from collections import Counter
from typing import Dict, List, Tuple

import torch
from torch.utils.data import DataLoader, Dataset, Subset

SPECIAL_TOKENS = ["<pad>", "<bos>", "<eos>", "<unk>"]

def tokenize(text: str) -> List[str]:
    return text.strip().lower().split()

def build_vocab(texts: List[str]) -> Dict[str, int]:
    counter = Counter(token for text in texts for token in tokenize(text))
    vocab = {token: index for index, token in enumerate(SPECIAL_TOKENS)}
    for token in sorted(counter):
        if token not in vocab:
            vocab[token] = len(vocab)
    return vocab

def encode(text: str, vocab: Dict[str, int]) -> List[int]:
    unk_id = vocab["<unk>"]
    return [vocab.get(token, unk_id) for token in tokenize(text)]

class TranslationDataset(Dataset):
    def __init__(
        self,
        pairs: List[Tuple[str, str]],
        src_vocab: Dict[str, int],
        tgt_vocab: Dict[str, int],
        max_tokens: int = 6,
    ) -> None:
        self.samples = []
        bos_src, eos_src = src_vocab["<bos>"], src_vocab["<eos>"]
        bos_tgt, eos_tgt = tgt_vocab["<bos>"], tgt_vocab["<eos>"]

        for src_text, tgt_text in pairs:
            # 预留首尾特殊标记,过长样本在词元级截断。
            src_ids = encode(src_text, src_vocab)[: max_tokens - 2]
            tgt_ids = encode(tgt_text, tgt_vocab)[: max_tokens - 1]
            self.samples.append(
                {
                    "src": [bos_src, *src_ids, eos_src],
                    "tgt_input": [bos_tgt, *tgt_ids],
                    "label": [*tgt_ids, eos_tgt],
                }
            )

    def __len__(self) -> int:
        return len(self.samples)

    def __getitem__(self, index: int) -> Dict[str, List[int]]:
        return self.samples[index]

def split_dataset(
    dataset: Dataset,
    train_ratio: float = 0.67,
    seed: int = 7,
) -> Tuple[Subset, Subset]:
    # 固定随机种子,使训练集与验证集划分可以复现。
    generator = torch.Generator().manual_seed(seed)
    indices = torch.randperm(len(dataset), generator=generator).tolist()
    train_size = max(1, int(len(dataset) * train_ratio))
    return (
        Subset(dataset, indices[:train_size]),
        Subset(dataset, indices[train_size:]),
    )

def make_collate_fn(src_pad_id: int, tgt_pad_id: int):
    def collate(batch: List[Dict[str, List[int]]]) -> Dict[str, torch.Tensor]:
        max_src_len = max(len(item["src"]) for item in batch)
        max_tgt_len = max(len(item["tgt_input"]) for item in batch)

        def pad(sequence: List[int], length: int, pad_id: int) -> List[int]:
            return sequence + [pad_id] * (length - len(sequence))

        src = torch.tensor(
            [pad(item["src"], max_src_len, src_pad_id) for item in batch]
        )
        tgt_input = torch.tensor(
            [pad(item["tgt_input"], max_tgt_len, tgt_pad_id) for item in batch]
        )
        label = torch.tensor(
            [pad(item["label"], max_tgt_len, tgt_pad_id) for item in batch]
        )

        return {
            "src": src,
            "tgt_input": tgt_input,
            "label": label,
            "src_padding_mask": src.eq(src_pad_id),
            "tgt_padding_mask": tgt_input.eq(tgt_pad_id),
        }

    return collate

def main() -> None:
    pairs = [
        ("i love ai", "我 爱 ai"),
        ("transformers learn context", "transformer 学习 上下文"),
        ("attention uses masks", "注意力 使用 掩码"),
    ]
    src_vocab = build_vocab([src for src, _ in pairs])
    tgt_vocab = build_vocab([tgt for _, tgt in pairs])

    dataset = TranslationDataset(pairs, src_vocab, tgt_vocab)
    train_dataset, validation_dataset = split_dataset(dataset)
    loader = DataLoader(
        train_dataset,
        batch_size=2,
        shuffle=False,
        collate_fn=make_collate_fn(
            src_vocab["<pad>"],
            tgt_vocab["<pad>"],
        ),
    )

    batch = next(iter(loader))
    print("split sizes:", len(train_dataset), len(validation_dataset))
    print("src shape:", tuple(batch["src"].shape))
    print("tgt_input shape:", tuple(batch["tgt_input"].shape))
    print("label shape:", tuple(batch["label"].shape))
    print("decoder shift aligned:", torch.equal(
        batch["tgt_input"][:, 1:],
        batch["label"][:, :-1],
    ))
    print("src padding mask:", batch["src_padding_mask"].tolist())

if __name__ == "__main__":
    main()
预期输出如下。词表编号由排序规则确定,但本课只验证张量形状、目标错位关系和掩码,因此输出稳定。
split sizes: 2 1
src shape: (2, 5)
tgt_input shape: (2, 4)
label shape: (2, 4)
decoder shift aligned: True
src padding mask: [[False, False, False, False, False], [False, False, False, False, False]]
关键步骤解析
build_vocab 先固定四个特殊标记的编号,再按词元排序加入普通词。固定 <pad> 编号很重要,因为损失函数和注意力掩码都要使用同一个填充值;若训练和推理阶段词表顺序不同,模型参数将无法正确映射到词元。
split_dataset 使用固定随机种子把样本划分为训练集和验证集,保证实验可复现。TranslationDataset 随后在单个样本内部完成截断和标签构造。源序列最多保留 max_tokens - 2 个普通词元,为 <bos>、<eos> 留出位置;目标序列只需为末尾 <eos> 留一个位置,因为 <bos> 只出现在解码器输入中。
collate 在批次级补齐长度,并生成形状为 [batch_size, sequence_length] 的布尔掩码。值为 True 的位置表示填充项,传给 PyTorch Transformer 时会被忽略。标签中的 <pad> 还应在损失函数中通过 ignore_index=tgt_pad_id 排除。
验证与边界
示例中的两个源句长度相同,所以源掩码全为 False。将第一句改成 i love 后重新运行,第一行末尾会出现一个 True,这说明补齐位置已被正确识别。
真实数据还要额外处理空行、异常编码和超长样本。截断策略必须在加入特殊标记之前执行,否则可能把 <eos> 截掉;没有结束标记时,解码器难以学习何时停止生成。
训练时可用下面的损失函数忽略标签中的填充位置。该代码是片段示例,依赖前文得到的 tgt_vocab、模型输出 logits 和批次 batch。
criterion = torch.nn.CrossEntropyLoss(
    ignore_index=tgt_vocab["<pad>"]
)
loss = criterion(
    logits.reshape(-1, logits.size(-1)),
    batch["label"].reshape(-1),
)
生效行为:所有标签为 <pad> 的位置不计入平均损失。验证时可检查 loss.isfinite() 是否为 True,并确认填充比例变化不会显著改变有效词元上的损失。
本课总结
- 目标输入与标签必须右移一位,才能形成“已知前文,预测下一个词”的监督信号
- 截断要为特殊标记预留位置,批次补齐则必须同步生成填充掩码
- 词表、填充值和损失函数的
ignore_index必须保持一致
下一课预告
下一课将把嵌入、位置编码、编码器、解码器和输出层组装成完整 Transformer,并用本课生成的批次完成一次前向传播。