
大模型原理与训练 / 系统课时
随机采样策略
随机采样策略
随机采样不总是选择概率最高的词元,而是从经过调整的概率分布中抽取结果。本文用同一组 logits 演示温度、Top-k 与 Top-p 的处理顺序,并给出可复现代码,帮助你避免输出僵硬、失控或偶发低质量词元。
学习目标
- 理解温度如何改变概率分布的尖锐程度
- 区分 Top-k 的固定候选数与 Top-p 的动态候选集
- 为事实问答和开放式生成选择合理的采样组合
从确定选择到概率抽样
模型先输出词表中每个词元的 logits,再通过 Softmax 转成概率。贪心解码总取最大概率词元,而随机采样按照概率抽取,因此高概率词元更常出现,低概率词元也保留一定机会。
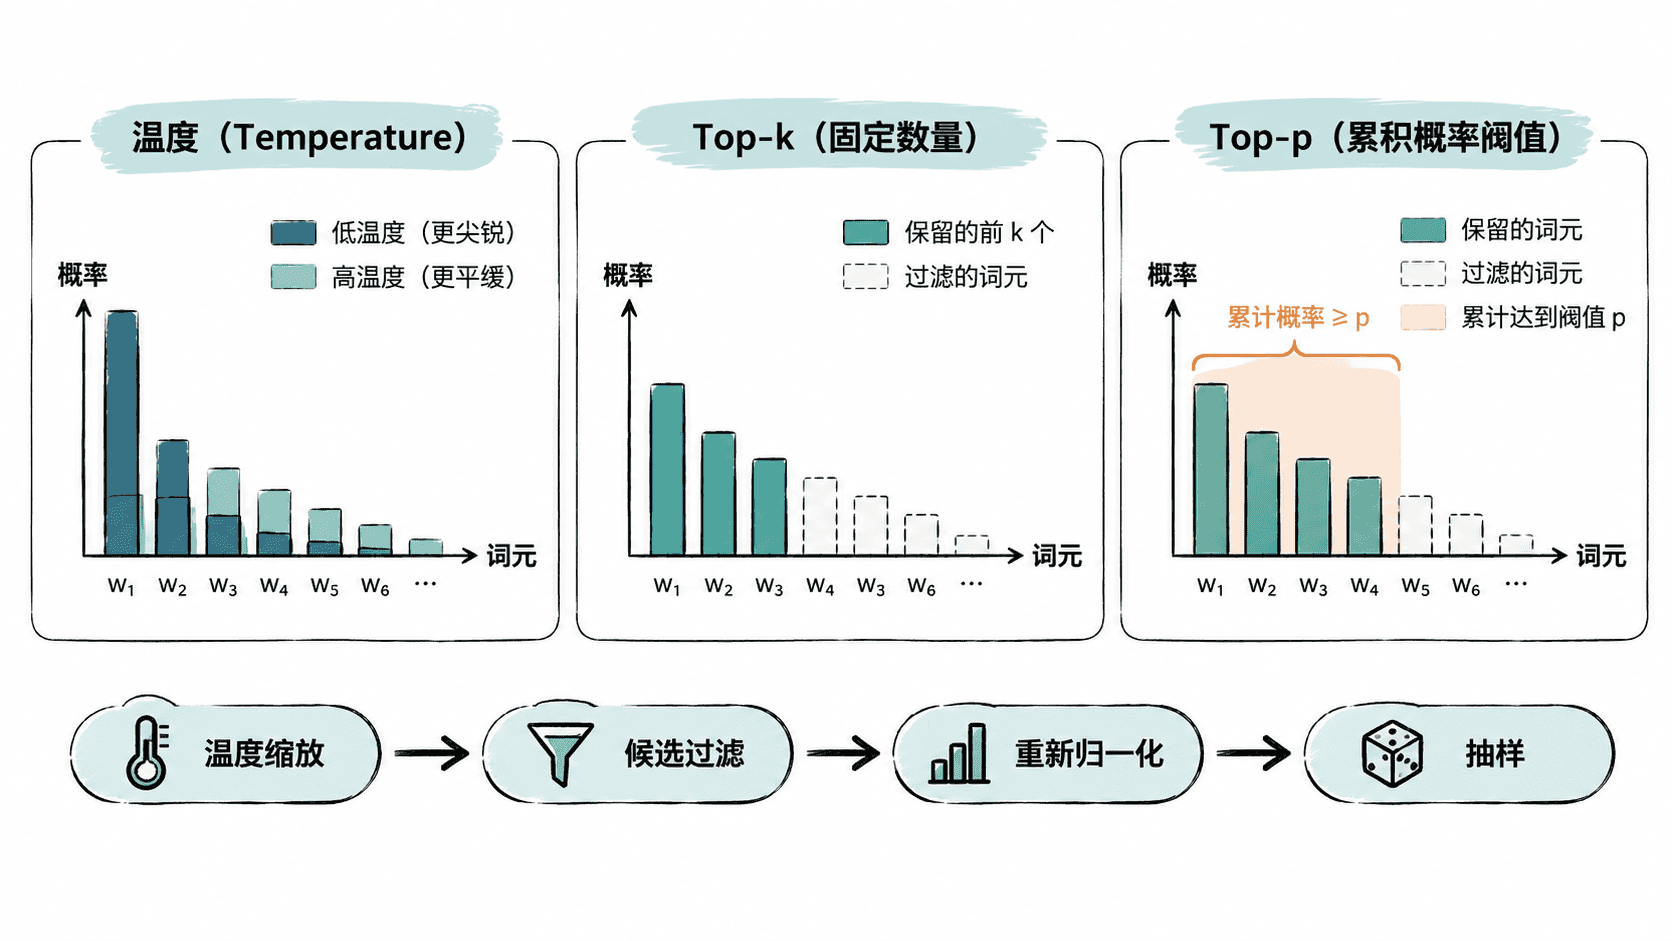
采样通常按“温度缩放 → 候选过滤 → 重新归一化 → 随机抽取”的顺序执行。温度改变整张分布的形状,Top-k 或 Top-p 再删除不希望参与抽样的尾部词元。
温度:调整分布尖锐度
设原始 logits 为 ,温度为 ,缩放后的概率为:
当 时,较大的 logits 被进一步放大,分布更集中,输出更稳定;当 时,分布变平,低概率词元更容易被选中,输出更丰富但风险更高。温度接近 0 时效果接近贪心,但实现中不应直接除以 0。
温度只改变相对概率,并不会主动删除尾部词元。即使某些词元概率很低,它们仍可能被抽中,因此开放式生成通常会把温度与 Top-k 或 Top-p 配合使用。
Top-k:保留固定数量候选
Top-k 先按概率排序,只保留最高的 个词元,再把它们的概率重新归一化。它的优点是候选规模固定、计算行为容易理解;缺点是无法适应分布形状。
当模型非常确定时,前两个词元可能已经覆盖绝大部分概率,但较大的 仍会引入不必要候选。当分布较平时,较小的 又可能过早删除合理表达。因此,Top-k 更适合需要明确限制候选数量的场景。
Top-p:保留动态概率质量
Top-p 又称 nucleus sampling。它从最高概率词元开始累加,选择累计概率首次达到阈值 的最小候选集合,然后重新归一化。
当分布很集中时,候选集可能只有少数词元;当分布较平时,候选集会自动扩大。与固定数量的 Top-k 相比,Top-p 更能随上下文调整搜索空间,因此常用于对话和创作生成。
| 参数 | 直接控制 | 常见风险 |
|---|---|---|
| 温度 | 分布尖锐度 | 过高导致跳跃,过低导致僵硬 |
| Top-k | 候选数量 | 固定数量无法适应不同分布 |
| Top-p | 累计概率质量 | 阈值过高会保留长尾噪声 |
可运行示例:温度与 Top-p 联合采样
下面使用固定抽样位置 0.75 代替随机数,使输出可以稳定复现。真实生成时应将它替换为随机数生成器提供的 浮点数。
import math

def softmax(logits: list[float], temperature: float) -> list[float]:
    if temperature <= 0:
        raise ValueError("temperature must be greater than 0")

    scaled = [value / temperature for value in logits]
    max_value = max(scaled)
    exponents = [math.exp(value - max_value) for value in scaled]
    total = sum(exponents)
    return [value / total for value in exponents]

def top_p_filter(
    tokens: list[str],
    probabilities: list[float],
    top_p: float,
) -> list[tuple[str, float]]:
    if not 0 < top_p <= 1:
        raise ValueError("top_p must be in (0, 1]")

    ranked = sorted(
        zip(tokens, probabilities),
        key=lambda item: item[1],
        reverse=True,
    )

    selected = []
    cumulative = 0.0
    for token, probability in ranked:
        selected.append((token, probability))
        cumulative += probability
        if cumulative >= top_p:
            break

    # 过滤后重新归一化,保证候选概率之和等于 1。
    selected_total = sum(probability for _, probability in selected)
    return [
        (token, probability / selected_total)
        for token, probability in selected
    ]

def sample_with_fixed_draw(
    distribution: list[tuple[str, float]],
    draw: float,
) -> str:
    cumulative = 0.0
    for token, probability in distribution:
        cumulative += probability
        if draw < cumulative:
            return token
    return distribution[-1][0]

tokens = ["A", "B", "C", "D"]
logits = [2.0, 1.2, 0.5, -0.2]

probabilities = softmax(logits, temperature=0.8)
filtered = top_p_filter(tokens, probabilities, top_p=0.85)
chosen = sample_with_fixed_draw(filtered, draw=0.75)

print(
    "temperature:",
    ", ".join(
        f"{token}={probability:.4f}"
        for token, probability in zip(tokens, probabilities)
    ),
)
print(
    "top-p:",
    ", ".join(
        f"{token}={probability:.4f}"
        for token, probability in filtered
    ),
)
print(f"draw=0.75 -> {chosen}")
预期输出:
temperature: A=0.6309, B=0.2321, C=0.0967, D=0.0403
top-p: A=0.7311, B=0.2689
draw=0.75 -> B温度缩放后,A 与 B 的累计概率已经超过 0.85,因此 Top-p 删除 C 和 D。重新归一化后,固定抽样位置 0.75 落入 B 的区间,所以结果为 B。
参数组合与调节顺序
需要事实准确、格式稳定的任务应使用较低温度,并收紧 Top-p;创意写作可以适度提高温度和 Top-p,但仍应通过最大长度、停止词和内容校验限制失控。不同模型的合适数值并不相同,不能把一组参数机械复制到所有模型。
调参时一次只改变一个变量。先固定 Top-p 调温度,观察表达是否过于重复或跳跃;再固定温度调整 Top-p,观察候选是否过窄或混入长尾噪声。若框架同时启用 Top-k 和 Top-p,应确认过滤顺序,因为不同实现的最终候选集可能略有差异。
本课总结
- 温度改变概率分布的尖锐程度,但不会删除低概率词元
- Top-k 保留固定数量候选,Top-p 按累计概率动态决定候选数量
- 稳定生成应按任务逐步调参,并结合长度、停止条件和结果校验共同控制风险
下一课预告
下一课将继续讨论生成控制,重点分析重复惩罚、长度限制与停止条件如何约束模型输出。