
大模型原理与训练 / 系统课时
查询键和值
查询键和值
自注意力不会直接拿输入向量彼此比较,而是先把每个词元分别映射成 Query、Key 和 Value。理解这三类向量的分工后,就能看懂注意力为什么既能“寻找相关位置”,又能“汇总有用信息”。
学习目标
- 说清 Query、Key、Value 各自承担的职责
- 理解三组向量如何由同一输入线性映射得到
- 能根据矩阵形状判断 Q、K、V 的维度是否正确
从一次信息检索理解 Q、K、V
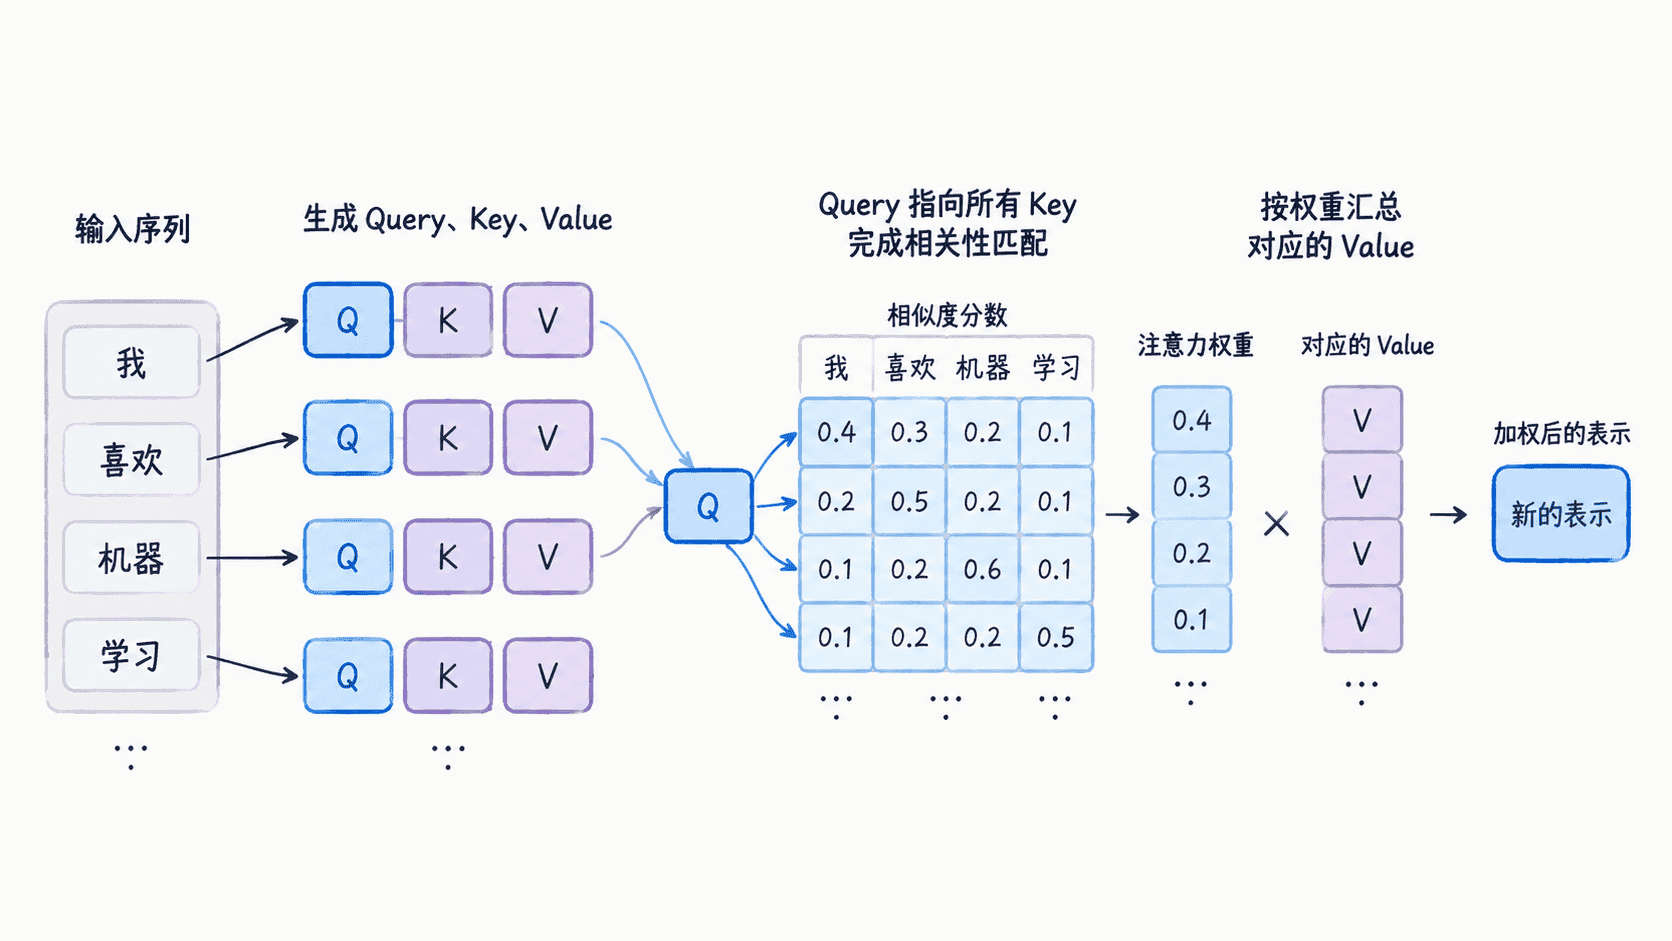
可以把自注意力看成一次可学习的信息检索。当前位置提出“我需要什么”,序列中每个位置声明“我能被怎样匹配”,同时提供“真正可被取走的内容”。
Query 表示当前词元的查询需求;Key 表示每个词元用于匹配的特征;Value 表示匹配成功后要汇总的信息。注意力先比较 Query 与 Key,再用比较结果对 Value 加权,因此“匹配依据”和“传递内容”是分开的。
线性映射与矩阵形状
设序列长度为 ,每个词元的表示维度为 ,把全部输入堆叠成矩阵 ,则 的形状为 。模型为三种角色分别学习一组参数矩阵:
若 和 的形状都是 ,则 、 的形状都是 ;若 的形状是 ,则 的形状是 。三组映射输入相同但参数独立,使同一个词元能分别表达查询需求、匹配特征和传递内容。
假设一句话被分成 4 个词元,输入维度为 6,并把查询、键和值都映射到 3 维,则矩阵形状如下:
| 矩阵 | 形状 | 含义 |
|---|---|---|
| 4 个词元的输入表示 | ||
| 三组可学习映射参数 | ||
| 每个词元对应一组 Q、K、V 向量 |
矩阵乘法只改变特征维度,不改变词元数量。因此生成 Q、K、V 后,第一维仍然等于序列长度 4,后续每个 Query 才能与 4 个 Key 逐一比较。
容易混淆的两点
Q、K、V 不是三个不同的输入序列,而是同一批输入经过三组不同参数得到的三种视角。在自注意力中,它们通常都来自同一个 ;在编码器—解码器注意力中,Query 可以来自解码器,而 Key 和 Value 来自编码器。
Key 与 Value 也不能合并理解。Key 决定某个位置应该获得多大权重,Value 决定该位置最终贡献什么内容。一个位置可以因为 Key 很匹配而被高度关注,但真正加入输出的是它的 Value。
本课总结
- Query 描述查询需求,Key 负责匹配,Value 承载被汇总的信息
- Q、K、V 由同一输入矩阵分别乘以独立参数矩阵得到
- 线性映射改变特征维度,但不会改变序列长度
下一课预告
下一课将使用 Query 与 Key 的点积构造注意力分数矩阵,并逐项解释矩阵中每个位置代表什么。