
大模型原理与训练 / 系统课时
交叉熵损失
交叉熵损失
语言模型会为词表中的每个词元输出一个分数,但训练需要把整组分数压缩成可比较的损失值。本课从 Softmax 概率出发,推导目标词元的交叉熵,并说明序列训练中如何忽略无效位置和稳定计算。
学习目标
- 说明 logits、词元概率、目标标签与交叉熵之间的关系
- 计算单个词元位置和整个序列的平均损失
- 理解忽略位置、数值稳定性与标签平滑的作用
从分数到单位置损失
模型最后一层会输出长度等于词表大小的 logits 向量 。logits 可以是任意实数,不要求总和为 1。Softmax 将它转换为概率分布:
其中 是词表大小, 表示当前位置预测第 个词元的概率。假设目标词元索引为 ,交叉熵只关心模型分配给正确词元的概率:
目标概率越高,损失越小;目标概率越低,损失增长越快。以自然对数计算时,正确词元概率为 ,损失约为 ;概率只有 ,损失约为 。
| 正确词元概率 | 单位置损失 | 含义 |
|---|---|---|
| 0.9 | 0.105 | 预测较有把握 |
| 0.5 | 0.693 | 仍有明显不确定性 |
| 0.1 | 2.303 | 正确词元被严重低估 |
交叉熵并不是简单判断“猜对或猜错”。即使最高概率词元正确,只要置信度不高,仍会产生明显损失;这使模型不仅要选对答案,还要把更多概率质量分配给正确词元。
序列损失如何聚合
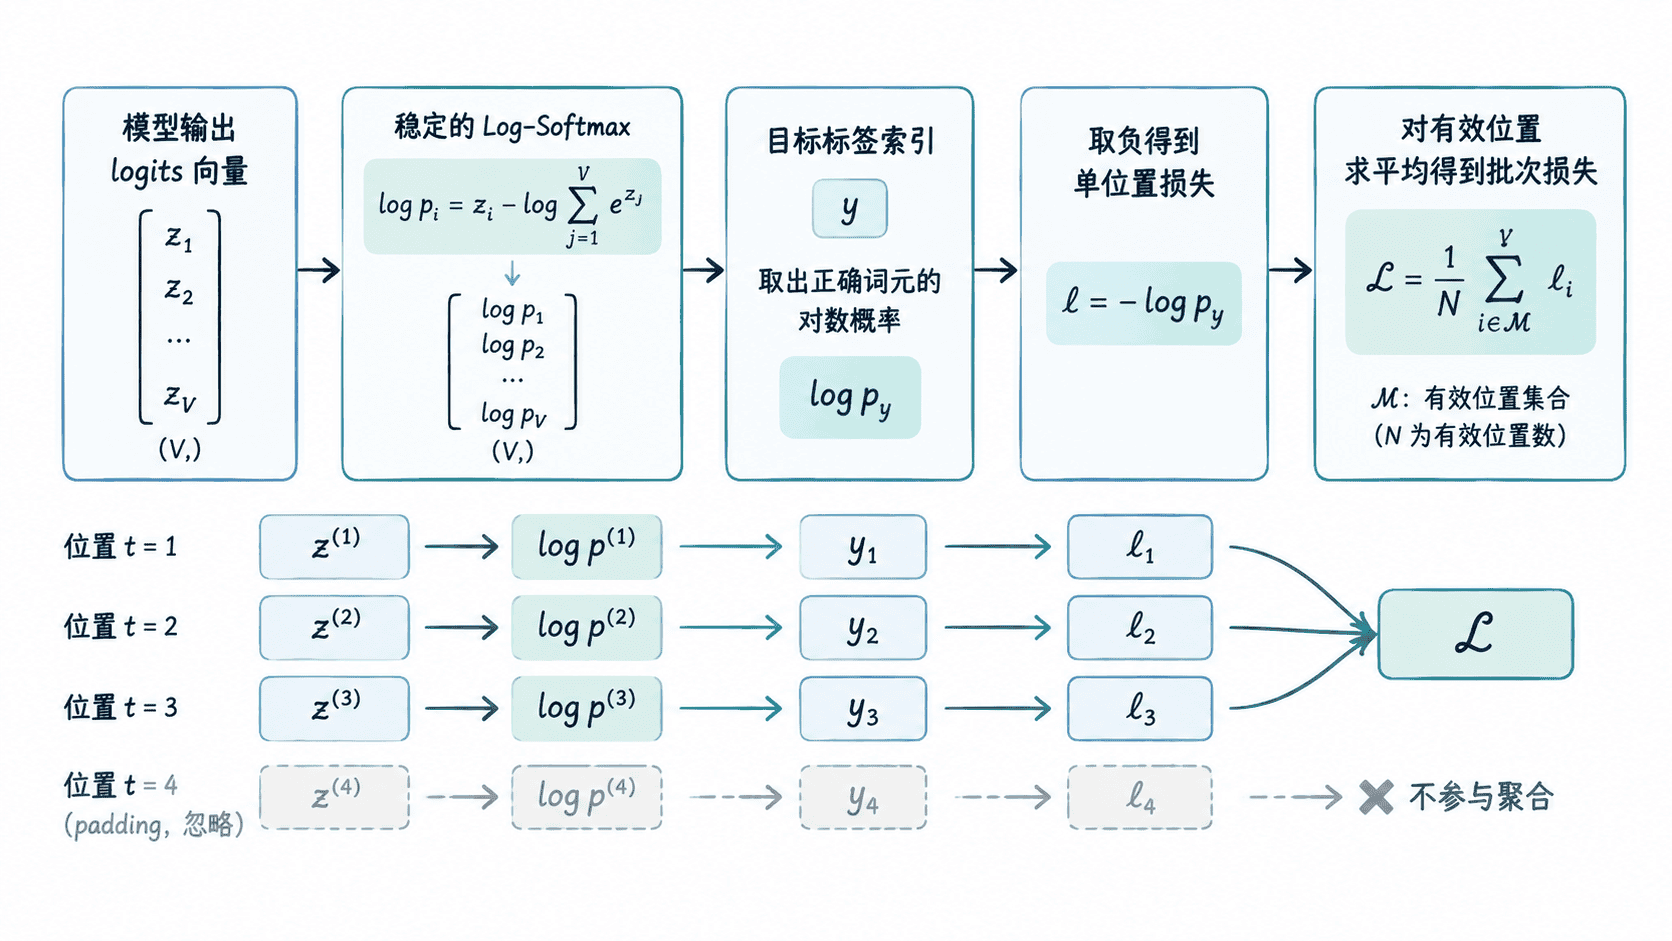
一个批次通常包含多个样本和多个词元位置。设所有有效监督位置组成集合 ,平均交叉熵为:
这里的 不包含填充位置,也不包含被任务规则忽略的位置。因果语言建模会统计所有有效的下一词元标签;掩码语言建模通常只统计被选中恢复的词元。用有效位置数量做平均,可以减少序列长度差异对损失尺度的影响。
数值稳定与判断边界
直接计算 可能在 logits 很大时溢出。深度学习框架通常把 Log-Softmax 与负对数似然合并为交叉熵函数,并在内部减去最大 logit。因此,交叉熵函数通常接收原始 logits,而不是已经经过 Softmax 的概率。
还要确认聚合方式。mean 表示对有效位置求平均,sum 表示直接求和;两者会改变梯度尺度。标签平滑会把少量目标概率分配给其他词元,可缓解过度自信,但会改变理想目标分布,不能与普通 one-hot 标签混为一谈。
随机初始化且预测接近均匀分布时,单位置损失通常接近 。训练有效时,训练集损失应总体下降;若损失变为 NaN,应优先检查学习率、非法标签索引、数值溢出和有效位置数量是否为零。不同词表、分词方式或标签规则下的损失值不能直接横向比较。
本课总结
- 交叉熵等于正确词元对数概率的相反数,正确词元概率越高,损失越小
- 序列训练应只聚合有效监督位置,并明确使用平均还是求和
- 实现时应把原始 logits 交给稳定的交叉熵函数,避免重复 Softmax 和数值溢出
下一课预告
下一课将把损失函数与梯度更新连接起来,观察模型参数如何通过反向传播和优化器逐步降低训练误差。