
大模型原理与训练 / 系统课时
主流模型演进路线
主流模型演进路线
本课解决“BERT、GPT、T5 与视觉 Transformer 到底是什么关系”这一问题。学完后,你能从原始 Transformer 的编码器与解码器出发,快速判断代表模型保留了哪部分结构、擅长什么任务,以及选型时应关注什么。
学习目标
- 说清 BERT、GPT、T5、ViT 与原始 Transformer 的结构关系
- 根据任务类型判断编码器、解码器或编码器—解码器架构
- 避免把模型规模、训练目标和网络结构混为一谈
从原始 Transformer 看分支演进
2017 年提出的 Transformer 由编码器和解码器组成:编码器负责把输入转换成上下文表示,解码器在已生成内容和编码结果的共同条件下逐步输出。后续主流模型并不是简单的一条升级链,而是围绕“保留哪一部分、采用什么训练目标、处理什么模态”形成多个分支。
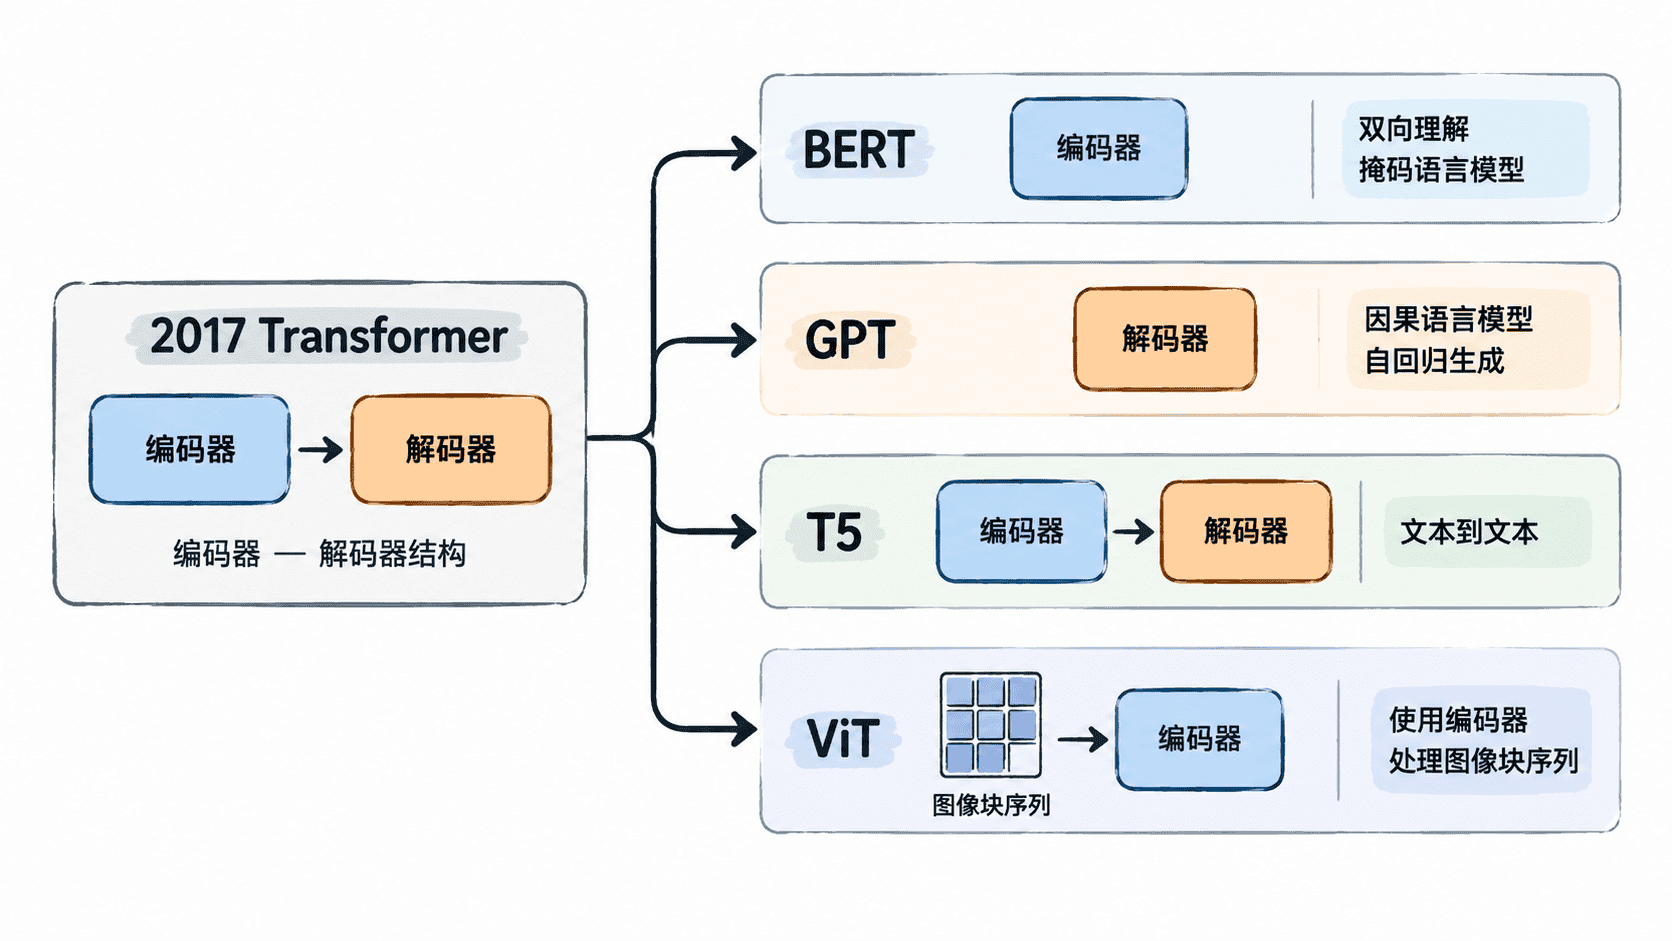
这张图的重点不是发布时间先后,而是结构来源。BERT 与 ViT 主要继承编码器,GPT 主要继承解码器,T5 则保留完整的编码器—解码器框架。它们都继续使用多头注意力、前馈网络、残差连接和归一化等核心组件。
代表模型的核心差异
| 模型 | 主要结构 | 典型训练目标 | 更擅长的任务 |
|---|---|---|---|
| BERT | 编码器堆叠 | 掩码语言建模 | 分类、匹配、抽取、语义表示 |
| GPT | 解码器堆叠 | 预测下一个词元 | 文本生成、对话、代码生成 |
| T5 | 编码器—解码器 | 文本到文本的条件生成 | 翻译、摘要、问答、改写 |
| ViT | Transformer 编码器 | 图像块序列建模 | 图像分类与视觉表征 |
BERT 能同时利用目标词元左右两侧的上下文,因此适合理解型任务;GPT 只能关注当前位置之前的词元,却天然符合逐步生成过程;T5 先完整编码输入,再由解码器生成目标序列;ViT 则把图像切成固定大小的块,将每个图像块视为序列元素。
如何根据任务选择架构
当输出是一个类别、标签或向量表示时,优先考虑编码器模型;当目标是连续生成文本或代码时,优先考虑解码器模型;当输入和输出都是完整序列,而且输出需要强依赖输入时,编码器—解码器通常更自然。视觉任务则先判断数据是否能转成图像块、区域或多模态词元序列。
模型名称不能单独决定能力。参数规模、预训练数据、上下文长度、微调方式和推理成本都会改变最终表现。尤其不要把“GPT 等于所有大语言模型”或“BERT 不能生成任何文本”当成绝对结论;更准确的判断方式是先看结构和训练目标,再看具体实现。
本课总结
- 原始 Transformer 同时包含编码器与解码器,后续模型围绕结构取舍形成不同分支
- BERT 偏理解,GPT 偏自回归生成,T5 偏条件生成,ViT 将编码器扩展到视觉序列
- 模型选型应同时考虑任务输出形式、训练目标、数据模态和推理成本
下一课预告
下一课将搭建 Python、PyTorch、Jupyter 与 Transformers 开发环境,并创建后续实验统一使用的项目目录。