
大模型原理与训练 / 系统课时
基线模型训练
基线模型训练
本课使用 TF-IDF 与逻辑回归建立文本分类基线。这个基线训练快、结果稳定,能够验证数据与评估流程是否正确,并为后续 Transformer 模型提供可比较的最低参考线。
学习目标
- 固定数据、随机种子和超参数,建立可复现实验。
- 训练首个文本分类基线并计算准确率与宏平均 F1。
- 保存模型、指标和数据校验值,形成完整实验记录。
固定基线边界
基线使用 data/processed/train.csv、valid.csv 和 test.csv,每个文件至少包含 text 与 label 两列。训练阶段只读取训练集;验证集用于选择方案;测试集只在方案确定后评估一次,避免根据测试结果反复调参。
本课采用字符级 2~4 元 TF-IDF 特征,再训练带类别平衡的逻辑回归。它不是最终模型,但能快速暴露标签错误、数据泄漏、类别极不平衡和评估代码问题。
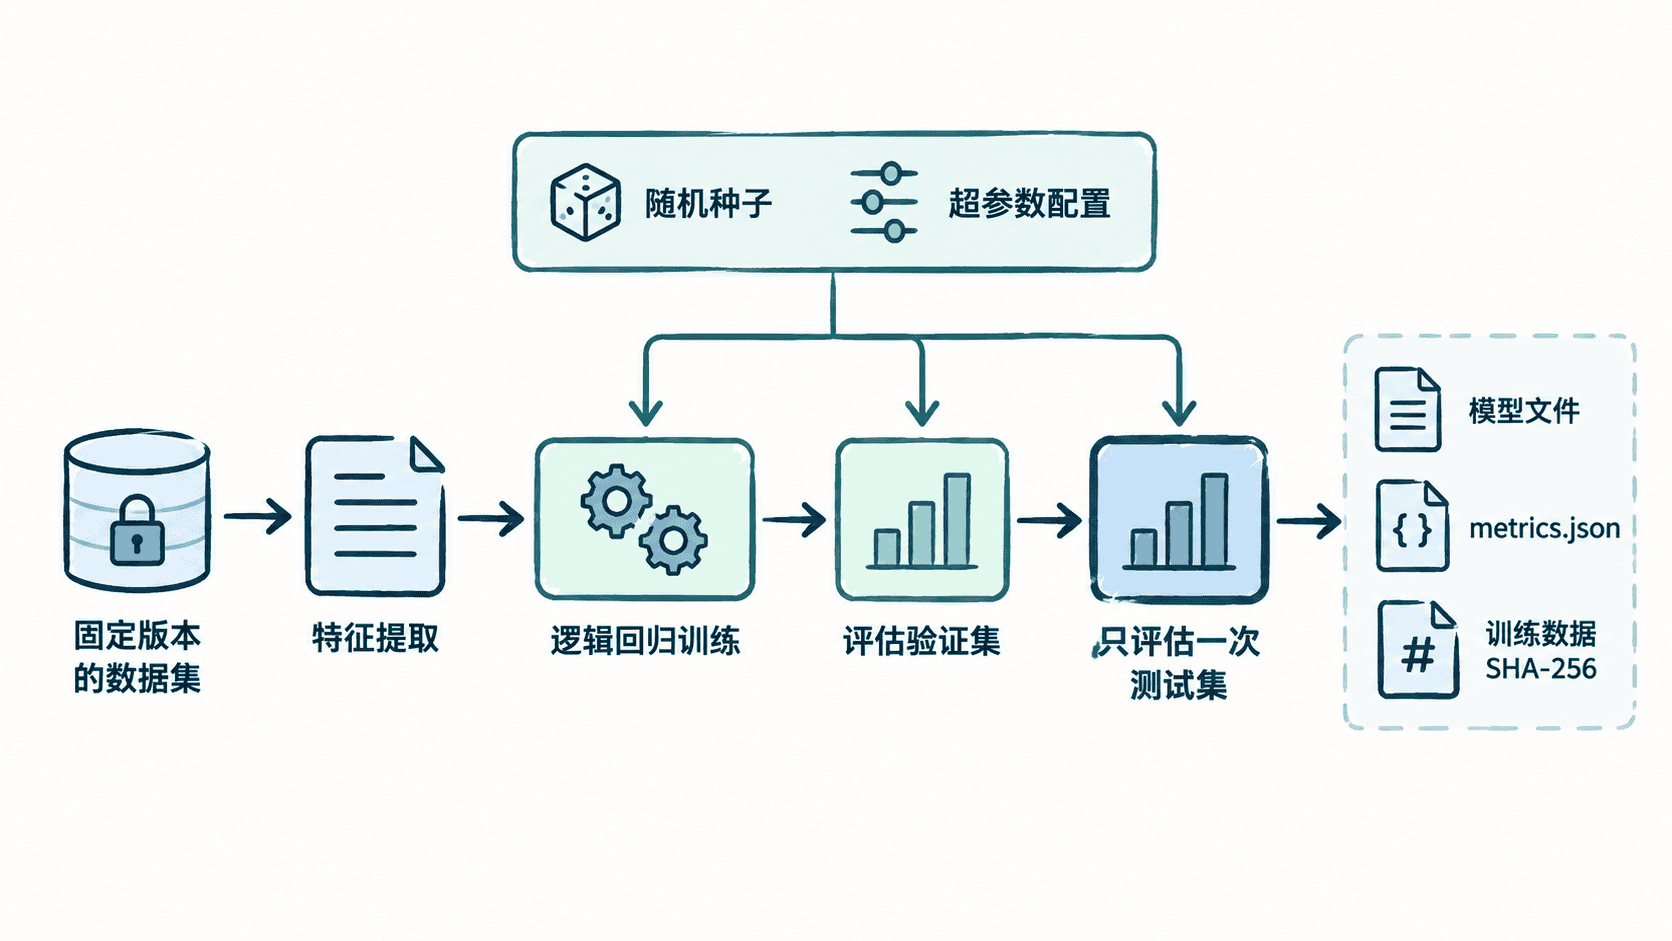
完成可复现训练脚本
以下脚本使用真实可用的 scikit-learn API。将代码保存为 train_baseline.py,安装 pandas、scikit-learn 和 joblib 后执行即可。
from hashlib import sha256
import json
from pathlib import Path
import random

import joblib
import pandas as pd
import sklearn
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, f1_score
from sklearn.pipeline import Pipeline

DATA_DIR = Path("data/processed")
ARTIFACT_DIR = Path("artifacts/baseline")
RANDOM_SEED = 42

def file_sha256(path: Path) -> str:
    digest = sha256()
    with path.open("rb") as file:
        for chunk in iter(lambda: file.read(8192), b""):
            digest.update(chunk)
    return digest.hexdigest()

def load_split(name: str) -> pd.DataFrame:
    path = DATA_DIR / f"{name}.csv"
    df = pd.read_csv(path)
    required = {"text", "label"}
    missing = required - set(df.columns)
    if missing:
        raise ValueError(f"{path} 缺少字段: {sorted(missing)}")
    return df

def evaluate(model: Pipeline, df: pd.DataFrame) -> dict[str, float]:
    predictions = model.predict(df["text"])
    return {
        "accuracy": round(accuracy_score(df["label"], predictions), 6),
        "macro_f1": round(
            f1_score(df["label"], predictions, average="macro"),
            6,
        ),
    }

def main() -> None:
    random.seed(RANDOM_SEED)
    train_df = load_split("train")
    valid_df = load_split("valid")
    test_df = load_split("test")

    # 所有超参数集中写入流水线,便于完整保存与复用。
    model = Pipeline(
        steps=[
            (
                "tfidf",
                TfidfVectorizer(
                    analyzer="char",
                    ngram_range=(2, 4),
                    min_df=2,
                    max_features=50000,
                    sublinear_tf=True,
                ),
            ),
            (
                "classifier",
                LogisticRegression(
                    max_iter=1000,
                    class_weight="balanced",
                    random_state=RANDOM_SEED,
                ),
            ),
        ]
    )
    model.fit(train_df["text"], train_df["label"])

    metrics = {
        "valid": evaluate(model, valid_df),
        "test": evaluate(model, test_df),
        "seed": RANDOM_SEED,
        "train_rows": len(train_df),
        "train_sha256": file_sha256(DATA_DIR / "train.csv"),
        "sklearn_version": sklearn.__version__,
    }

    ARTIFACT_DIR.mkdir(parents=True, exist_ok=True)
    joblib.dump(model, ARTIFACT_DIR / "model.joblib")
    (ARTIFACT_DIR / "metrics.json").write_text(
        json.dumps(metrics, ensure_ascii=False, indent=2),
        encoding="utf-8",
    )

    print(json.dumps(metrics, ensure_ascii=False))

if __name__ == "__main__":
    main()
预期输出如下。指标和校验值由实际数据决定,尖括号中的内容会不同:
{"valid":{"accuracy":<VALID_ACCURACY>,"macro_f1":<VALID_MACRO_F1>},"test":{"accuracy":<TEST_ACCURACY>,"macro_f1":<TEST_MACRO_F1>},"seed":42,"train_rows":<TRAIN_ROWS>,"train_sha256":"<SHA256>","sklearn_version":"<VERSION>"}执行后还应生成 artifacts/baseline/model.joblib 与 artifacts/baseline/metrics.json。前者用于复现预测,后者用于比较不同实验。
读取实验结果
比较模型时应优先查看宏平均 F1,因为它会对每个标签分别计算 F1 后再平均,不会让大类别完全主导结果。准确率仍然有价值,但在类别不平衡时不能单独作为结论。
验证集指标用于迭代特征和超参数,测试集指标只用于最终报告。若每次改参数后都查看测试集,测试集就会逐渐变成另一份验证集,最终结果不再可信。
建立基线验收规则
一个可用基线不要求指标很高,但必须满足三个条件:同一数据和环境重复运行结果一致;模型、指标与数据校验值都已保存;验证集与测试集的差距能够解释。若验证集明显高于测试集,应先检查数据分布漂移和重复样本,而不是立即扩大模型。
后续 Transformer 实验应复用相同的数据切分和评估指标。只有数据、指标和测试时机保持一致,模型之间的比较才有意义。
本课总结
- 基线的首要作用是验证训练与评估链路,而不是追求最终效果。
- 可复现实验需要同时记录随机种子、超参数、依赖版本和数据校验值。
- 验证集用于迭代,测试集只在方案确定后评估一次。
下一课预告
下一课将以当前基线为参照,引入 Transformer 模型进行微调,并比较训练成本、收敛速度和分类指标的变化。