
大模型原理与训练 / 系统课时
因果注意力掩码
因果注意力掩码
因果注意力掩码为解码器划定可见范围:序列中每个位置只能关注自己和左侧词元,不能读取右侧未来内容。掌握它后,就能理解 Transformer 为什么能并行训练,却仍保持自回归生成规则。
学习目标
- 读懂因果掩码矩阵中允许与禁止关注的位置
- 理解掩码如何在 Softmax 前阻断未来词元
- 区分因果掩码与填充掩码的职责
为什么必须屏蔽未来
训练时,完整句子会一次性送入模型。若不做限制,位置 在预测 时可以直接看到右侧真实词元,相当于提前读取答案。模型即使得到很低的训练损失,也无法在真实生成阶段复现这种条件。
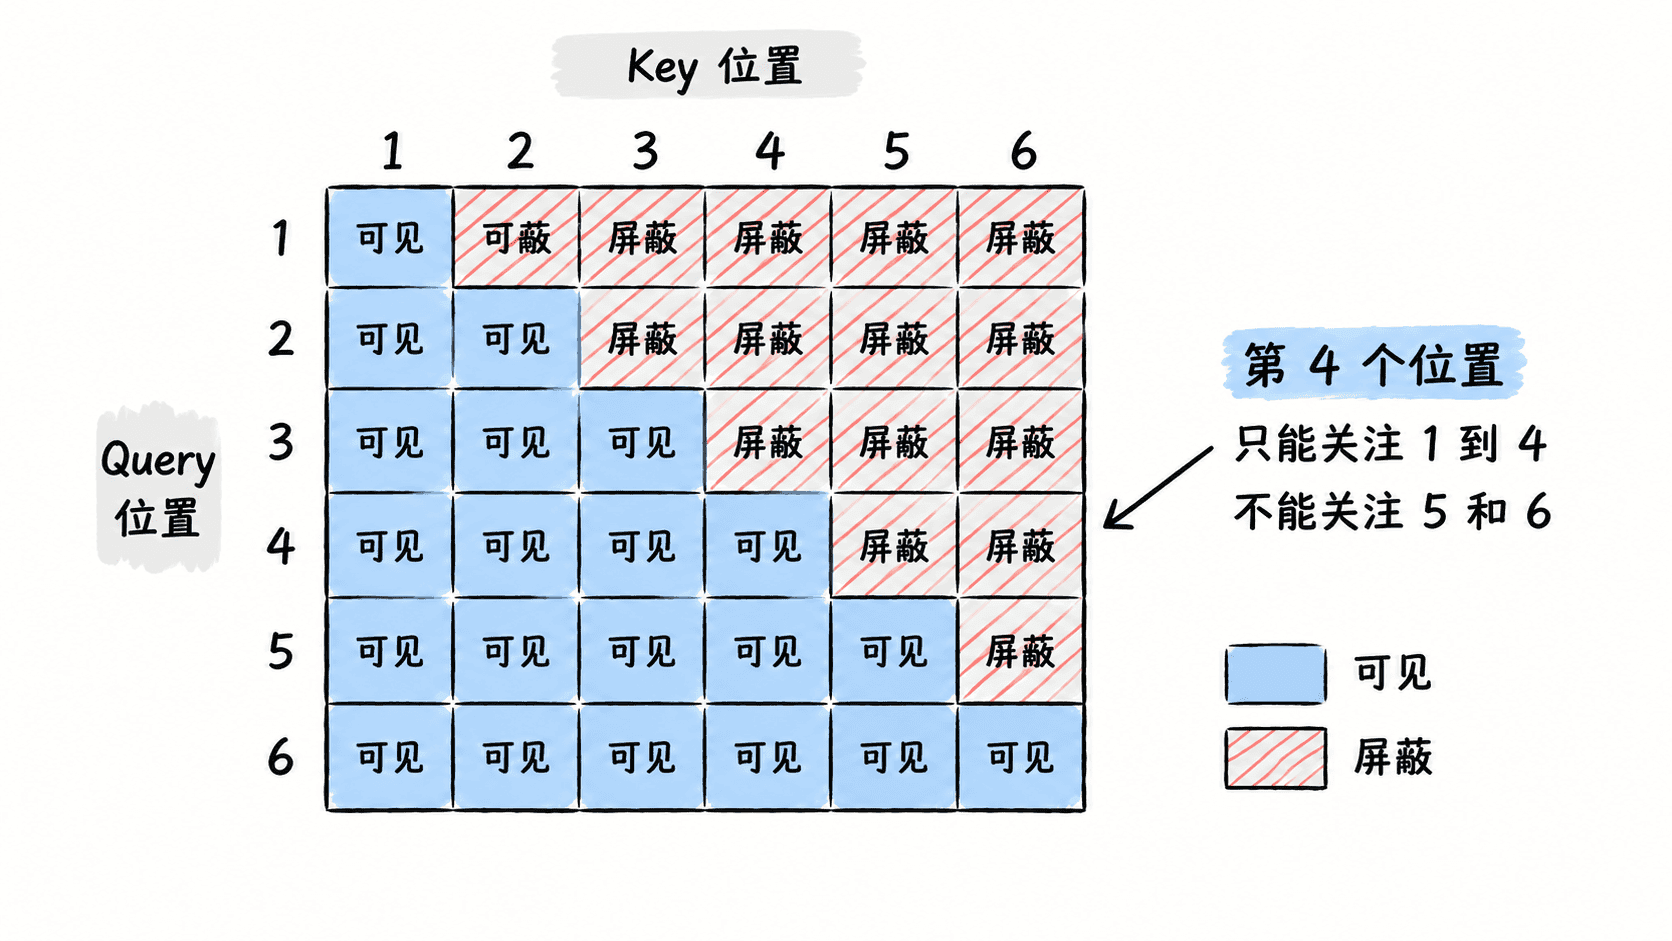
因果掩码通过固定可见范围解决这个问题。第 1 个位置只能看第 1 个位置,第 2 个位置可以看前两个位置,第 3 个位置可以看前三个位置,依此类推。
上三角掩码怎样工作
设注意力分数矩阵为 ,因果掩码矩阵为 。允许关注的位置取 0,未来位置取一个极小值,理论上记作 :
当极小值进入 Softmax 后,对应位置的概率会变成 0,因此这些未来词元不会参与加权求和。常见矩阵形态如下,其中 0 表示可见, 表示屏蔽:
| Query 位置 | Key 1 | Key 2 | Key 3 | Key 4 |
|---|---|---|---|---|
| 1 | 0 | |||
| 2 | 0 | 0 | ||
| 3 | 0 | 0 | 0 | |
| 4 | 0 | 0 | 0 | 0 |
为什么还能并行训练
因果掩码限制的是信息流向,不是计算顺序。训练时,所有位置的查询、键和值仍可一次性计算,只是在注意力分数矩阵上把右上三角区域屏蔽掉。
这样,位置 1 到位置 的下一词元预测可以并行得到,同时每个位置都严格只依赖自己的前缀。并行训练因此不会破坏自回归约束,而推理阶段仍需等待前一个词元真正生成后再继续。
与填充掩码的区别
因果掩码解决“不能看未来”的问题,通常用于自回归解码器。填充掩码解决“不能把补齐位置当成真实内容”的问题,常用于长度不一致的批量序列。
两种掩码可以同时存在。例如,一个批次既包含补齐词元,又进行自回归训练时,最终可见范围应同时满足两个条件:不能看未来,也不能关注 PAD。实现中通常把两种掩码合并后再加到注意力分数上。
常见理解错误
第一,掩码不是删除未来词元,而是让它们在当前查询位置上的注意力权重变为 0。第二,上三角或下三角的叫法与矩阵坐标约定有关,判断时应直接检查“第 行是否只能访问第 1 到 列”。
第三,因果掩码只约束注意力可见性,不负责决定生成哪个词元。真正的词元选择仍由输出概率分布和解码策略完成。
本课总结
- 因果掩码保证每个位置只能读取自己及之前的词元
- 它在 Softmax 前把未来位置设为极小值,使对应注意力权重归零
- 因果掩码与填充掩码职责不同,但可在同一次注意力计算中合并
下一课预告
下一课将进入解码器结构,观察掩码自注意力、交叉注意力和前馈网络如何配合完成序列生成。