
大模型原理与训练 / 系统课时
点积与相似度
点积与相似度
本课解释点积如何把两个向量压缩成一个相似性分数,并进一步说明注意力机制为什么使用缩放点积。学完后,你能判断分数的几何含义,也能识别点积与余弦相似度的差别。
学习目标
- 掌握点积的计算规则与几何意义
- 区分点积和余弦相似度的适用场景
- 理解缩放点积注意力如何产生权重
点积计算了什么
两个同维向量 与 的点积,是对应位置相乘后求和:
例如,,,则点积为 。点积把两个向量的逐维匹配结果汇总为一个标量,因此适合用作相关性分数。
点积要求两个向量维度一致。它不产生新方向,而是回答“这两个表示在各维度上总体有多一致”。
点积的几何意义
点积也可以写成:
其中, 是两个向量的夹角。夹角小于 时点积为正,说明方向大体一致;等于 时点积为零;大于 时点积为负,说明方向相反的成分更多。
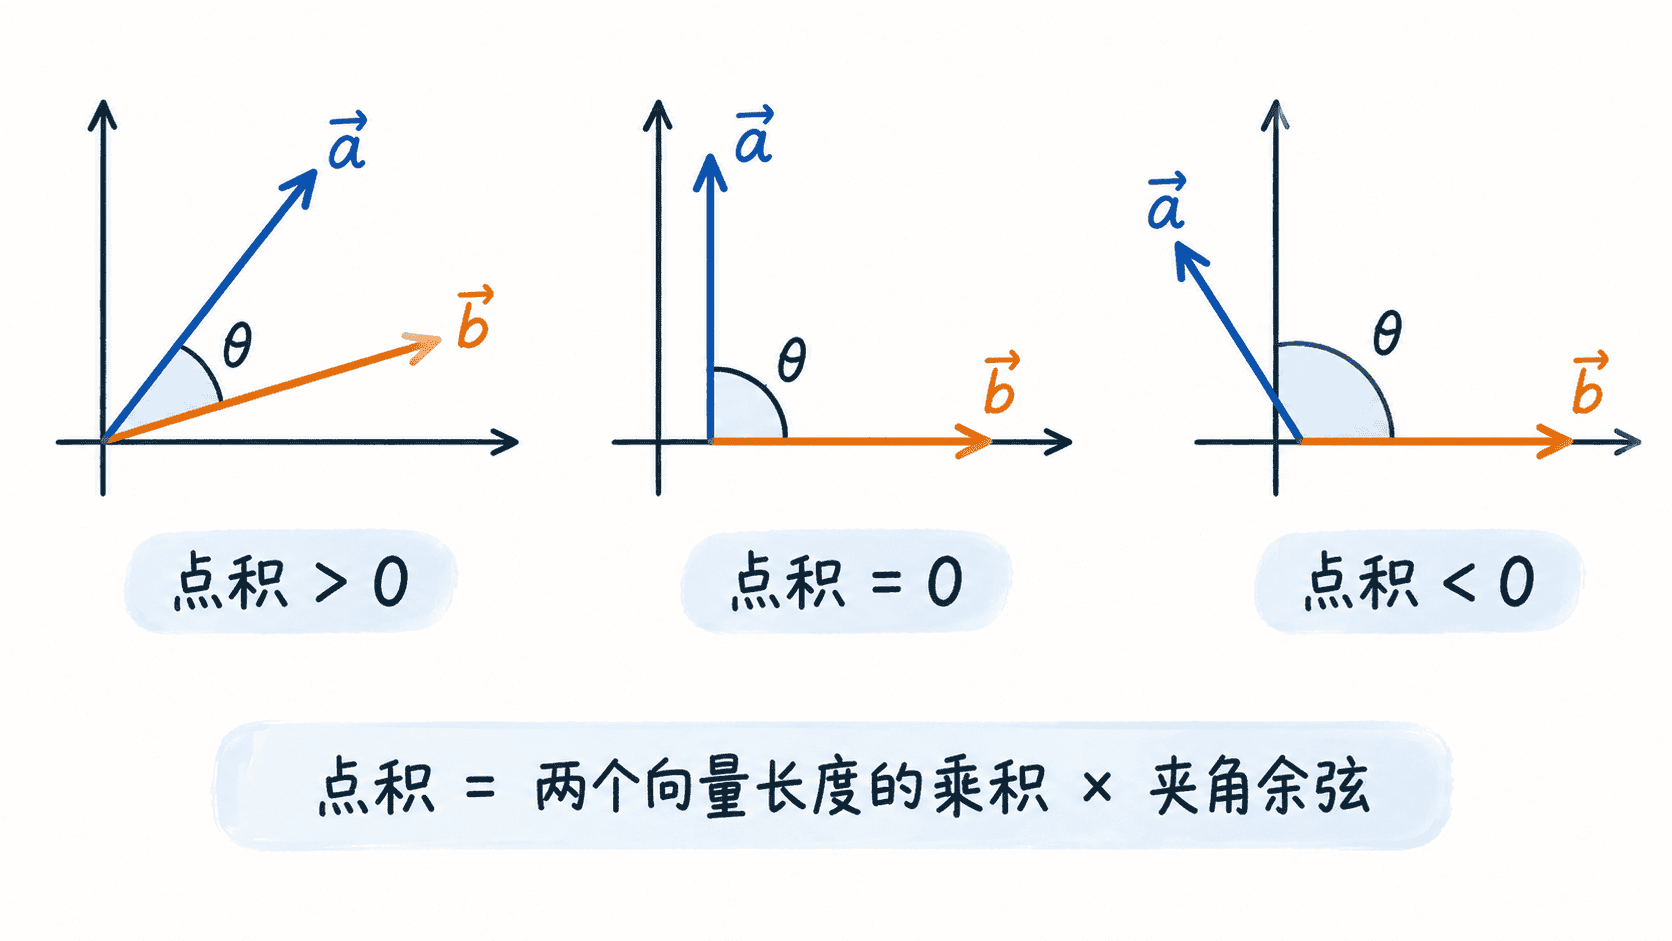
几何解释揭示了一个关键事实:点积同时受方向和长度影响。两个向量方向完全相同,但其中一个长度更大,点积也会更大。
点积与余弦相似度
余弦相似度会除去向量长度,只保留方向关系:
它的取值通常在 。当任务只关心方向是否相似,例如比较经过归一化的文本向量时,余弦相似度更直观。若向量长度本身也携带置信度、强度或激活规模,直接点积可能更合适。
零向量的长度为零,因此余弦相似度没有定义。实际系统通常会加入极小值避免除零,但这只是数值保护,不能让零向量获得有效方向。
注意力中的缩放点积
在注意力机制中,查询向量 与键向量 的相关性先计算为:
其中 是向量维度。除以 可以抑制高维点积随维度增大而变得过大的问题,避免 Softmax 过早饱和。
设 ,三个键分别为 、、。缩放前点积依次为 、、,除以 后再做 Softmax,可得到近似权重:
| 键 | 缩放后分数 | 注意力权重 |
|---|---|---|
权重最大的 与查询方向最一致,因此对应的值向量会对最终输出贡献更多。注意力并不是直接选择一个键,而是用归一化权重对多个值向量进行加权汇总。
判断结果时的边界
点积高不一定代表纯粹的方向相似,也可能只是向量范数较大。比较不同来源的向量时,应先确认是否做过归一化,以及长度是否具有业务含义。
注意力中的点积表示模型学习空间里的匹配程度,不等同于现实世界中的因果关系。分数还会受到投影矩阵、训练目标、掩码和 Softmax 的共同影响。
本课总结
- 点积是对应元素乘积之和,同时反映方向一致性与向量长度
- 余弦相似度通过归一化去除长度影响,零向量不能直接计算
- 缩放点积通过除以 稳定注意力分数,再由 Softmax 转成权重
下一课预告
下一课将把向量、矩阵乘法和点积放入更完整的张量计算中,继续分析 Transformer 如何组织批次、序列长度和特征维度。