
大模型原理与训练 / 系统课时
文本分类微调
文本分类微调
本课将把一组带标签的中文文本整理成可训练数据,使用预训练编码器完成二分类微调,并通过评估指标和单条推理验证模型是否真正具备分类能力。
学习目标
- 理解文本分类微调的数据、模型与损失计算链路
- 能使用
Trainer完成编码器分类模型的训练与评估 - 能识别数据泄漏、类别失衡和过拟合等常见问题
从分类任务到训练样本
文本分类的输入是一段完整文本,输出是一个离散类别。例如情感分类可以约定 0 表示负向、1 表示正向。训练集中的每条记录至少包含 text 与 label,标签必须从 0 开始连续编号,并与模型的 id2label、label2id 映射保持一致。
微调时,分词器先把文本转换为 input_ids 和 attention_mask;编码器生成整段文本的表示;分类头再输出每个类别的 logits。训练阶段使用真实标签计算交叉熵损失,反向传播会同时更新分类头和编码器参数。
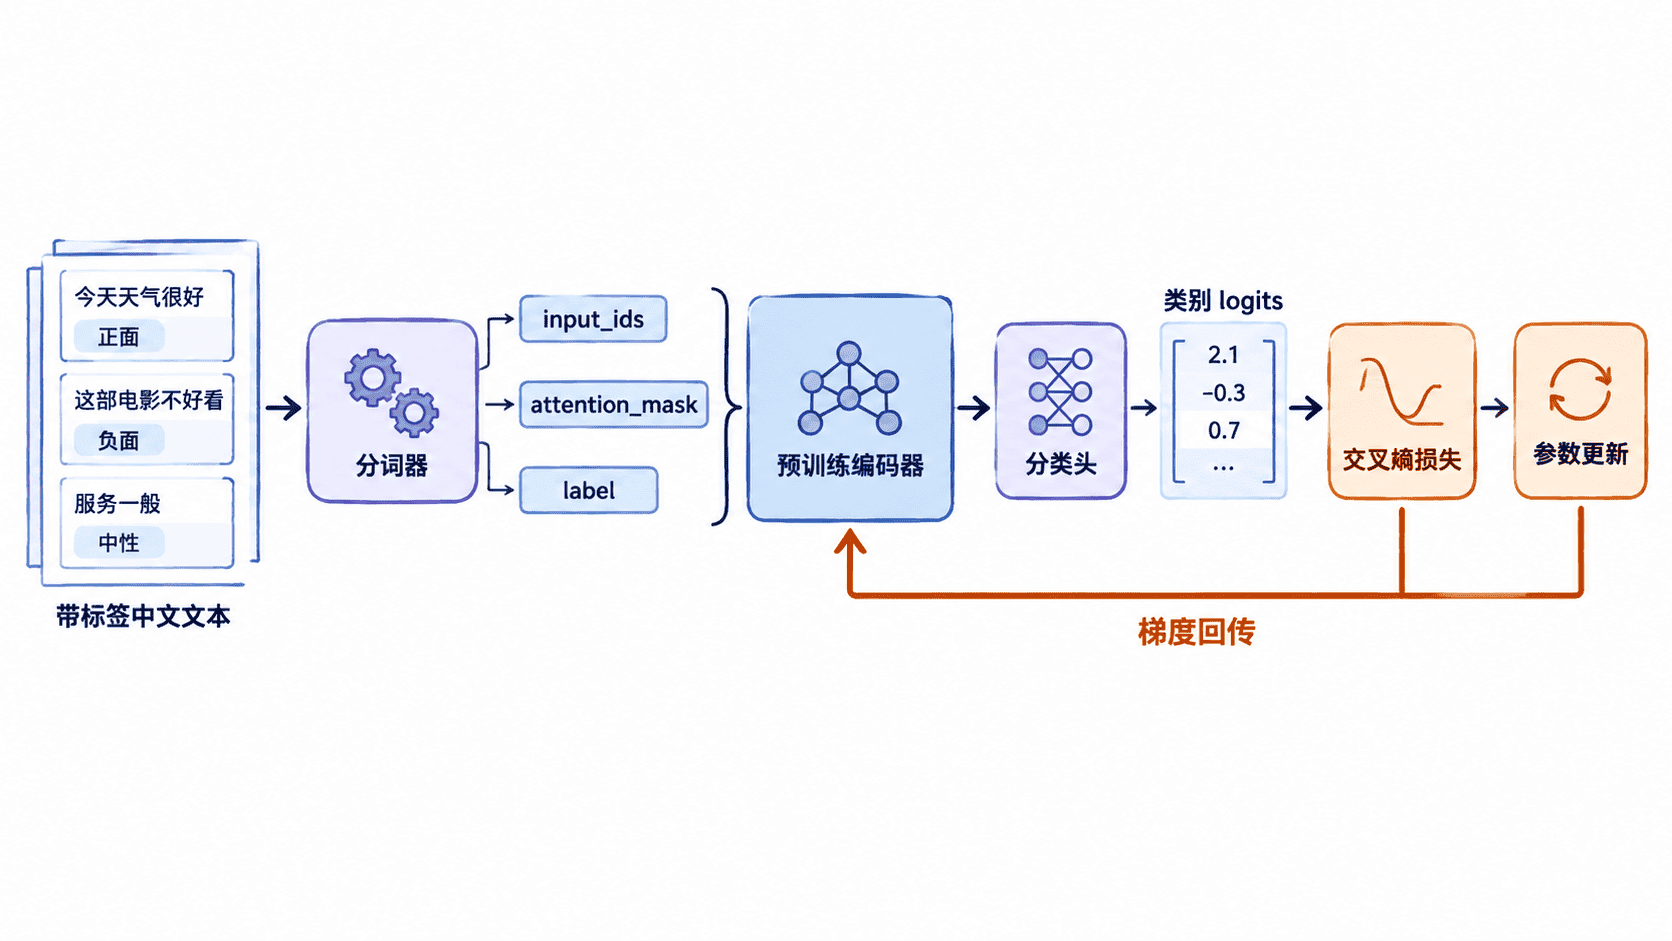
数据划分必须在分词和训练之前完成。训练集用于更新参数,验证集用于选择超参数和观察过拟合,测试集只在最终验收时使用。相同评论、同一用户的近重复文本或由同一原文切分出的片段,不应跨集合出现。
完成一次最小微调
下面使用一个小型中文情感数据集演示完整流程。示例能够运行,但样本只用于理解 API,不代表真实模型质量;正式项目应扩大数据量,并单独保留测试集。
先安装运行依赖:
python -m pip install torch transformers datasets accelerate预期结果:
Successfully installed <PACKAGES><PACKAGES> 的具体版本与安装日志取决于本机 Python 环境。
将以下代码保存为 train_text_classifier.py 后运行:
import numpy as np
import torch
from datasets import Dataset
from transformers import (
    AutoModelForSequenceClassification,
    AutoTokenizer,
    DataCollatorWithPadding,
    Trainer,
    TrainingArguments,
    set_seed,
)

MODEL_NAME = "bert-base-chinese"
ID2LABEL = {0: "负向", 1: "正向"}
LABEL2ID = {label: idx for idx, label in ID2LABEL.items()}

def build_dataset():
    data = {
        "text": [
            "商品质量很好,物流也很快",
            "客服耐心,问题很快解决",
            "包装完整,使用体验不错",
            "功能符合描述,值得购买",
            "到货后无法开机,非常失望",
            "等待时间太长,服务也不好",
            "实物与描述不符,要求退款",
            "质量很差,用了两天就坏了",
        ],
        "label": [1, 1, 1, 1, 0, 0, 0, 0],
    }
    return Dataset.from_dict(data).train_test_split(test_size=0.25, seed=42)

def compute_metrics(eval_pred):
    logits, labels = eval_pred
    predictions = np.argmax(logits, axis=-1)
    accuracy = float((predictions == labels).mean())
    return {"accuracy": accuracy}

def main():
    set_seed(42)
    dataset = build_dataset()
    tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)

    def tokenize(batch):
        return tokenizer(batch["text"], truncation=True, max_length=128)

    tokenized = dataset.map(tokenize, batched=True)
    model = AutoModelForSequenceClassification.from_pretrained(
        MODEL_NAME,
        num_labels=2,
        id2label=ID2LABEL,
        label2id=LABEL2ID,
    )

    args = TrainingArguments(
        output_dir="./text-classifier-output",
        learning_rate=2e-5,
        per_device_train_batch_size=4,
        per_device_eval_batch_size=4,
        num_train_epochs=3,
        weight_decay=0.01,
        eval_strategy="epoch",
        save_strategy="no",
        logging_strategy="no",
        disable_tqdm=True,
        report_to="none",
    )

    trainer = Trainer(
        model=model,
        args=args,
        train_dataset=tokenized["train"],
        eval_dataset=tokenized["test"],
        data_collator=DataCollatorWithPadding(tokenizer=tokenizer),
        processing_class=tokenizer,
        compute_metrics=compute_metrics,
    )

    trainer.train()
    metrics = trainer.evaluate()
    print(f"eval_accuracy={metrics['eval_accuracy']:.4f}")

    inputs = tokenizer(
        "物流很快,商品也很好",
        return_tensors="pt",
        truncation=True,
        max_length=128,
    )
    inputs = {name: value.to(trainer.model.device) for name, value in inputs.items()}

    trainer.model.eval()
    with torch.no_grad():
        logits = trainer.model(**inputs).logits
        probabilities = torch.softmax(logits, dim=-1)[0]

    predicted_id = int(torch.argmax(probabilities).item())
    print(f"预测标签={ID2LABEL[predicted_id]}")
    print(f"置信度={float(probabilities[predicted_id]):.4f}")

if __name__ == "__main__":
    main()
预期输出:
eval_accuracy=<ACCURACY>
预测标签=<LABEL>
置信度=<PROBABILITY>
<ACCURACY> 和 <PROBABILITY> 会随硬件、依赖版本与训练结果变化,<LABEL> 应为“正向”或“负向”。首次运行还会下载模型文件,下载进度不属于训练结果。
评估结果应该怎样看
准确率适合类别较均衡的单标签分类,但不能单独说明模型可靠。当正负样本比例悬殊时,一个始终预测多数类的模型也可能获得较高准确率,此时还应查看每一类的精确率、召回率、F1 值和混淆矩阵。
训练损失持续下降而验证指标开始变差,通常说明模型正在记忆训练样本。可优先减少训练轮数、增加数据、使用权重衰减或提前停止,而不是盲目增大学习率。验证指标异常接近满分时,应先排查重复样本和数据泄漏。
关键边界与验收
推理时必须复用训练阶段的分词器、最大长度和标签映射。若线上重新定义标签顺序,即使模型参数不变,也会把正确 logits 解释成错误类别。保存模型时应同时保存分词器和配置,部署前再用固定样例执行回归测试。
最小验收应包含三部分:训练过程能够结束且损失为有限值;验证集指标能够计算;至少准备一条明显正向和一条明显负向文本检查输出格式。真实项目还要补充空文本、超长文本、混合语言和领域外文本。
本课总结
- 文本分类微调由标签数据、分词器、编码器和分类头共同构成
- 训练、验证与测试数据必须隔离,标签映射必须在训练和推理阶段保持一致
- 单一准确率不足以证明模型可用,还要结合类别分布和错误样本分析
下一课预告
下一课将把分类粒度从整段文本推进到每个词元,重点解决原始词语与子词词元之间的标签对齐问题。