
大模型原理与训练 / 系统课时
推理模式与设备管理
推理模式与设备管理
本课解决模型部署中最常见的四类问题:推理结果不稳定、张量设备不一致、数据类型选择错误以及显存无法及时回收。完成后,你将得到一套可直接复用的单条推理模板,并能判断每个设置实际解决什么问题。
学习目标
- 正确组合
model.eval()与torch.inference_mode() - 根据 CPU 或 CUDA 设备选择张量位置和计算类型
- 在推理结束后释放引用并验证显存是否可复用
推理状态的职责边界
model.eval() 会把 Dropout、BatchNorm 等模块切换到推理行为,但不会关闭自动求导。torch.inference_mode() 负责停止构建计算图,并进一步减少版本计数等运行开销。二者解决的问题不同,部署代码通常需要同时使用。
| 设置 | 主要作用 | 是否关闭梯度记录 |
|---|---|---|
model.eval() |
切换模型层的推理行为 | 否 |
torch.no_grad() |
不记录反向传播图 | 是 |
torch.inference_mode() |
面向纯推理的更低开销模式 | 是 |
当推理期间还要临时修改张量并参与后续求导时,应使用 torch.no_grad();当整个代码块只做预测时,优先使用 torch.inference_mode()。
设备与数据类型如何配合
模型参数、输入张量和新建的辅助张量必须位于同一设备。CPU 推理通常保留 float32;CUDA 推理可优先尝试 float16,支持较好的新型 GPU 也可评估 bfloat16。类型选择必须以模型兼容性和实际精度验证为准,不能只根据显存占用决定。
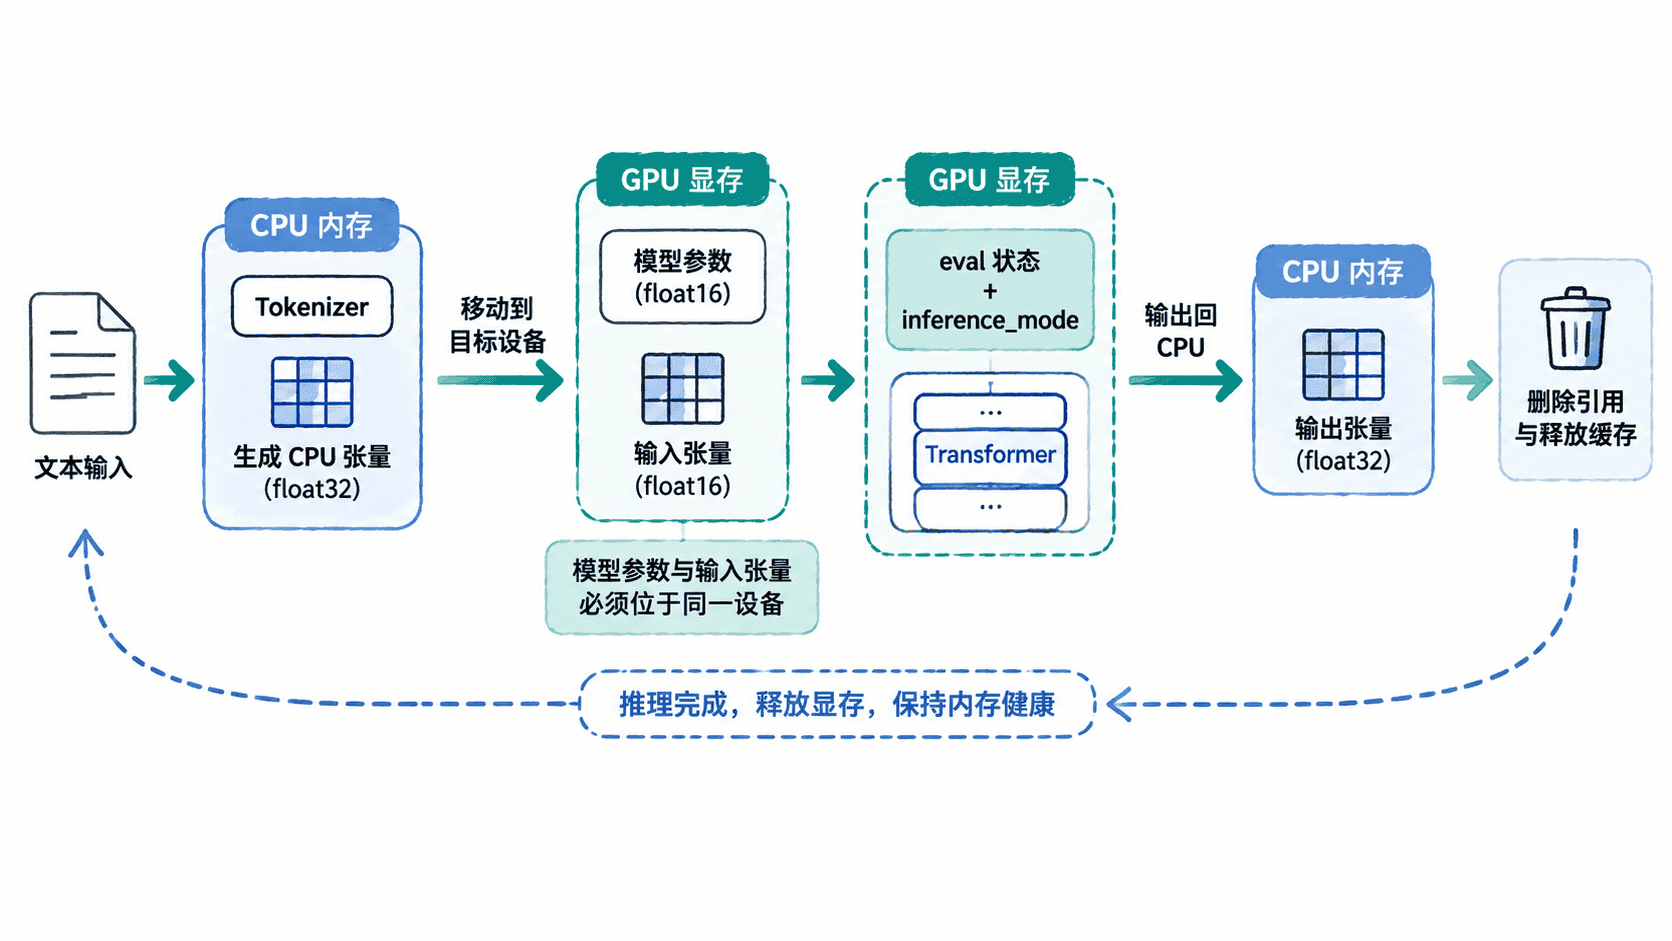
需要注意,半精度并不等于任何设备都更快。多数 CPU 对 float16 的支持有限,盲目转换可能变慢或触发算子不支持;而 GPU 上的自动混合精度只应包围模型前向过程,不要把分词和普通 Python 逻辑放入其中。
完整推理示例
下面使用一个已经微调好的情感分类模型。代码会自动选择 CUDA 或 CPU,在 CUDA 上使用半精度,并在预测结束后删除主要张量引用。
from contextlib import nullcontext
import gc

import torch
from transformers import AutoModelForSequenceClassification, AutoTokenizer

MODEL_NAME = "distilbert-base-uncased-finetuned-sst-2-english"
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model_dtype = torch.float16 if device.type == "cuda" else torch.float32

tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)
model = AutoModelForSequenceClassification.from_pretrained(MODEL_NAME)

# 模型和输入必须移动到同一设备;CPU 保持 float32。
model = model.to(device=device, dtype=model_dtype)
model.eval()

inputs = tokenizer(
    "The deployment process is clear and reliable.",
    return_tensors="pt",
    truncation=True,
)
inputs = {name: tensor.to(device) for name, tensor in inputs.items()}

# 自动混合精度只在 CUDA 前向计算中启用。
amp_context = (
    torch.autocast(device_type="cuda", dtype=torch.float16)
    if device.type == "cuda"
    else nullcontext()
)

with torch.inference_mode():
    with amp_context:
        logits = model(**inputs).logits

label_id = int(logits.argmax(dim=-1).item())
label = model.config.id2label[label_id]

print(f"device={device.type}")
print(f"model_dtype={next(model.parameters()).dtype}")
print(f"predicted_label={label}")

# 删除仍指向显存的对象后,再请求缓存分配器归还可复用块。
del inputs, logits, model
gc.collect()
if device.type == "cuda":
    torch.cuda.empty_cache()
print("cleanup_requested=true")预期输出如下。device 和 model_dtype 会随运行环境变化,首次运行还会下载模型文件。
device=<cpu|cuda>
model_dtype=<torch.float32|torch.float16>
predicted_label=POSITIVE
cleanup_requested=true
显存释放与验收
torch.cuda.empty_cache() 只会释放缓存分配器中当前未被张量引用的显存,不会强制销毁仍在使用的模型或张量。因此,释放顺序应是先结束请求、删除引用,再调用垃圾回收和缓存清理。长期服务通常不应在每次请求后调用它,否则可能增加重复分配成本。
验收时至少检查三项:同一输入连续推理的标签是否稳定,模型参数与输入张量是否在同一设备,以及多轮请求后显存是否进入稳定区间而不是持续增长。若出现 Expected all tensors to be on the same device,应先打印模型参数和每个输入张量的 device,而不是直接增加显存。
本课总结
model.eval()控制层行为,torch.inference_mode()控制梯度与推理开销,二者通常同时使用- 模型、输入和辅助张量必须位于同一设备,数据类型要结合硬件与精度验证选择
- 显存释放的关键是先移除对象引用,
empty_cache()不能回收仍被引用的张量
下一课预告
下一课将把单条推理扩展为批量推理,使用动态填充和长度分组减少无效计算,并讨论吞吐量与请求延迟之间的工程取舍。