
大模型原理与训练 / 系统课时
填充掩码
填充掩码
批量处理不同长度的序列时,较短样本会被补上填充标记。本课将把这些位置从注意力计算中排除,并用 PyTorch 验证被屏蔽位置的注意力权重确实为零。
学习目标
- 解释填充位置为什么会干扰自注意力结果
- 掌握掩码加入注意力分数的计算方式
- 实现并验证可复用的填充掩码代码
为什么需要填充掩码
同一批次中的序列通常要对齐到相同长度。例如长度为 3 和 5 的两个句子会被整理成长度为 5 的张量,较短句子的末尾补两个填充标记。填充标记只服务于张量对齐,本身不包含语义。
如果直接计算注意力,真实词元仍可能把一部分权重分配给填充位置。更严重的是,填充值经过线性投影后不一定仍为零,因此会污染加权求和结果。填充掩码的任务,就是让所有查询位置都无法关注这些无效键。
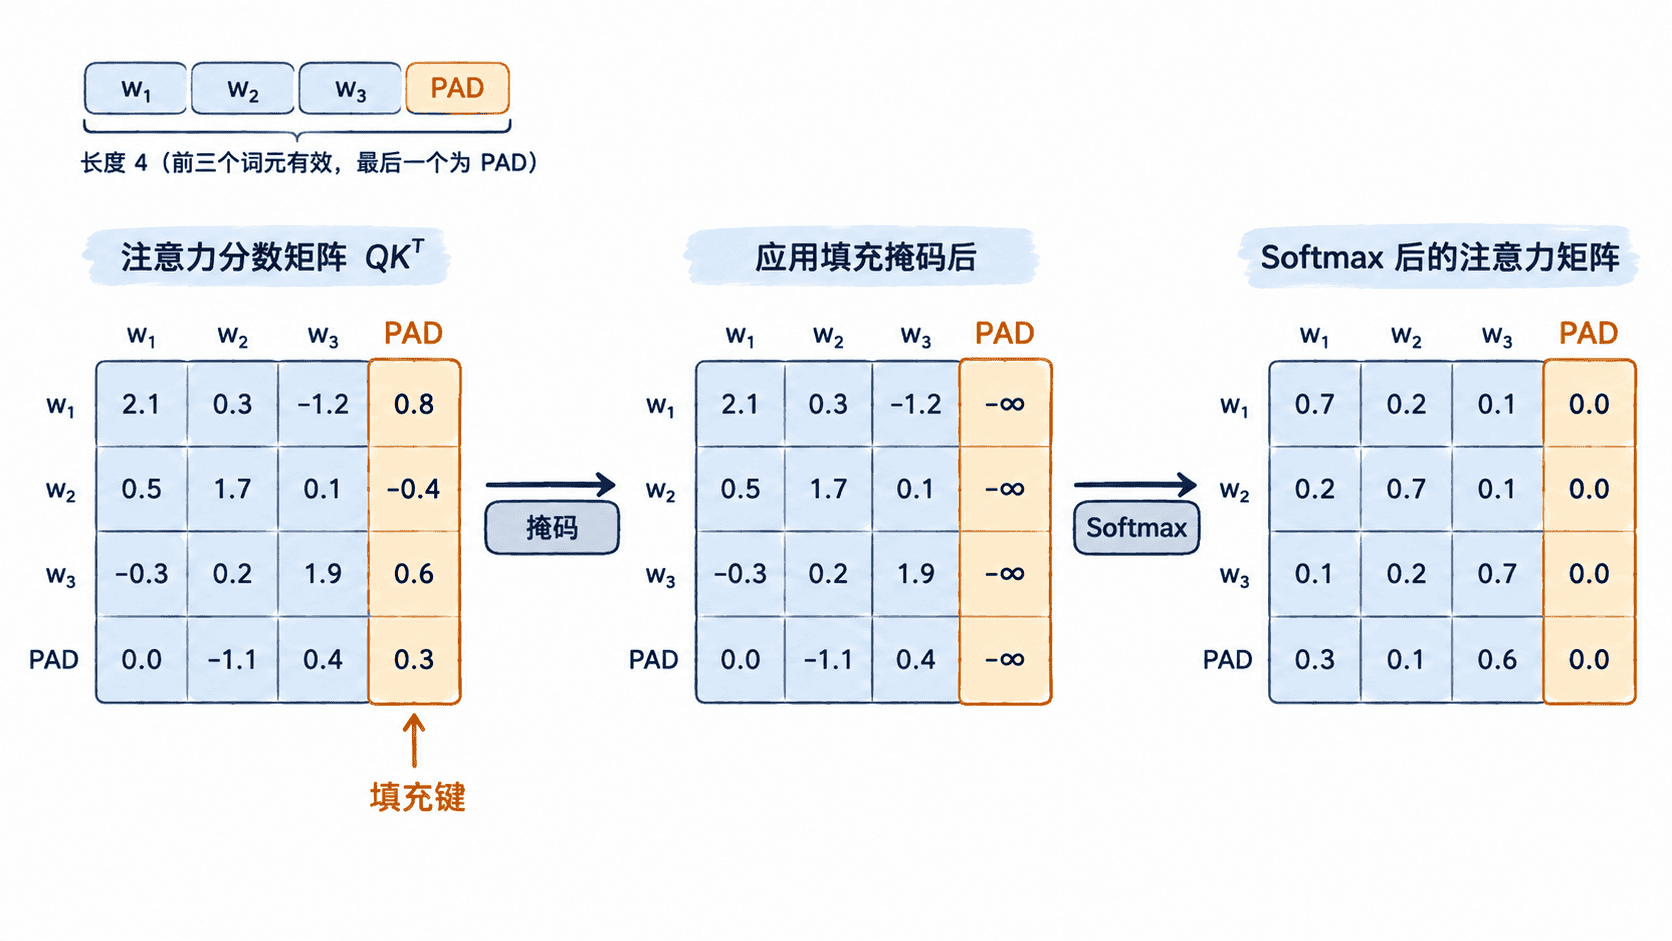
掩码如何改变注意力分数
缩放点积注意力先计算分数,再做 Softmax。加入掩码后的核心形式为:
对于有效键, 取 0;对于填充键, 取负无穷。Softmax 会把这些位置的指数值压到 0,因此它们既不会获得注意力权重,也不会参与最终的加权求和。
工程中常把掩码保存为布尔张量。下面约定 True 表示有效键,形状为 [batch_size, sequence_length]。计算时扩展为 [batch_size, 1, sequence_length],使同一批次内的所有查询共享同一组键掩码。
PyTorch 实现与验证
下面的完整示例手写缩放点积注意力。最后一个值向量故意设置为很大的数;若掩码失效,它会明显污染输出,因此便于验证。
import math

import torch

def scaled_dot_product_attention(
    q: torch.Tensor,
    k: torch.Tensor,
    v: torch.Tensor,
    key_padding_mask: torch.Tensor | None = None,
) -> tuple[torch.Tensor, torch.Tensor]:
    scores = q @ k.transpose(-2, -1) / math.sqrt(q.size(-1))

    if key_padding_mask is not None:
        # 掩码描述键是否有效,并广播到全部查询位置
        scores = scores.masked_fill(
            ~key_padding_mask[:, None, :],
            float("-inf"),
        )

    weights = torch.softmax(scores, dim=-1)
    output = weights @ v
    return output, weights

torch.set_printoptions(precision=4, sci_mode=False)

q = torch.tensor([[
    [1.0, 0.0],
    [0.0, 1.0],
    [1.0, 1.0],
    [0.0, 0.0],
]])
k = q.clone()
v = torch.tensor([[
    [10.0, 0.0],
    [0.0, 10.0],
    [10.0, 10.0],
    [999.0, 999.0],
]])

valid_keys = torch.tensor([[True, True, True, False]])
output, weights = scaled_dot_product_attention(q, k, v, valid_keys)

print("attention weights:")
print(weights)
print("output shape:", output.shape)
print("padded key column:", weights[..., -1])
预期输出:
attention weights:
tensor([[[0.4011, 0.1978, 0.4011, 0.0000],
         [0.1978, 0.4011, 0.4011, 0.0000],
         [0.2483, 0.2483, 0.5035, 0.0000],
         [0.3333, 0.3333, 0.3333, 0.0000]]])
output shape: torch.Size([1, 4, 2])
padded key column: tensor([[0., 0., 0., 0.]])
最后一列全部为 0,说明数值为 999 的填充向量没有参与任何输出。实际浮点显示位数可能随 PyTorch 版本略有差异,但形状和被屏蔽列应保持一致。
关键边界
键掩码只阻止其他位置读取填充键,并不会自动删除填充查询产生的输出。编码器通常会在后续层继续传递掩码,或在损失计算时忽略填充位置;需要严格保持零值时,也可以在注意力输出后再次按查询掩码清零。
若某一行的全部键都被屏蔽,Softmax 会面对全负无穷并可能产生 NaN。构造批次时应保证每个有效样本至少保留一个可关注位置,并检查掩码语义是“有效为 True”还是“屏蔽为 True”,避免逻辑取反错误。
本课总结
- 填充掩码通过屏蔽无效键,防止填充内容进入注意力加权结果
- 布尔掩码需要扩展到分数矩阵的键维度,再用负无穷参与 Softmax
- 验证时应同时检查被屏蔽列是否为零、输出形状是否正确
下一课预告
下一课将把线性投影、缩放点积、掩码和输出投影组合起来,手写一个完整的单头自注意力层。