
大模型原理与训练 / 系统课时
LoRA 微调实践
LoRA 微调实践
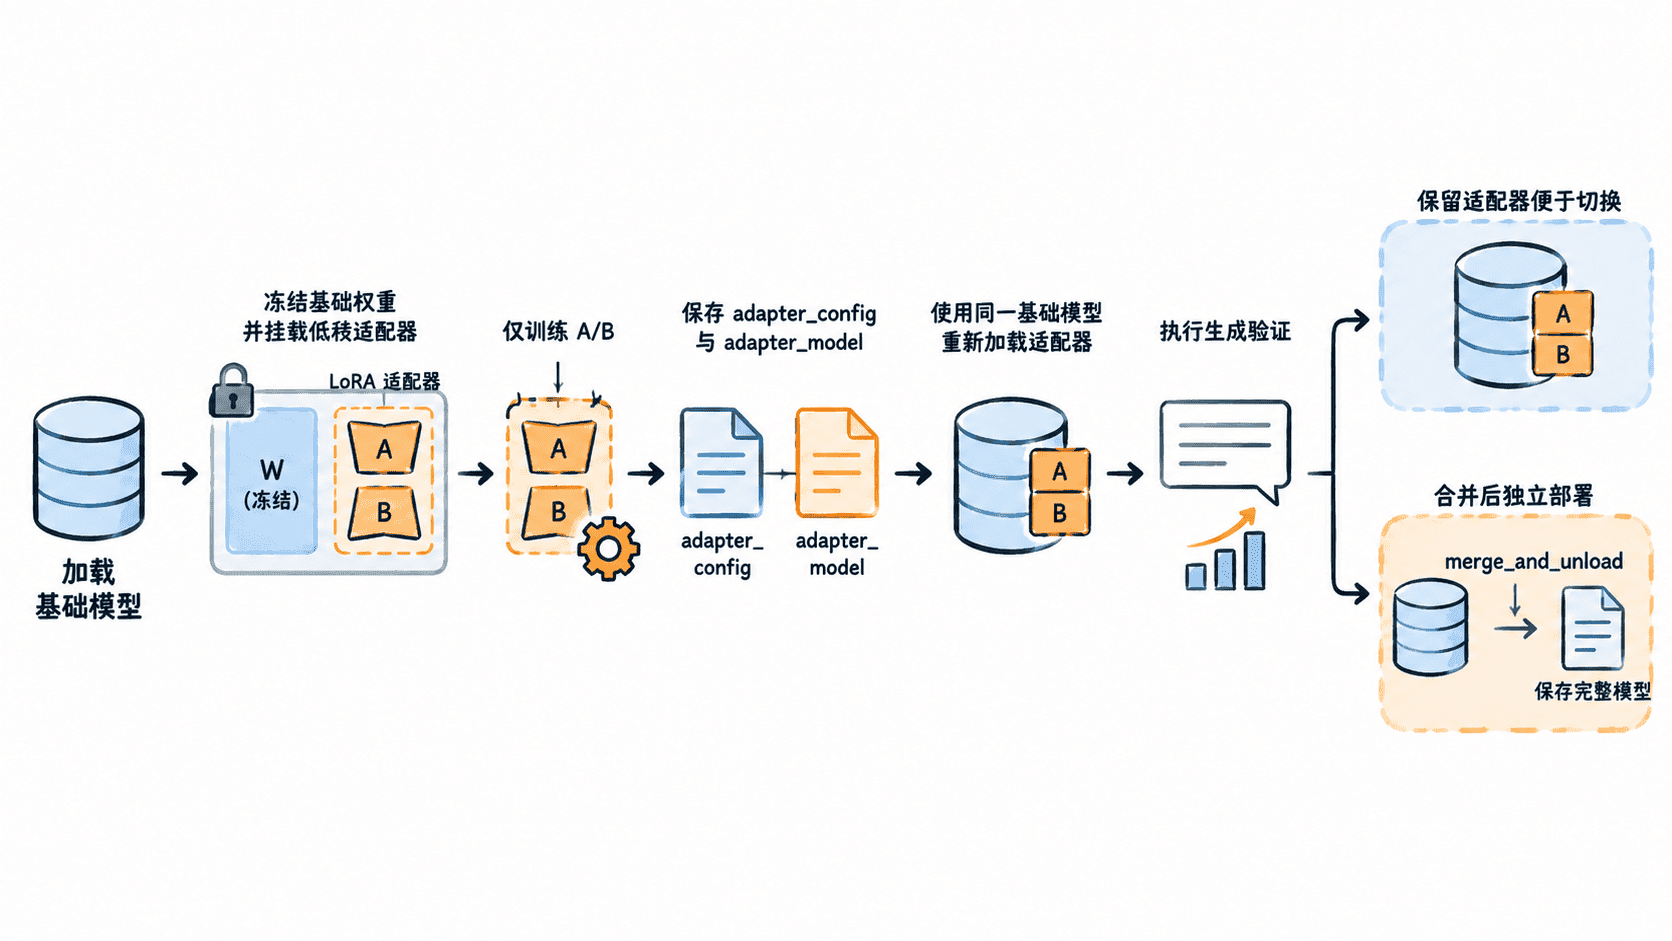
本课用一个小型因果语言模型完成 LoRA 的完整闭环:选择目标层和秩参数,训练适配器,保存后重新加载,并将增量权重合并为可独立部署的模型。
学习目标
- 能为 GPT-2 类模型选择 LoRA 目标模块和基础超参数
- 完成适配器训练、保存、加载与生成验证
- 理解合并模型的用途、限制和验收方式
实践目标与参数选择
示例使用 distilgpt2,在其注意力模块 c_attn 上挂载 LoRA。GPT-2 的 c_attn 将查询、键和值投影打包在同一模块中,因此只指定这个名称就能覆盖注意力输入投影。
本次取 r=8、lora_alpha=16、lora_dropout=0.05。这是一组适合入门验证的起点,不是所有任务的固定答案。秩越大,可训练容量和显存占用通常越高;目标层越多,适配范围越广,但训练参数也会增加。
准备运行环境
在独立虚拟环境中安装所需库,并用一条导入检查确认依赖可用。安装过程中的版本号和下载日志会随环境变化,最后的检查标记应保持一致。
python -m pip install -U transformers peft datasets accelerate
python -c "import transformers, peft, datasets, accelerate; print('dependencies-ok')"
预期输出
dependencies-ok完整训练、保存、加载与合并
下面的脚本构造四条极小训练样本,只用于验证 LoRA 工作流,不代表真实数据规模。训练完成后会保存适配器,重新加载同一基础模型进行固定长度生成,最后合并并保存完整模型。
from pathlib import Path

import torch
from datasets import Dataset
from peft import LoraConfig, PeftModel, TaskType, get_peft_model
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    DataCollatorForLanguageModeling,
    Trainer,
    TrainingArguments,
)

MODEL_NAME = "distilgpt2"
ADAPTER_DIR = Path("artifacts/lora-adapter")
MERGED_DIR = Path("artifacts/merged-model")

def build_dataset(tokenizer: AutoTokenizer) -> Dataset:
    samples = {
        "text": [
            "Question: What is LoRA?\nAnswer: LoRA learns a low-rank weight update.",
            "Question: Which weights are frozen?\nAnswer: The pretrained base weights are frozen.",
            "Question: What is saved?\nAnswer: The adapter weights and configuration are saved.",
            "Question: Why merge adapters?\nAnswer: Merging creates a standalone model for deployment.",
        ]
    }
    dataset = Dataset.from_dict(samples)

    def tokenize(batch):
        return tokenizer(batch["text"], truncation=True, max_length=64)

    return dataset.map(tokenize, batched=True, remove_columns=["text"])

def main() -> None:
    tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)
    tokenizer.pad_token = tokenizer.eos_token

    base_model = AutoModelForCausalLM.from_pretrained(MODEL_NAME)
    base_model.config.pad_token_id = tokenizer.pad_token_id

    # GPT-2 的 c_attn 同时承载 Q、K、V 投影。
    lora_config = LoraConfig(
        task_type=TaskType.CAUSAL_LM,
        r=8,
        lora_alpha=16,
        lora_dropout=0.05,
        target_modules=["c_attn"],
        bias="none",
    )
    model = get_peft_model(base_model, lora_config)

    trainable = sum(p.numel() for p in model.parameters() if p.requires_grad)
    total = sum(p.numel() for p in model.parameters())
    print("trainable_less_than_total:", trainable < total)

    train_dataset = build_dataset(tokenizer)
    data_collator = DataCollatorForLanguageModeling(
        tokenizer=tokenizer,
        mlm=False,
    )
    training_args = TrainingArguments(
        output_dir="artifacts/trainer-output",
        per_device_train_batch_size=2,
        num_train_epochs=1,
        learning_rate=2e-4,
        logging_strategy="no",
        save_strategy="no",
        report_to="none",
        disable_tqdm=True,
        seed=42,
    )
    trainer = Trainer(
        model=model,
        args=training_args,
        train_dataset=train_dataset,
        data_collator=data_collator,
    )
    trainer.train()

    # 适配器目录只保存 LoRA 增量和对应配置。
    model.save_pretrained(ADAPTER_DIR)
    tokenizer.save_pretrained(ADAPTER_DIR)
    print(
        "adapter_saved:",
        (ADAPTER_DIR / "adapter_config.json").exists(),
    )

    loaded_base = AutoModelForCausalLM.from_pretrained(MODEL_NAME)
    loaded_base.config.pad_token_id = tokenizer.pad_token_id
    loaded_model = PeftModel.from_pretrained(loaded_base, ADAPTER_DIR)
    print("loaded_rank:", loaded_model.peft_config["default"].r)

    prompt = "Question: What is LoRA?\nAnswer:"
    inputs = tokenizer(prompt, return_tensors="pt")
    loaded_model.eval()
    with torch.no_grad():
        output_ids = loaded_model.generate(
            **inputs,
            do_sample=False,
            max_new_tokens=4,
            min_new_tokens=4,
            pad_token_id=tokenizer.eos_token_id,
        )
    new_tokens = output_ids.shape[1] - inputs["input_ids"].shape[1]
    print("generated_new_tokens:", new_tokens)

    # 合并后返回普通基础模型对象,适合独立部署。
    merged_model = loaded_model.merge_and_unload()
    merged_model.save_pretrained(MERGED_DIR)
    tokenizer.save_pretrained(MERGED_DIR)
    print("merged_is_peft_model:", isinstance(merged_model, PeftModel))
    print("merged_saved:", (MERGED_DIR / "config.json").exists())

if __name__ == "__main__":
    main()
预期输出
trainable_less_than_total: True
adapter_saved: True
loaded_rank: 8
generated_new_tokens: 4
merged_is_peft_model: False
merged_saved: True
模型下载和训练框架可能额外输出进度、警告或耗时信息;上面六行是脚本显式打印的验收标记。首次运行需要能够访问模型仓库,实际缓存路径和训练耗时会因环境而异。
如何调整目标层和秩
不同架构的模块名不同,target_modules 必须与模型真实层名匹配。GPT-2 类模型常见 c_attn;LLaMA、Mistral 等架构常从 q_proj、v_proj 起步,需要更强容量时再评估 k_proj、o_proj 或前馈层。
| 调整项 | 适合的起点 | 调整依据 |
|---|---|---|
r |
8 或 16 | 欠拟合时逐步增大,显存紧张或数据很少时保持较小 |
lora_alpha |
与 r 同量级或约为其两倍 |
观察训练稳定性与验证集效果,不单独追求更大数值 |
lora_dropout |
0~0.1 | 数据少、过拟合明显时适当增加 |
target_modules |
先覆盖注意力投影 | 容量不足时再扩展,不要一次挂载所有线性层 |
目标模块名称不匹配时,PEFT 通常会报告找不到目标层。此时应检查模型结构,而不是盲目更换秩或学习率。
加载与合并的边界
适配器必须配合训练时使用的同一基础模型版本和兼容的分词器加载。只分发适配器时,文件小、任务切换方便;合并后得到完整模型,部署简单,但会失去动态切换适配器的优势。
merge_and_unload() 会把当前适配器增量写入基础权重。合并前应保留原适配器目录,量化训练场景还要确认权重精度和量化格式是否支持直接合并;不确定时,可重新加载兼容的浮点基础模型后再执行合并。
验收检查
完成实践后,应确认三个结果:适配器目录存在 adapter_config.json,重新加载后读取到的秩仍为 8,合并目录存在完整模型配置。生成文本本身会受模型和训练数据影响,因此本例用新增词元数量验证推理链路是否真正执行。
本课总结
- 目标层名称由模型架构决定,秩和缩放系数应从小规模验证开始调整
- 适配器保存与重新加载依赖同一基础模型,适合多任务复用
- 合并会生成独立模型,但应保留适配器并单独验证精度与部署格式
下一课预告
下一课将继续比较不同生成策略,观察温度、Top-k、Top-p 与重复惩罚如何改变模型输出的稳定性和多样性。