
大模型原理与训练 / 系统课时
服务监控与日志
服务监控与日志
本课搭建一个最小可用的模型服务观测方案:用结构化日志记录每次请求,用指标统计流量、延迟和错误,并把资源状态纳入告警,最终能够快速回答“服务是否正常、哪里变慢、为什么失败”。
学习目标
- 区分请求日志、业务指标和资源指标的职责
- 为模型接口加入请求编号、耗时、状态码和错误记录
- 根据服务目标设置可验证的监控与告警条件
监控模型服务的四条信号
模型服务至少要持续观察流量、延迟、错误和资源饱和度。日志负责还原单次请求,指标负责发现整体趋势;二者必须通过同一个请求编号关联,才能从告警快速定位到具体调用。
| 信号 | 典型内容 | 主要用途 |
|---|---|---|
| 流量 | 请求数、并发数、输入长度 | 判断负载变化 |
| 延迟 | 平均值、P95、P99 | 发现慢请求和容量不足 |
| 错误 | 4xx、5xx、超时、模型异常 | 判断失败类型 |
| 资源 | CPU、内存、显存、队列长度 | 识别服务饱和 |
日志中不要直接保存完整提示词、令牌或个人信息。确需排查内容问题时,应记录脱敏摘要、长度、哈希或样本编号,并控制访问权限和保留周期。
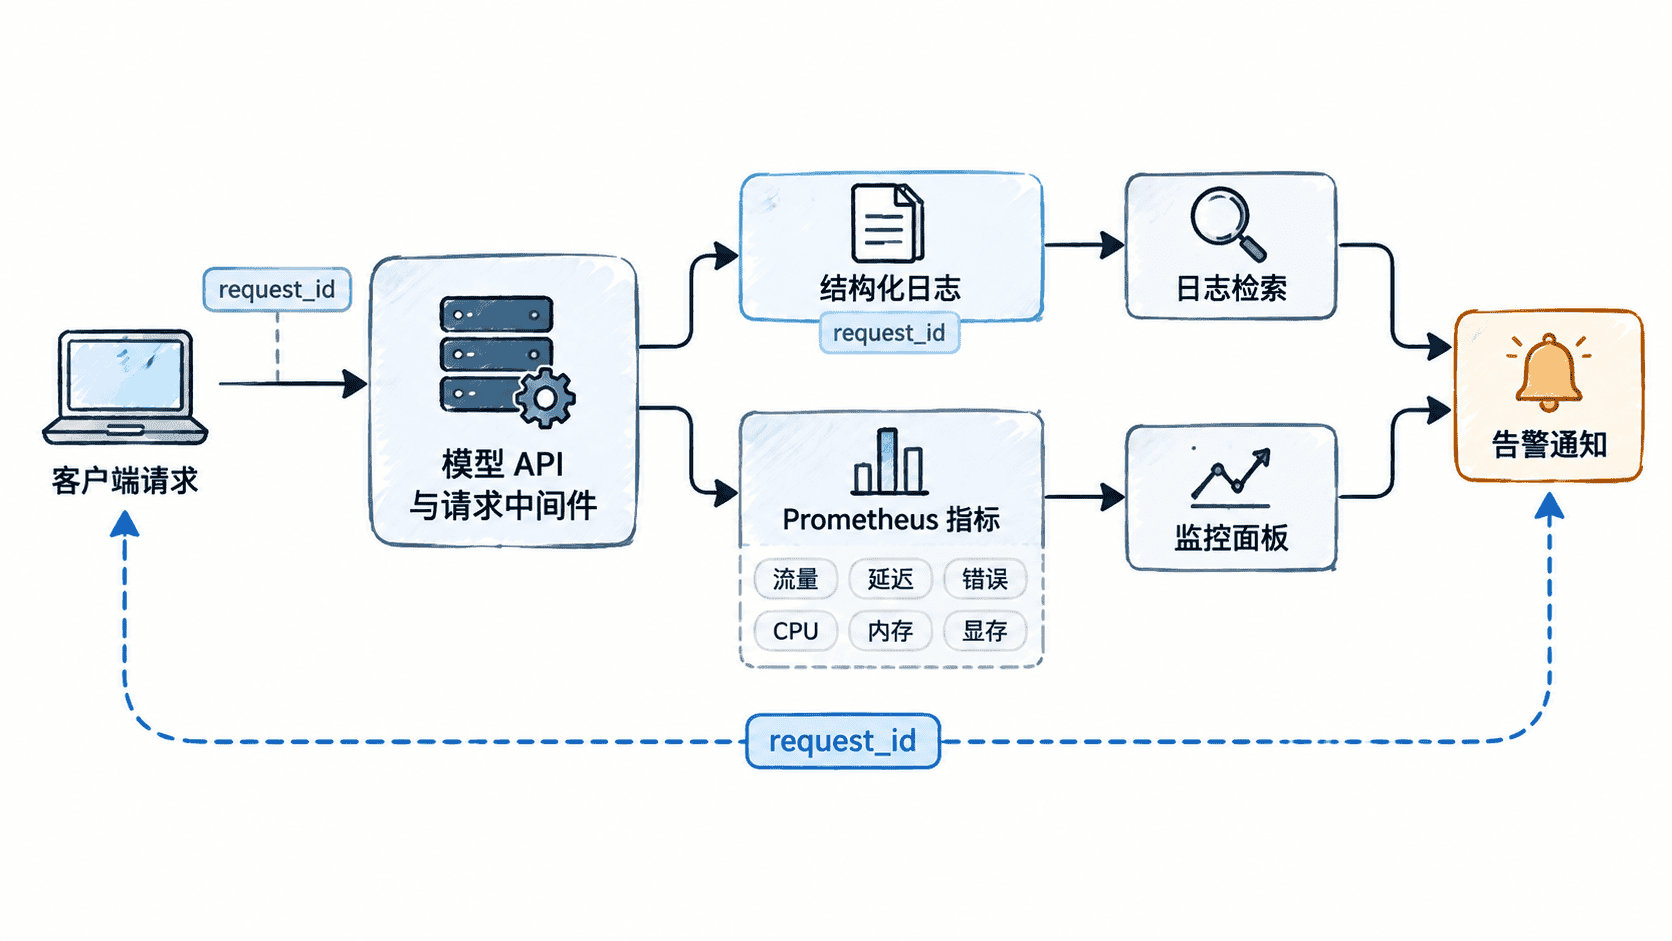
实现结构化日志与请求指标
下面使用 FastAPI 和 prometheus_client 实现完整示例。中间件为每个请求生成或复用 X-Request-Id,在请求结束时统一记录方法、路径、状态码和耗时,同时更新 Prometheus 计数器与直方图。
python
import json
import logging
import time
import uuid

from fastapi import FastAPI, Request, Response
from pydantic import BaseModel
from prometheus_client import CONTENT_TYPE_LATEST, Counter, Histogram, generate_latest

logging.basicConfig(level=logging.INFO, format="%(message)s")
logger = logging.getLogger("model-service")

app = FastAPI()
requests_total = Counter(
    "model_requests_total",
    "Total model API requests",
    ["method", "path", "status"],
)
request_latency = Histogram(
    "model_request_latency_seconds",
    "Model API request latency",
    ["path"],
)

class GenerateRequest(BaseModel):
    text: str

@app.middleware("http")
async def observe_request(request: Request, call_next):
    request_id = request.headers.get("X-Request-Id", str(uuid.uuid4()))
    started = time.perf_counter()
    status_code = 500
    error_type = None

    try:
        response = await call_next(request)
        status_code = response.status_code
        response.headers["X-Request-Id"] = request_id
        return response
    except Exception as exc:
        error_type = type(exc).__name__
        raise
    finally:
        elapsed = time.perf_counter() - started
        requests_total.labels(request.method, request.url.path, str(status_code)).inc()
        request_latency.labels(request.url.path).observe(elapsed)
        logger.info(json.dumps({
            "request_id": request_id,
            "method": request.method,
            "path": request.url.path,
            "status": status_code,
            "latency_ms": round(elapsed * 1000, 2),
            "error_type": error_type,
        }, ensure_ascii=False))

@app.post("/generate")
async def generate(payload: GenerateRequest):
    result = payload.text.strip()
    return {"text": result, "length": len(result)}

@app.get("/metrics")
async def metrics():
    return Response(generate_latest(), media_type=CONTENT_TYPE_LATEST)
预期结果
text
app.py 可被正常加载;服务启动后提供 POST /generate 和 GET /metrics 两个端点。将代码保存为 app.py 后安装依赖并启动服务:
bash
python -m pip install --quiet fastapi uvicorn prometheus-client
python -m uvicorn app:app --host 0.0.0.0 --port 8000
预期输出
text
INFO: Uvicorn running on http://0.0.0.0:8000发送一次带固定请求编号的测试请求:
bash
curl -s -X POST http://127.0.0.1:8000/generate -H 'Content-Type: application/json' -H 'X-Request-Id: demo-001' -d '{"text":"hello world"}'预期输出
json
{"text":"hello world","length":11}控制台同时会出现一条 JSON 日志,其中耗时会随机器变化:
text
{"request_id":"demo-001","method":"POST","path":"/generate","status":200,"latency_ms":<TIME>,"error_type":null}再读取指标端点:
bash
curl -s http://127.0.0.1:8000/metrics | grep 'model_request'预期输出
text
model_requests_total{method="POST",path="/generate",status="200"} 1.0
model_request_latency_seconds_count{path="/generate"} 1.0
model_request_latency_seconds_sum{path="/generate"} <TIME>
<TIME> 是动态耗时,实际值不同属于正常现象。生产环境还应由容器、节点或 GPU 采集器补充 CPU、内存、显存和队列指标。
设置告警并完成验收
告警阈值应来自服务目标和压测基线,而不是照搬固定数字。初始版本可以先设置保守阈值,再根据一周以上的稳定流量调整,避免告警过多导致真正的问题被忽略。
| 告警条件 | 建议持续时间 | 处理方向 |
|---|---|---|
| 5xx 比例超过 1% | 5 分钟 | 检查模型异常、依赖和输入边界 |
| P95 延迟超过 2 秒 | 10 分钟 | 检查并发、批处理和资源饱和 |
| 内存或显存超过限制的 85% | 10 分钟 | 检查泄漏、批大小和副本数 |
| 预期有流量却连续无请求 | 5 分钟 | 检查网关、路由和服务存活 |
验收时应确认:正常请求能生成唯一请求编号;异常请求能记录错误类型;指标能区分状态码;面板能查看请求量与 P95;触发测试阈值后,告警能到达值班渠道并附带服务名、时间范围和查询入口。
本课总结
- 日志用于还原单次请求,指标用于识别整体趋势,两者通过请求编号关联
- 模型服务必须同时观察流量、延迟、错误和资源饱和度
- 告警阈值要以服务目标和压测结果为依据,并通过故障演练验证
下一课预告
下一课将把日志、指标和告警用于系统化故障排查,学习如何从现象出发缩小范围,并验证根因与修复结果。
按自己的节奏,确认真正理解。