
大模型原理与训练 / 系统课时
位置前馈网络
位置前馈网络
位置前馈网络负责在注意力完成信息汇聚后,对每个词元的特征进行独立变换。学完本课,你将能看懂它的升维、激活与降维过程,并验证为什么序列长度不变、特征维度最终回到模型维度。
学习目标
- 说明位置前馈网络与自注意力的职责差异
- 理解从
d_model升到d_ff再降回d_model的过程 - 使用可运行示例验证各位置共享参数但彼此独立计算
它处理的不是词元关系
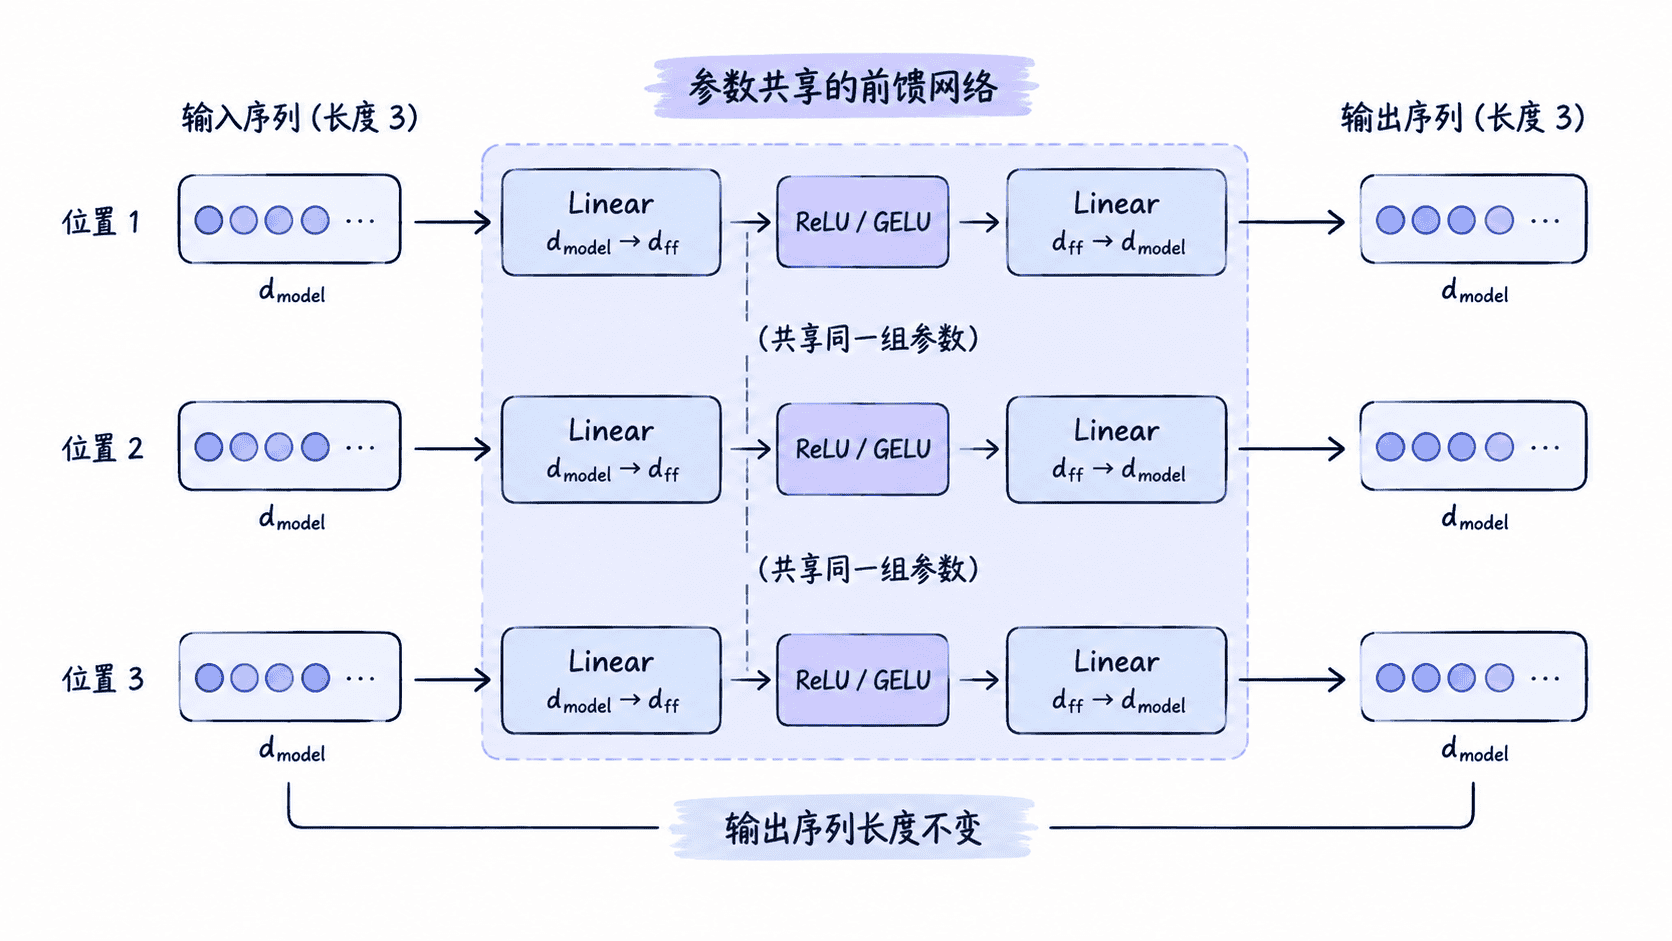
自注意力会让一个位置读取其他位置的信息,位置前馈网络则不再混合不同位置。它把同一个两层全连接网络分别应用到序列中的每个词元,因此也常被称为逐位置前馈网络。
设输入形状为 [batch_size, seq_len, d_model]。前馈网络只变换最后一维,批次大小和序列长度保持不变。不同位置使用完全相同的权重,这既控制了参数量,也允许所有位置并行计算。
两层变换如何工作
对单个位置向量 x,核心计算可以写成:
第一层把维度从 d_model 扩展到更大的 d_ff,让模型在更宽的特征空间中组合信息;激活函数引入非线性;第二层再投影回 d_model,以便与输入执行残差相加。原始 Transformer 使用 ReLU,许多后续模型改用更平滑的 GELU。
升维并不是增加词元数量,而是增加每个词元内部可用的特征通道。若 d_model=512、d_ff=2048,序列中每个位置都会经历 512 → 2048 → 512 的变换。
用代码验证逐位置计算
下面使用纯 Python 实现一个最小前馈网络。为了突出计算路径,示例省略批次维度、归一化和 dropout,只保留两次线性映射与 ReLU。
def linear(vector, weights, bias):
    return [
        sum(vector[i] * weights[i][j] for i in range(len(vector))) + bias[j]
        for j in range(len(bias))
    ]

def relu(vector):
    return [max(0.0, value) for value in vector]

def feed_forward(vector):
    # 第一层把 2 维特征升到 3 维,第二层再降回 2 维
    hidden = relu(linear(vector, W1, B1))
    return linear(hidden, W2, B2)

W1 = [
    [1.0, -1.0, 0.5],
    [0.5, 1.0, -0.5],
]
B1 = [0.0, 0.0, 0.0]

W2 = [
    [1.0, 0.0],
    [0.0, 1.0],
    [1.0, 1.0],
]
B2 = [0.0, 0.0]

sequence = [
    [1.0, 2.0],
    [2.0, 1.0],
    [-1.0, 1.0],
]

for position, token_vector in enumerate(sequence):
    print(f"position {position}: {feed_forward(token_vector)}")
预期输出:
position 0: [2.0, 1.0]
position 1: [3.0, 0.5]
position 2: [0.0, 2.0]
三个位置调用的是同一个 feed_forward,但每次只读取当前词元向量。修改某个位置的输入不会直接改变其他位置的计算结果;位置之间的交互已经由前面的注意力子层完成。
维度与计算边界
第二层输出维度必须回到 d_model,否则无法与子层输入执行残差相加。d_ff 通常大于 d_model,但它是模型超参数,并不等于序列长度。
对长度为 n 的序列,主要计算量约为 。各位置没有数据依赖,因此训练和推理时都适合使用矩阵乘法并行处理,而不是逐词元编写循环。
本课总结
- 位置前馈网络对每个词元独立计算,不负责建立位置之间的关系
- 两层线性映射完成
d_model → d_ff → d_model,激活函数提供非线性表达能力 - 所有位置共享参数,序列长度保持不变,输出维度可继续参与残差连接
下一课预告
下一课将沿着编码器中的残差连接路径,分析注意力输出和前馈输出如何与原输入汇合,并解释这条捷径为什么有助于保留信息和稳定训练。