
大模型原理与训练 / 系统课时
混合精度训练
混合精度训练
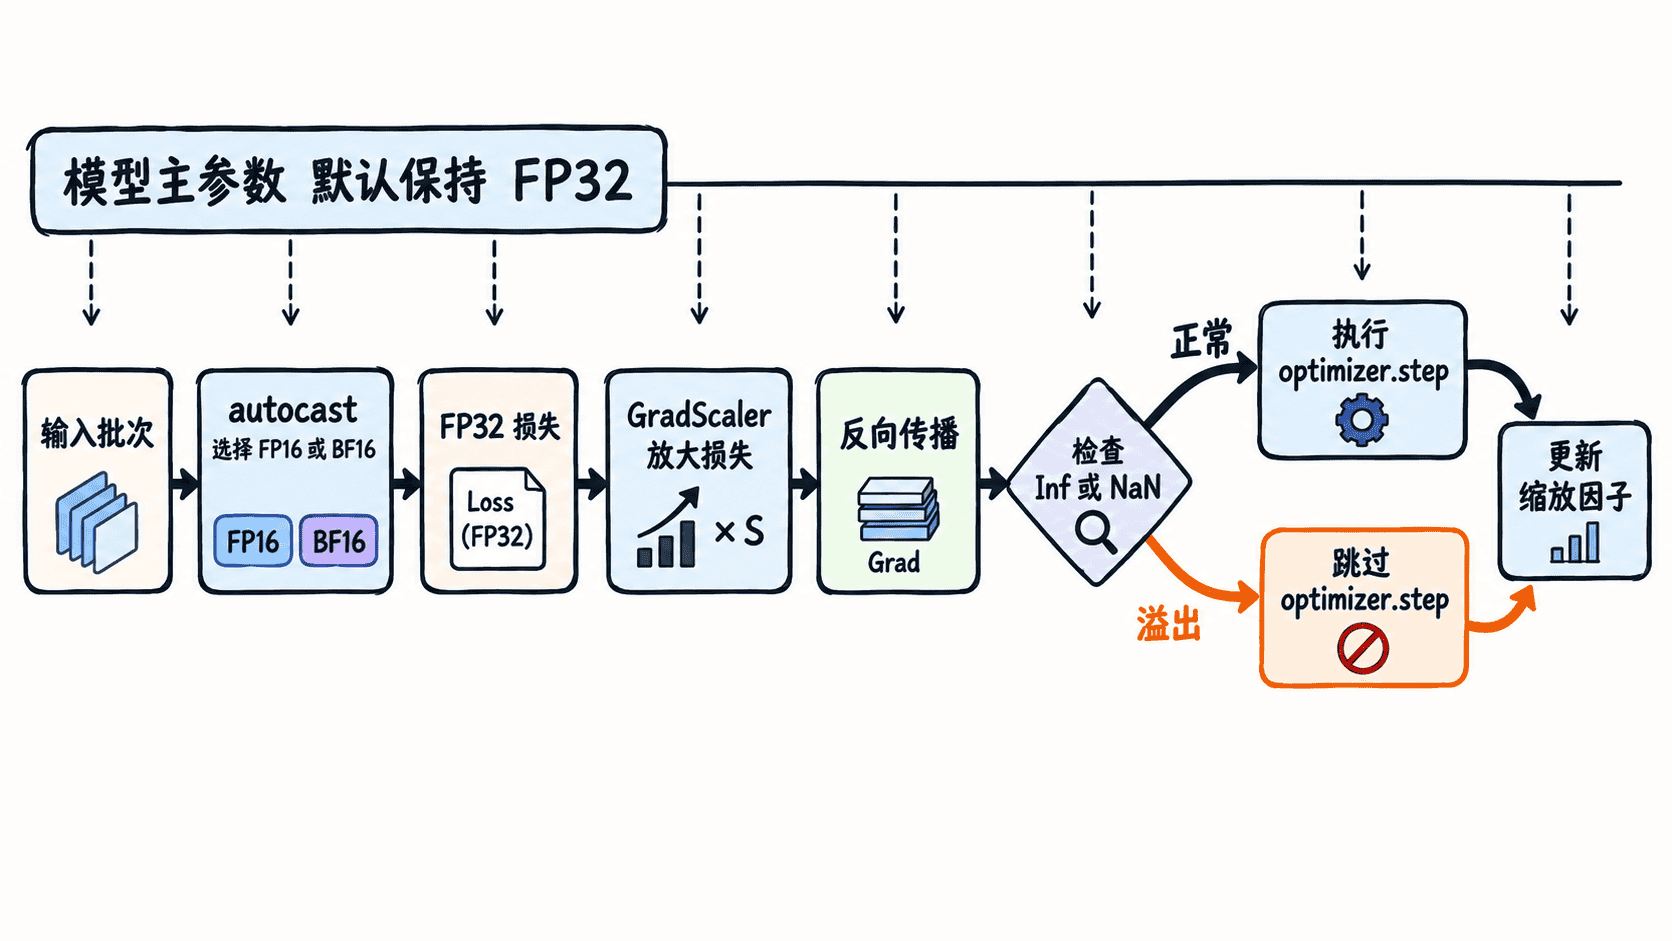
混合精度训练不是把模型整体改成半精度,而是在保证数值稳定的前提下,让适合的算子使用 FP16 或 BF16,从而降低显存占用并提升训练吞吐。本课将完成一份可运行的 PyTorch AMP 示例,并学会判断它是否真正生效。
学习目标
- 说明 FP32、FP16、BF16 在训练中的分工
- 使用自动混合精度与梯度缩放完成一次训练
- 识别溢出、梯度裁剪和性能验证中的关键边界
核心机制
FP32 精度高、动态范围大,但显存和计算成本也更高。FP16 更节省显存,并能利用 GPU 的低精度计算单元;BF16 的尾数精度较低,却保留了接近 FP32 的指数范围,通常更不容易溢出。具体收益取决于硬件是否支持相应低精度算子。
自动混合精度由两个部分协作完成:autocast 根据算子特性选择低精度或 FP32,GradScaler 则先放大损失再反向传播,避免很小的 FP16 梯度下溢。若检测到 Inf 或 NaN,优化器更新会被跳过,并调整缩放因子。
PyTorch 主示例
下面的脚本要求环境中安装支持 CUDA 的 PyTorch。它训练一个小型回归网络,并在每一步输出损失与当前缩放因子;没有可用 GPU 时会安全退出。
import torch
from torch import nn

def main() -> None:
    if not torch.cuda.is_available():
        print('CUDA unavailable, skip AMP example.')
        return

    torch.manual_seed(7)
    device = torch.device('cuda')
    model = nn.Sequential(
        nn.Linear(16, 32),
        nn.ReLU(),
        nn.Linear(32, 1),
    ).to(device)
    optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)
    criterion = nn.MSELoss()
    scaler = torch.amp.GradScaler('cuda')

    x = torch.randn(256, 16, device=device)
    y = x.sum(dim=1, keepdim=True)

    for step in range(5):
        optimizer.zero_grad(set_to_none=True)

        # autocast 只降低适合算子的精度,不会盲目转换全部计算
        with torch.amp.autocast(device_type='cuda', dtype=torch.float16):
            prediction = model(x)
            loss = criterion(prediction, y)

        # 先缩放再反向传播,由 scaler 决定是否执行本次参数更新
        scaler.scale(loss).backward()
        scaler.step(optimizer)
        scaler.update()

        print(
            f'step={step + 1}, loss={loss.item():.4f}, '
            f'scale={scaler.get_scale():.0f}'
        )

if __name__ == '__main__':
main()预期输出如下。<LOSS> 与 <SCALE> 会随硬件、PyTorch 版本和数值路径变化,但损失应保持有限值。
step=1, loss=<LOSS>, scale=<SCALE>
step=2, loss=<LOSS>, scale=<SCALE>
step=3, loss=<LOSS>, scale=<SCALE>
step=4, loss=<LOSS>, scale=<SCALE>
step=5, loss=<LOSS>, scale=<SCALE>
验证与关键边界
验证 AMP 不能只看程序是否运行,还要同时检查三个结果:峰值显存是否下降、稳定训练若干步后吞吐是否提升、损失与梯度是否持续为有限值。首次迭代包含内核加载和缓存建立,性能比较应先预热再计时。
不要先对整个模型调用 model.half() 再使用 AMP,这会削弱自动精度选择。需要梯度裁剪时,应先调用 scaler.unscale_(optimizer),再执行裁剪;BF16 因指数范围更大,很多场景不需要梯度缩放,但仍需根据硬件和任务验证。
本课总结
- AMP 通过按算子选择精度,在速度、显存与稳定性之间取得平衡
- FP16 常配合梯度缩放,溢出时会跳过更新并动态调整缩放因子
- 是否采用混合精度应以显存、吞吐和数值稳定性三项实测为准
下一课预告
下一课将进入从零实现阶段,先划分配置、数据、模型、训练和推理模块,为后续逐步编码建立清晰依赖边界。