
大模型原理与训练 / 系统课时
模型仓库与配置
模型仓库与配置
预训练模型仓库不是只有一个权重文件,而是一组彼此配合的配置、权重、分词器与任务头信息。本课将带你读懂常见文件的职责,并用一个检查脚本验证关键字段是否一致。
学习目标
- 识别模型仓库中配置、权重和分词器文件的职责
- 理解基础模型与任务头之间的关系
- 能检查配置中的模型类型、隐藏维度和词表大小
模型仓库由什么组成
一个可直接加载的仓库通常至少包含模型配置、参数权重和分词器资源。配置决定“如何搭建网络”,权重提供“每个参数的数值”,分词器负责把文本变成模型可接收的整数序列。
model-repository/
├── config.json
├── model.safetensors
├── tokenizer.json
├── tokenizer_config.json
├── special_tokens_map.json
└── vocab.txt
文件名可能因模型架构而变化。例如 BPE 分词器常见 vocab.json 与 merges.txt,SentencePiece 模型常见 tokenizer.model,大模型仓库还可能把权重拆成多个分片,并附带索引文件。
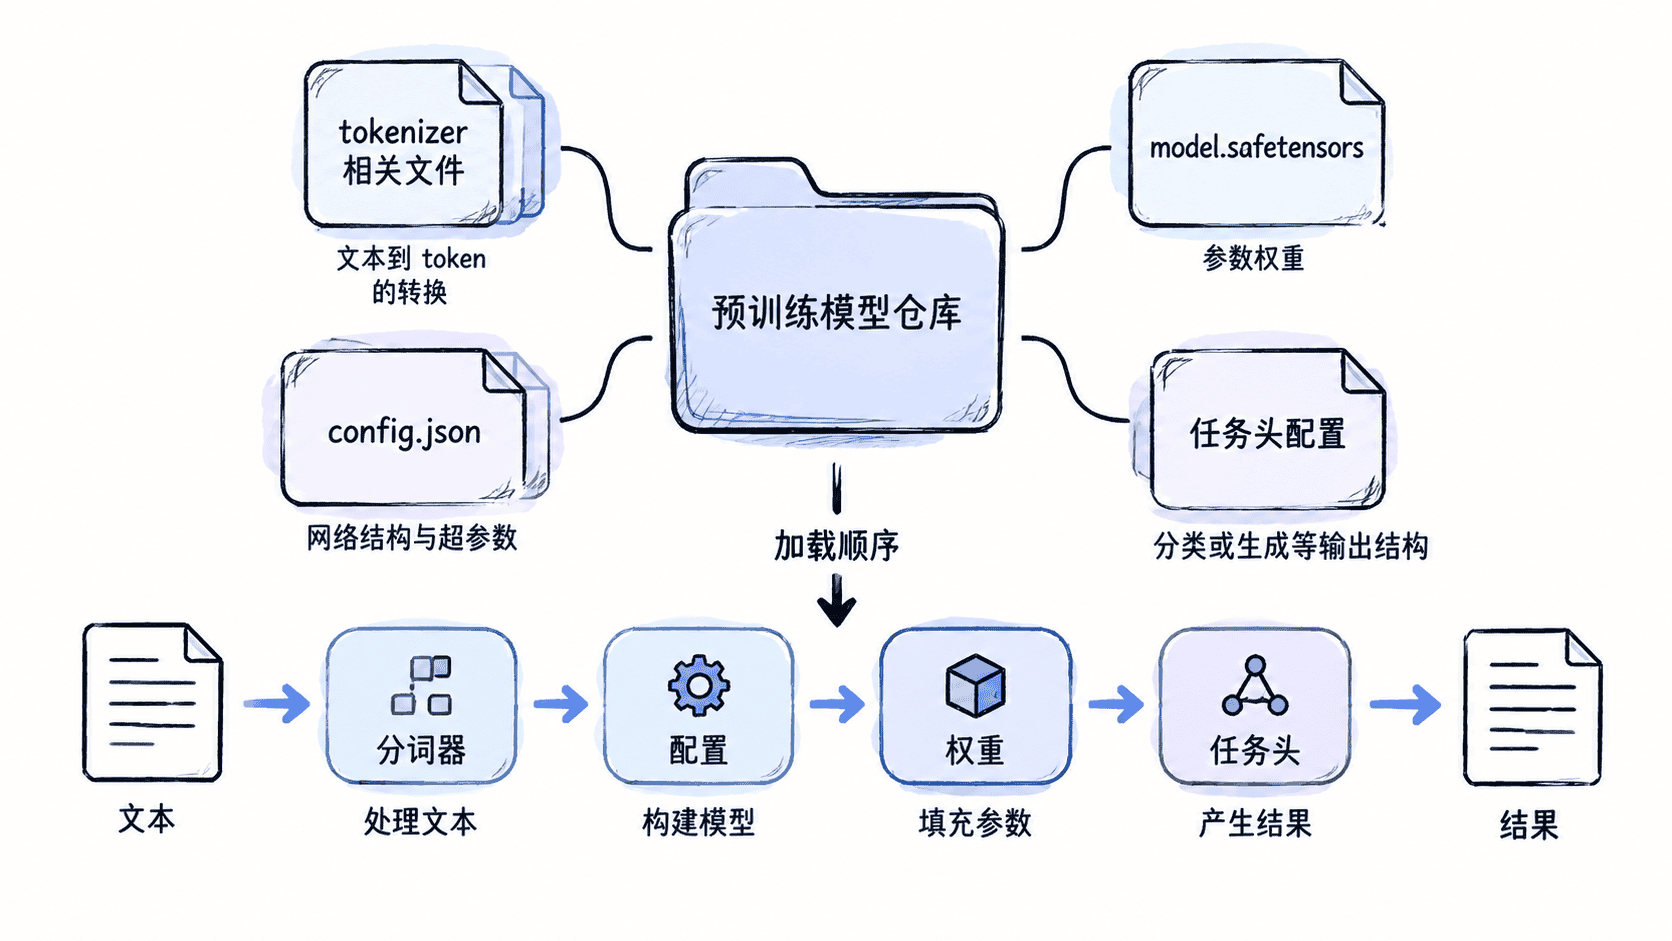
配置、权重与任务头
config.json 保存模型架构名称、隐藏维度、层数、注意力头数、词表大小等信息。加载模型时,框架先根据配置创建网络,再把权重文件中的张量映射到对应参数。
基础模型只输出隐藏状态,适合特征提取;任务模型会在基础模型之上增加分类、问答或语言建模头。例如序列分类模型通常增加一个线性层,把句子表示映射为类别分数。任务头的形状必须与 num_labels 等配置一致,否则加载时会出现尺寸不匹配。
分词器文件为什么必须匹配
模型只认识训练时使用的 token 编号。即使两个分词器都能处理中文,只要词表顺序不同,相同文本就会得到不同编号,输入含义也会被破坏。
重点检查 vocab_size、特殊标记以及分词器类型。新增特殊标记后,还要同步扩展模型的词嵌入矩阵;仅修改分词器而不调整模型,会导致编号超出嵌入范围。
用脚本检查关键配置
下面的脚本构造一个最小仓库配置,并检查模型词表大小是否与分词器记录一致。示例只依赖 Python 标准库,可直接运行。
import json
from pathlib import Path
from tempfile import TemporaryDirectory

config = {
    "model_type": "bert",
    "hidden_size": 768,
    "num_hidden_layers": 12,
    "vocab_size": 30522
}
tokenizer_config = {
    "tokenizer_class": "BertTokenizerFast",
    "vocab_size": 30522
}

with TemporaryDirectory() as temp_dir:
    repo = Path(temp_dir)
    (repo / "config.json").write_text(
        json.dumps(config), encoding="utf-8"
    )
    (repo / "tokenizer_config.json").write_text(
        json.dumps(tokenizer_config), encoding="utf-8"
    )

    model_cfg = json.loads((repo / "config.json").read_text(encoding="utf-8"))
    tokenizer_cfg = json.loads(
        (repo / "tokenizer_config.json").read_text(encoding="utf-8")
    )

    print(f"model_type={model_cfg['model_type']}")
    print(f"hidden_size={model_cfg['hidden_size']}")
    print(f"tokenizer_class={tokenizer_cfg['tokenizer_class']}")
    print(
        "vocab_size_match="
        f"{model_cfg['vocab_size'] == tokenizer_cfg['vocab_size']}"
    )
预期输出
model_type=bert
hidden_size=768
tokenizer_class=BertTokenizerFast
vocab_size_match=True
真实仓库中还应检查权重文件是否完整、分片索引是否存在,以及配置声明的架构是否与权重对应。若加载日志提示缺失键或多余键,应先判断是不是故意替换了任务头,再决定是否可以忽略。
常见错误
把 config.json 当成权重文件是最常见的误解。配置通常只有几 KB,不能恢复模型能力;真正占用大量空间的是权重文件。
另一个错误是混用不同提交版本的配置、权重和分词器。仓库更新后,最好固定同一个版本或提交哈希,避免文件之间发生不兼容。
本课总结
- 配置定义网络结构,权重保存参数数值,分词器决定文本对应的 token 编号
- 基础模型与任务模型的主要差异在于是否包含面向具体任务的输出头
- 加载前应核对模型类型、词表大小、特殊标记和权重完整性
下一课预告
下一课将使用 AutoTokenizer 与 AutoModel 系列接口,让框架根据仓库配置自动选择正确的分词器和模型类。