
大模型原理与训练 / 系统课时
自定义训练循环
自定义训练循环
当标准训练器无法表达特殊损失、梯度累积或自定义评估逻辑时,可以直接使用 PyTorch 接管训练过程。本课将完成一个可运行的文本分类微调循环,并明确每个训练阶段的职责与验证方法。
学习目标
- 识别需要自定义训练循环的典型场景
- 掌握前向计算、反向传播和参数更新的正确顺序
- 实现加权损失、梯度累积、裁剪与学习率调度
何时需要自定义循环
高层训练器适合常规微调,但当损失函数依赖额外标签、不同任务需要联合优化,或每一步都要执行特殊控制时,原生循环更直接。它的代价是必须自行管理设备迁移、训练模式、梯度清零、评估和模型保存。
自定义循环的核心不是“少调用一个 Trainer”,而是把训练状态显式掌握在自己手中。每次参数更新都应遵循固定顺序:取批次、前向计算、得到损失、反向传播、必要时裁剪梯度、更新参数、推进调度器。
训练链路
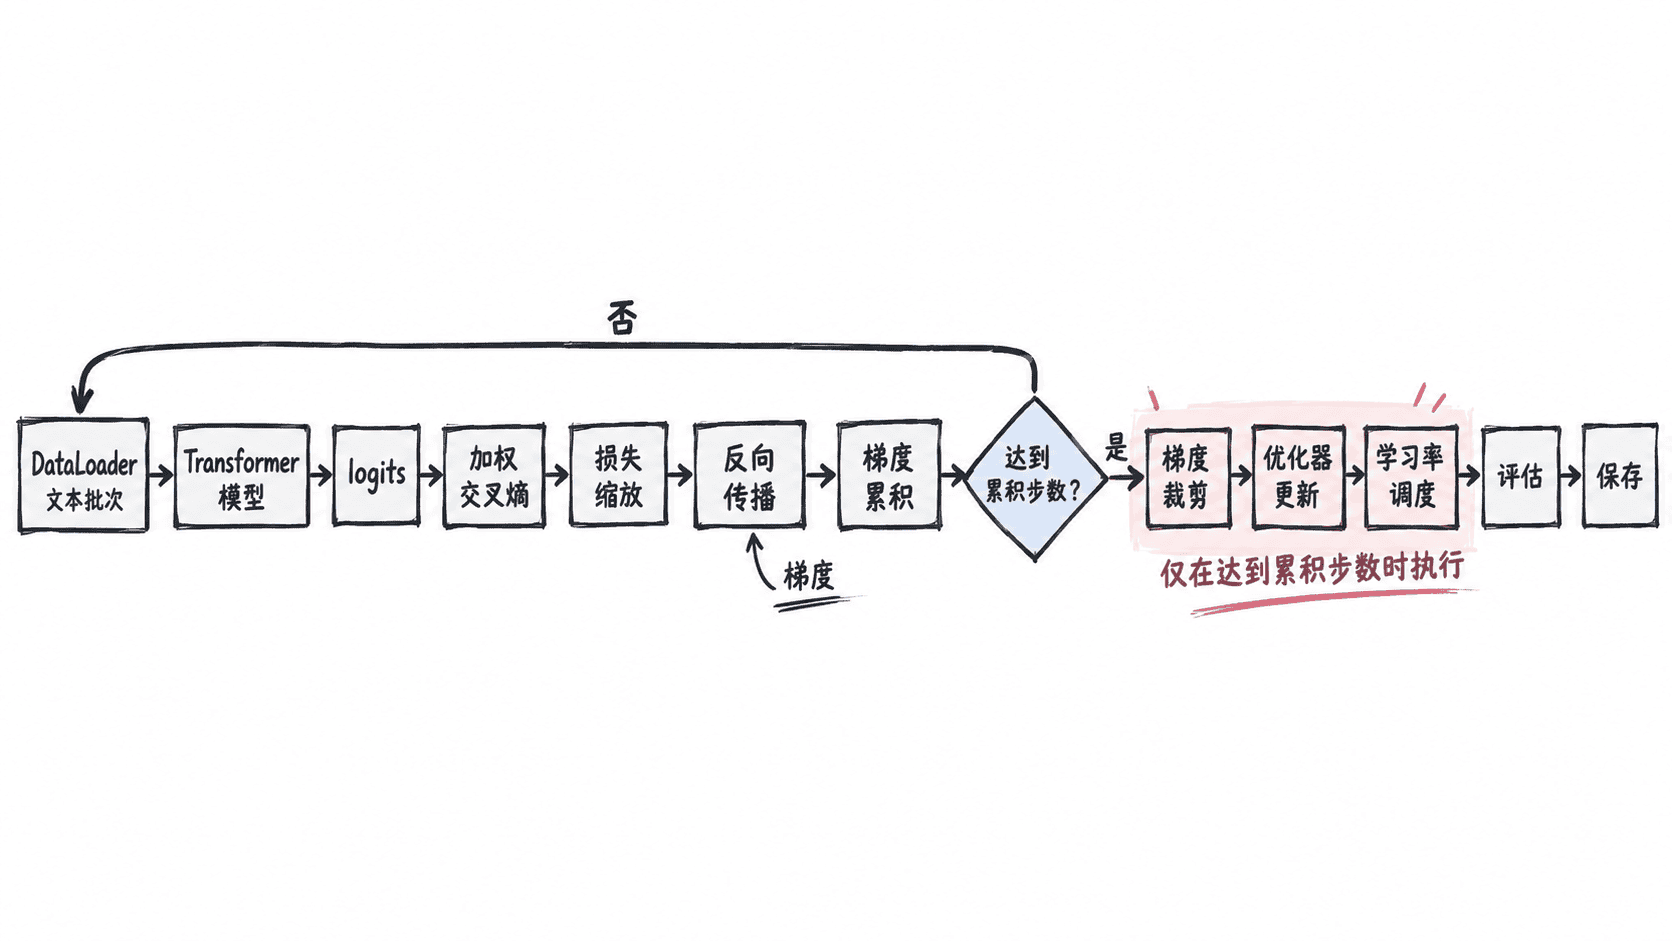
图中最容易遗漏的是条件更新:反向传播可以每个批次执行,但优化器只在累积到指定步数或到达本轮最后一个批次时执行。这样可以用较小显存模拟更大的有效批量。
完整实现
下面使用一个小型 BERT 检查点完成二分类微调。首次运行会下载模型文件,之后可从本地缓存加载。
import torch
import torch.nn.functional as F
from torch.nn.utils import clip_grad_norm_
from torch.optim import AdamW
from torch.utils.data import DataLoader, Dataset
from transformers import (
    AutoModelForSequenceClassification,
    AutoTokenizer,
    get_linear_schedule_with_warmup,
    set_seed,
)

MODEL_NAME = "prajjwal1/bert-tiny"
DEVICE = torch.device("cuda" if torch.cuda.is_available() else "cpu")
GRAD_ACCUM_STEPS = 2
EPOCHS = 2

class TextDataset(Dataset):
    def __init__(self, tokenizer):
        texts = [
            "this product is excellent",
            "the service was very good",
            "I am satisfied with the result",
            "this product is terrible",
            "the service was very bad",
            "I am disappointed with the result",
        ]
        labels = [1, 1, 1, 0, 0, 0]
        encoded = tokenizer(
            texts,
            padding=True,
            truncation=True,
            max_length=32,
            return_tensors="pt",
        )
        self.input_ids = encoded["input_ids"]
        self.attention_mask = encoded["attention_mask"]
        self.labels = torch.tensor(labels, dtype=torch.long)

    def __len__(self):
        return len(self.labels)

    def __getitem__(self, index):
        return {
            "input_ids": self.input_ids[index],
            "attention_mask": self.attention_mask[index],
            "labels": self.labels[index],
        }

def main():
    set_seed(42)
    tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)
    model = AutoModelForSequenceClassification.from_pretrained(
        MODEL_NAME,
        num_labels=2,
    ).to(DEVICE)

    dataloader = DataLoader(TextDataset(tokenizer), batch_size=2, shuffle=False)
    optimizer = AdamW(model.parameters(), lr=2e-5)
    update_steps_per_epoch = (len(dataloader) + GRAD_ACCUM_STEPS - 1) // GRAD_ACCUM_STEPS
    total_update_steps = update_steps_per_epoch * EPOCHS
    scheduler = get_linear_schedule_with_warmup(
        optimizer,
        num_warmup_steps=1,
        num_training_steps=total_update_steps,
    )
    class_weights = torch.tensor([1.0, 1.5], device=DEVICE)

    optimizer_steps = 0
    for _ in range(EPOCHS):
        model.train()
        optimizer.zero_grad()

        for step, batch in enumerate(dataloader):
            labels = batch.pop("labels").to(DEVICE)
            inputs = {name: value.to(DEVICE) for name, value in batch.items()}
            logits = model(**inputs).logits

            # 自定义加权损失,并按累积步数缩放,避免梯度被放大。
            loss = F.cross_entropy(logits, labels, weight=class_weights)
            (loss / GRAD_ACCUM_STEPS).backward()

            should_update = (
                (step + 1) % GRAD_ACCUM_STEPS == 0
                or step + 1 == len(dataloader)
            )
            if should_update:
                clip_grad_norm_(model.parameters(), max_norm=1.0)
                optimizer.step()
                scheduler.step()
                optimizer.zero_grad()
                optimizer_steps += 1

    model.eval()
    sample = tokenizer(
        "the result is good",
        return_tensors="pt",
        truncation=True,
        max_length=32,
    )
    sample = {name: value.to(DEVICE) for name, value in sample.items()}
    with torch.no_grad():
        logits = model(**sample).logits
        probabilities = torch.softmax(logits, dim=-1)

    model.save_pretrained("./custom-loop-model")
    tokenizer.save_pretrained("./custom-loop-model")
    print(f"optimizer_steps={optimizer_steps}")
    print(f"logits_shape={tuple(logits.shape)}")
    print(f"probability_sum={probabilities.sum(dim=-1).item():.4f}")
    print("saved_to=./custom-loop-model")

if __name__ == "__main__":
    main()
预期输出
optimizer_steps=4
logits_shape=(1, 2)
probability_sum=1.0000
saved_to=./custom-loop-model
首次下载时可能额外出现缓存或权重加载日志;设备不同不会改变上述张量形状和优化器更新次数。
关键边界与验证
model.train() 会启用训练阶段的 Dropout,model.eval() 则切换到评估行为;两者不会自动关闭梯度,因此推理还要配合 torch.no_grad()。每次 optimizer.step() 后必须清零梯度,否则后续批次会继续累加旧梯度。
梯度累积时,损失应除以累积步数。若最后剩余批次数不足一个完整累积周期,也要执行一次更新,否则最后一部分样本只完成反向传播,却没有真正改变参数。
验证时可检查三个结果:优化器更新次数是否符合预期、概率和是否接近 1、保存目录是否包含模型配置与权重文件。若出现显存不足,先减小批量或序列长度,再增加梯度累积步数。
本课总结
- 自定义循环适合特殊损失、多任务训练和精细的更新控制
- 正确顺序是反向传播、裁剪、参数更新、调度器推进与梯度清零
- 训练模式、评估模式和梯度开关必须分别管理
下一课预告
下一课将分析全量微调的显存、计算与存储成本,为选择 LoRA 等参数高效微调方案建立量化依据。