
大模型原理与训练 / 系统课时
编码器输出表示
编码器输出表示
编码器不会直接给出“类别”或“标签”,而是为序列中的每个位置生成上下文化向量。本课将拆解输出张量的语义,并演示如何把同一份编码器输出接到分类、序列标注和特征提取任务。
学习目标
- 读懂编码器输出
[B, L, D]三个维度的含义 - 区分整序列表示与逐词元表示的使用方式
- 能为常见下游任务选择合适的输出处理方法
输出张量代表什么
设批次大小为 、序列长度为 、隐藏维度为 ,编码器输出形状通常为 [B, L, D]。其中每个位置的向量不再只表示当前词元,而是已经融合了整条序列中可见位置的信息。
输出长度一般与输入长度相同,因为编码器不会像池化层那样自动压缩序列。填充位置也会保留在张量中,因此后续做平均池化或损失计算时,必须继续使用掩码排除这些位置。
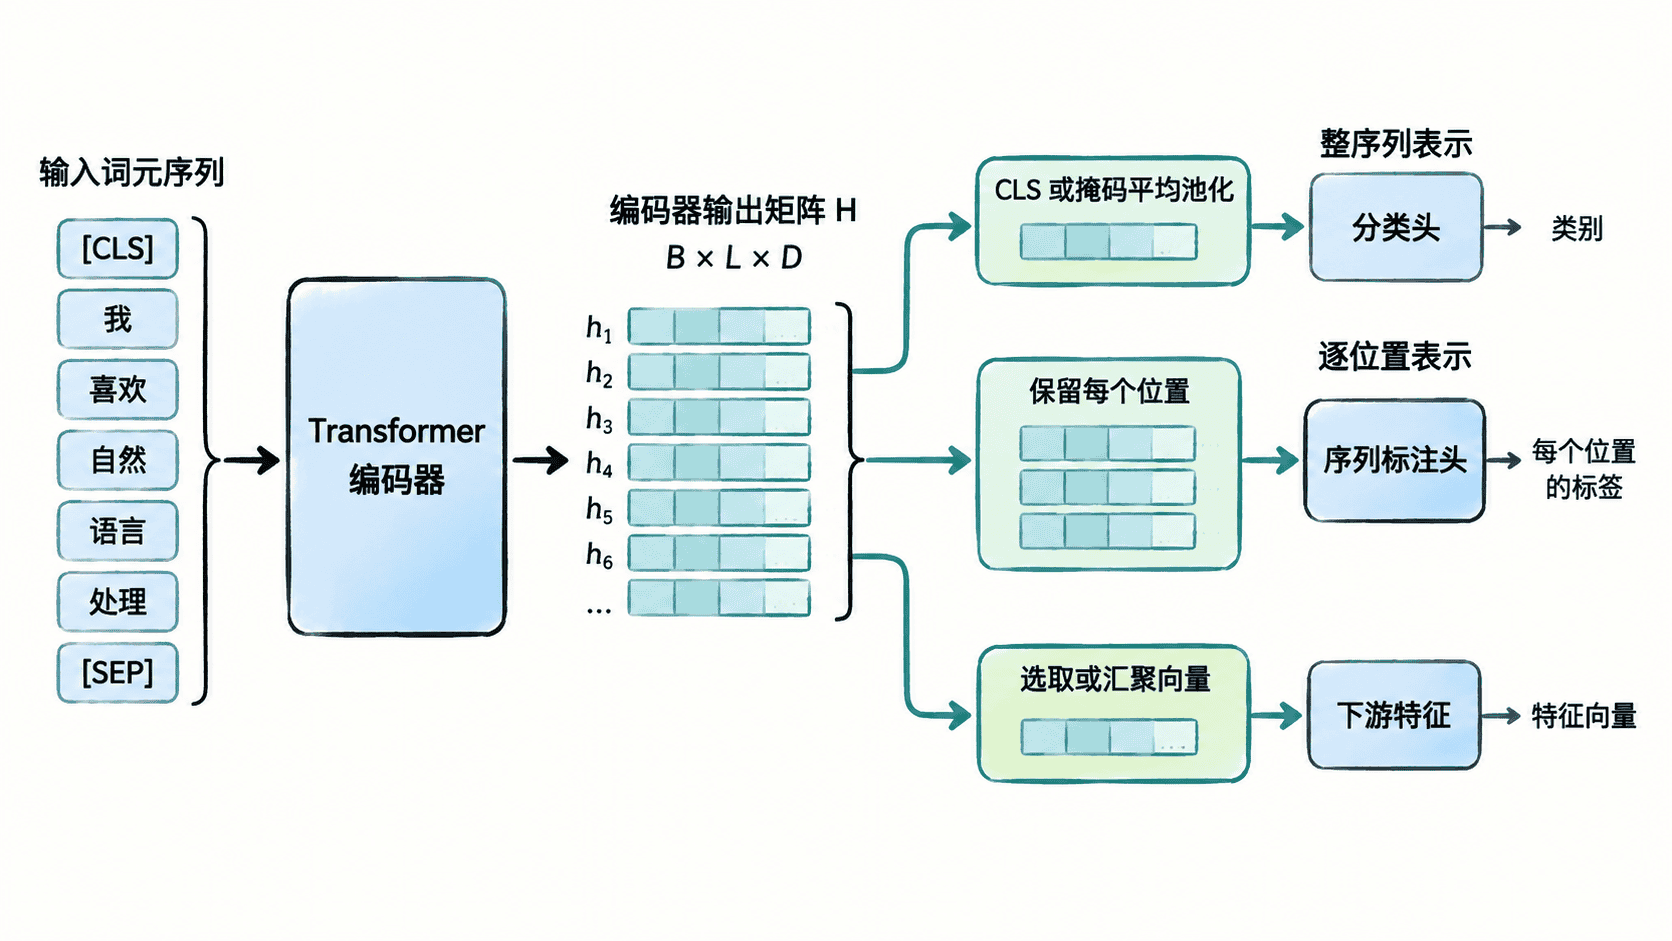
三类典型用法
序列分类需要把整条序列压缩成一个向量。常见做法是读取特殊标记位置,例如 [CLS],或对有效词元做掩码平均池化,再接一个线性分类层。
序列标注需要为每个位置输出标签,因此保留完整的 [B, L, D],对最后一维应用同一个线性层,得到 [B, L, C],其中 是标签数量。
特征提取没有唯一形式。检索任务可能使用归一化后的整序列向量,关键词分析可能读取指定位置,跨模块传递则可能保留全部隐藏状态。
| 下游任务 | 读取方式 | 典型输出形状 |
|---|---|---|
| 文本分类 | [CLS] 或掩码平均池化 |
[B, C] |
| 序列标注 | 保留所有有效位置 | [B, L, C] |
| 特征提取 | 单位置、池化或完整序列 | 取决于用途 |
同一输出连接不同任务头
下面用一个随机张量模拟编码器输出,并分别生成分类结果、逐位置标签结果和整序列特征。示例中的掩码里,True 表示有效词元。
import torch
from torch import nn

torch.manual_seed(0)

batch_size = 2
seq_len = 5
hidden_size = 8
num_classes = 3
num_tags = 4

hidden = torch.randn(batch_size, seq_len, hidden_size)
attention_mask = torch.tensor([
    [True, True, True, True, False],
    [True, True, True, False, False],
])

classification_head = nn.Linear(hidden_size, num_classes)
tagging_head = nn.Linear(hidden_size, num_tags)

# 掩码平均池化:填充位置不参与求和与计数
mask = attention_mask.unsqueeze(-1)
summed = (hidden * mask).sum(dim=1)
counts = mask.sum(dim=1).clamp_min(1)
pooled = summed / counts

class_logits = classification_head(pooled)
tag_logits = tagging_head(hidden)
features = nn.functional.normalize(pooled, dim=-1)

print("class logits:", tuple(class_logits.shape))
print("tag logits:", tuple(tag_logits.shape))
print("features:", tuple(features.shape))
预期输出:
class logits: (2, 3)
tag logits: (2, 5, 4)
features: (2, 8)
分类头把每条序列映射为 3 个类别分数;标注头对 5 个位置分别产生 4 个标签分数;特征提取则保留每条序列的 8 维归一化表示。
处理输出时的关键边界
直接对所有位置取平均会把填充向量也算进去,导致短序列的表示被污染。正确做法是使用与编码器相同的有效位置掩码,并将分母限制为至少 1,避免全填充样本出现除零。
使用 [CLS] 位置并不天然优于平均池化。只有模型训练过程明确让该位置承担整序列汇聚职责时,它才具有稳定语义;否则应通过验证集比较不同池化策略。
序列标注还要注意子词对齐。一个原始单词可能被拆成多个词元,训练时需要决定只监督首个子词,还是让所有子词共享标签,这一选择应与数据预处理保持一致。
本课总结
- 编码器输出
[B, L, D]为每个位置提供上下文化表示 - 分类任务需要汇聚序列,序列标注任务保留全部位置
- 池化、损失和特征提取都必须正确处理填充掩码与词元对齐
下一课预告
下一课将进入解码器结构,说明因果掩码如何限制当前位置只能读取已经出现的目标词元。