
大模型原理与训练 / 系统课时
文本分词与词元
文本分词与词元
Transformer 不能直接理解原始文字,必须先把文本切成词元并转换为整数编号。本课从字符、单词和子词三种粒度入手,说明词元化如何影响序列长度、词表规模、未知词处理以及模型最终看到的输入。
学习目标
- 区分字符、单词和子词三种分词粒度
- 理解词元、词表与词元编号之间的关系
- 判断分词方式对模型输入长度和表达能力的影响
从文本到模型输入
词元化的任务,是把一段连续文本切分成模型可处理的离散单元。每个单元称为词元,英文常写作 token。模型并不直接接收“自然语言字符串”,而是接收词元对应的整数编号序列。
例如文本 Transformers are powerful. 可以先被切成若干词元,再通过词表映射为编号。词表记录“词元到整数”的固定对应关系;同一个模型在训练和推理时必须使用同一套分词器与词表。
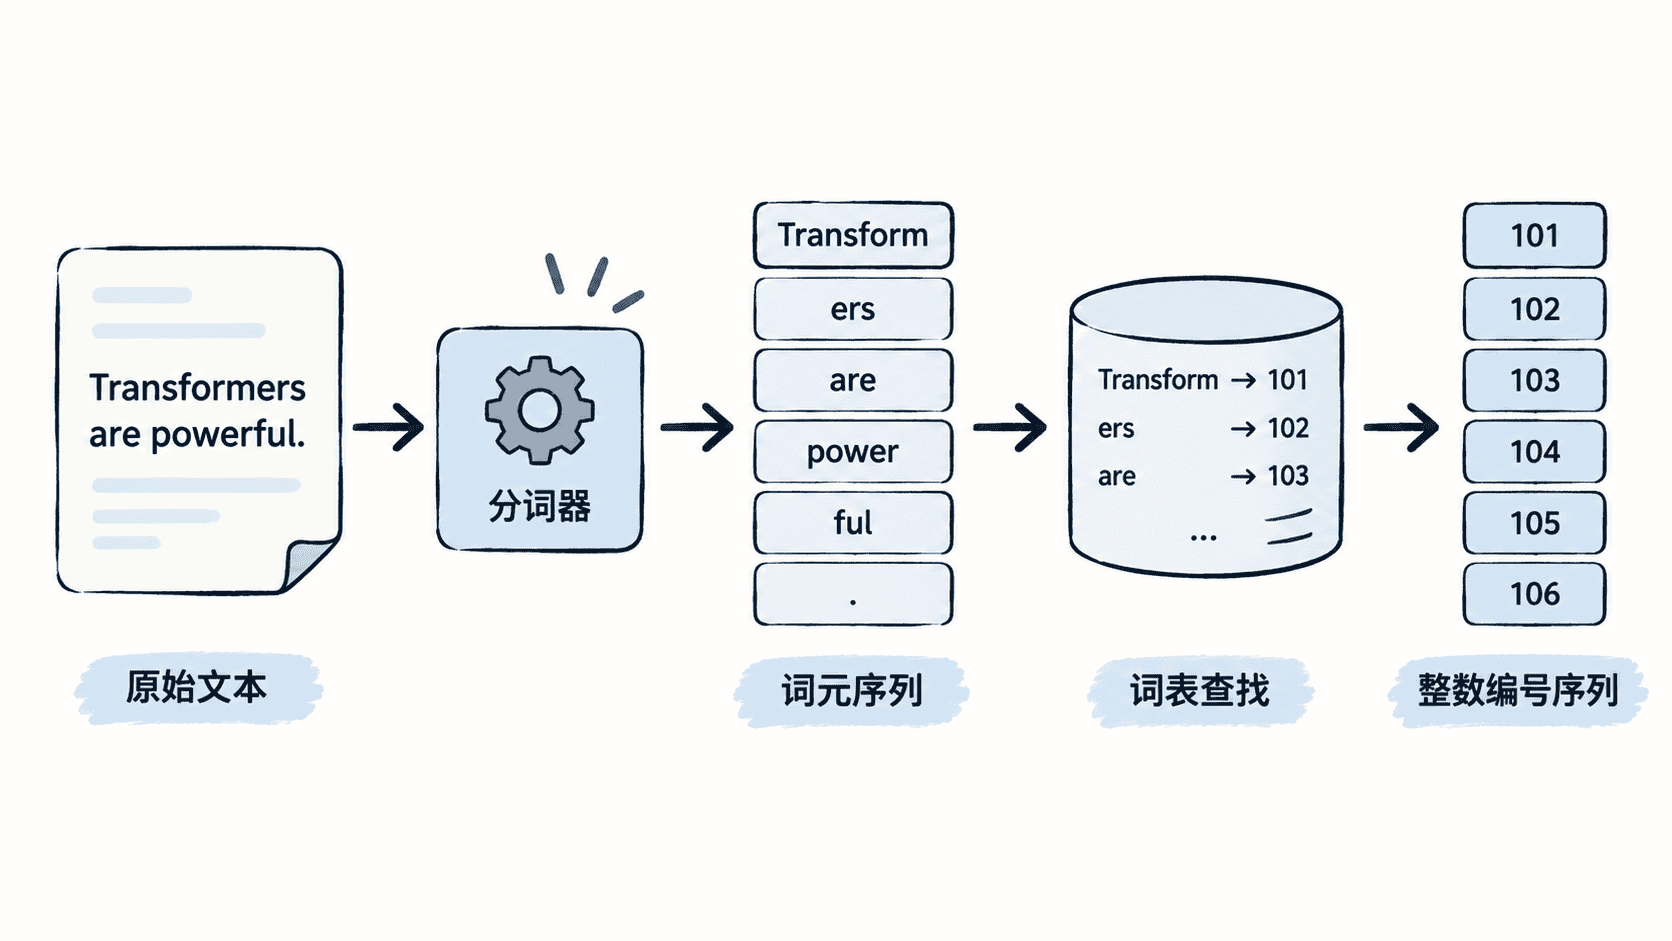
三种常见粒度
字符级分词把每个字符作为一个词元。它几乎不会遇到未知词,词表也较小,但序列会变长,模型需要用更多位置才能组合出单词和语义。
单词级分词以完整单词为单位,序列通常较短,词元也容易理解。不过自然语言中的词形变化、拼写变体和专有名词会快速扩大词表,词表之外的单词还可能被统一替换为未知词元。
子词级分词位于两者之间。高频词可以保留为完整词元,低频词则拆成更小的片段。例如 unhappiness 可能被拆成 un、happi、ness。这种方式兼顾了词表规模、序列长度和未知词处理,因此被多数 Transformer 模型采用。
| 粒度 | 主要优点 | 主要代价 |
|---|---|---|
| 字符 | 词表小,几乎无未知词 | 序列长,语义组合负担大 |
| 单词 | 序列短,可读性强 | 词表膨胀,未知词较多 |
| 子词 | 词表与序列长度较均衡 | 切分结果不一定符合直觉 |
用代码观察切分差异
下面的 Python 程序使用一个最小示例,分别执行字符级、空格单词级和预设子词级切分。子词部分用于说明结果形态,不代表真实模型中的训练算法。
def char_tokenize(text: str) -> list[str]:
    return list(text)

def word_tokenize(text: str) -> list[str]:
    # 示例只处理空格,真实分词器还会单独处理标点和规范化。
    return text.split()

def demo_subword_tokenize() -> list[str]:
    # 假设词表已经包含这些子词片段。
    return ["un", "happi", "ness"]

def main() -> None:
    text = "unhappiness"
    print("字符级:", char_tokenize(text))
    print("单词级:", word_tokenize(text))
    print("子词级:", demo_subword_tokenize())

if __name__ == "__main__":
    main()
预期输出:
字符级: ['u', 'n', 'h', 'a', 'p', 'p', 'i', 'n', 'e', 's', 's']
单词级: ['unhappiness']
子词级: ['un', 'happi', 'ness']
这个结果说明,同一段文本在不同粒度下会产生不同数量的词元。词元越细,序列通常越长;词元越粗,词表通常越大。
词元化如何影响模型
Transformer 的计算量与序列长度密切相关。切分得到的词元越多,占用的上下文窗口越多,注意力计算和显存开销也会增加。相反,过大的词表会扩大嵌入矩阵和输出层参数量。
分词还会影响语义边界。一个罕见术语若被拆成合理子词,模型可以利用已有片段推断含义;若被拆得过碎,模型需要跨多个位置重新组合信息。处理代码、中文、数字和多语言文本时,这种差异尤其明显。
Tips:比较两个模型的上下文长度或调用成本时,不要只比较字符数。相同文本经过不同分词器后,词元数量可能明显不同。
本课总结
- 词元化把原始文本转换为词元序列,再映射为模型可接收的整数编号
- 字符级、单词级和子词级分别在序列长度、词表规模与未知词处理之间取舍
- 分词结果会直接影响上下文占用、计算成本和模型对罕见词的表达能力
下一课预告
下一课将进入子词词表的构建过程,比较 BPE、WordPiece 和 Unigram 如何决定哪些片段应该保留为词元。