
大模型原理与训练 / 系统课时
Trainer 训练流程
Trainer 训练流程
本课搭建一条完整的 Trainer 训练链路:准备训练集与验证集,配置批次整理和评估指标,统一管理训练、验证、检查点保存与最佳模型加载。
学习目标
- 理解 Trainer 在训练流程中管理的核心对象
- 能配置训练、评估和保存策略
- 能读取评估结果并确认最佳检查点已生效
Trainer 管理的对象
Trainer 不是模型算法,而是训练流程协调器。它接收模型、训练参数、数据集、数据整理器和指标函数,在内部完成批次迭代、梯度更新、周期评估、日志记录与检查点保存。模型仍负责前向计算和损失,Trainer 负责何时调用这些能力。
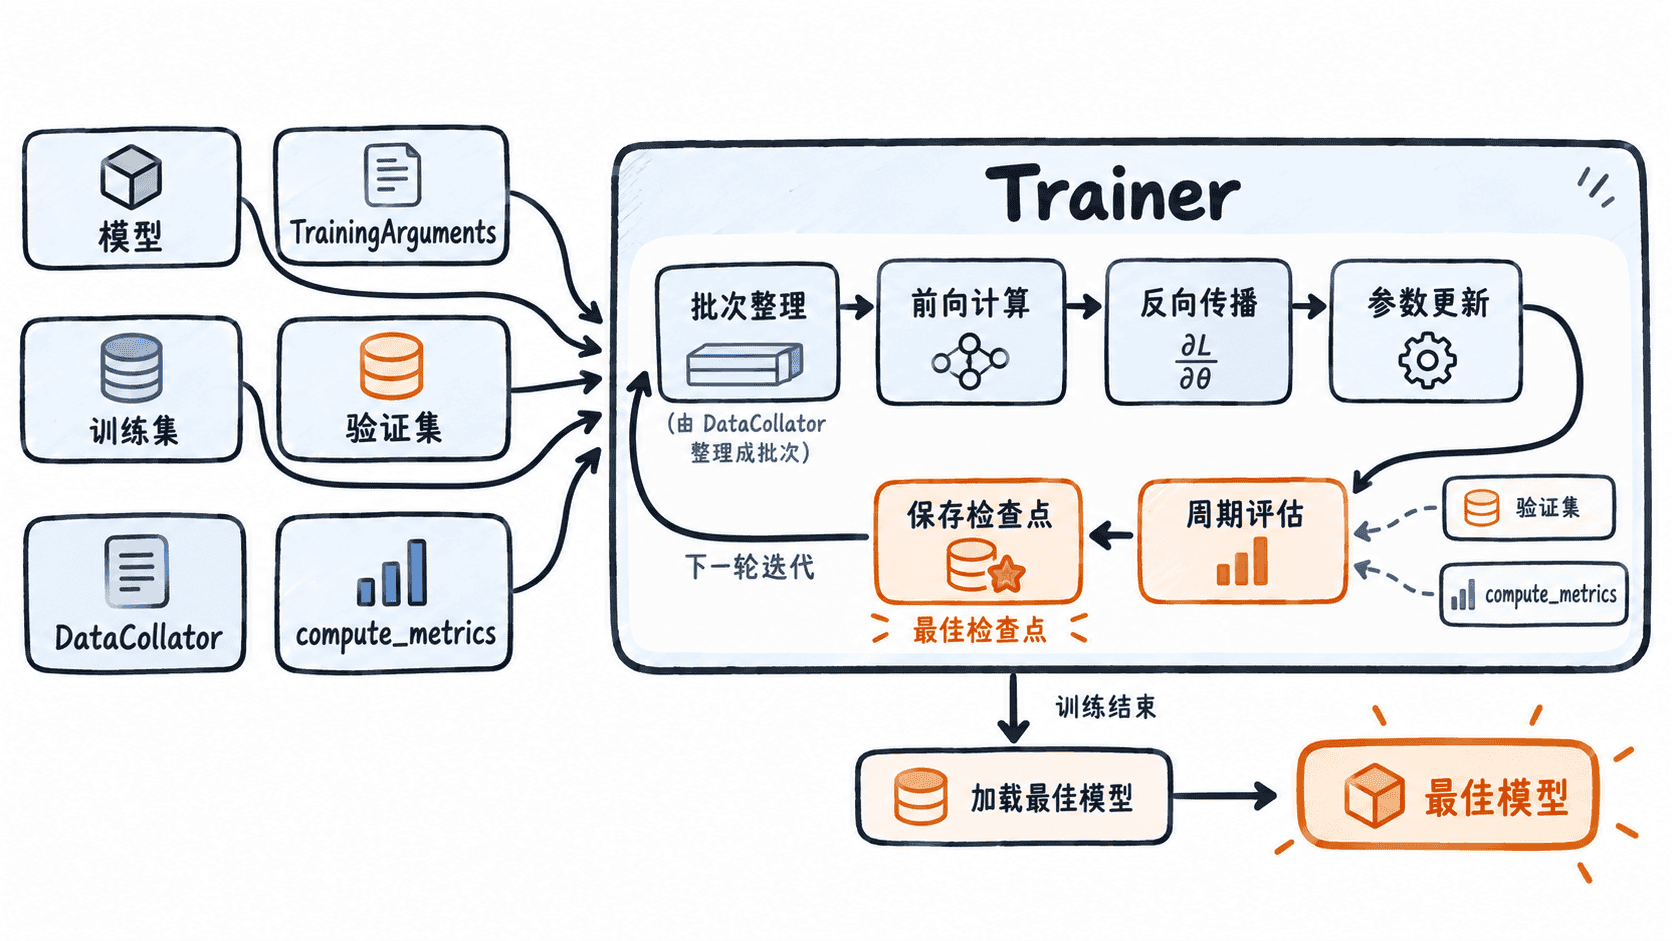
数据整理器决定如何把多条样本拼成一个批次。对于因果语言模型,DataCollatorForLanguageModeling 在 mlm=False 时会动态补齐,并把输入复制为标签,同时忽略补齐位置。指标函数则在验证阶段接收预测与标签,返回可记录的数值。
配置训练与保存策略
训练参数中最容易出错的是评估与保存节奏。启用 load_best_model_at_end=True 时,评估策略和保存策略应保持一致,例如都按 epoch 执行;否则 Trainer 无法可靠比较并恢复最佳检查点。
| 参数 | 本例作用 | 关键边界 |
|---|---|---|
per_device_train_batch_size |
设置单设备训练批次 | 显存不足时先减小 |
eval_strategy |
决定何时运行验证 | 应与保存策略对齐 |
save_strategy |
决定何时写检查点 | 频率过高会占用磁盘 |
metric_for_best_model |
指定最佳模型依据 | 使用损失时应越小越好 |
save_total_limit |
限制检查点数量 | 防止长期训练填满磁盘 |
学习率、批次大小和训练轮数决定优化强度;评估与保存参数决定过程是否可观察、结果是否可恢复。二者职责不同,不能只配置训练参数而忽略验证链路。
构建可评估训练流程
下面示例继续使用小型因果语言模型。它把六条文本划分为训练集和验证集,使用动态补齐整理批次,并计算忽略补齐位置后的下一词元准确率。该指标只用于演示指标接入,真实生成任务还应结合验证损失和人工质量评估。
import numpy as np
from datasets import Dataset
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    DataCollatorForLanguageModeling,
    Trainer,
    TrainingArguments,
)
from transformers.trainer_callback import PrinterCallback

MODEL_NAME = "sshleifer/tiny-gpt2"

texts = [
    "模型通过数据学习参数。",
    "注意力机制建立词元之间的联系。",
    "训练集用于更新模型参数。",
    "验证集用于观察泛化表现。",
    "检查点保存模型与训练状态。",
    "最佳模型应依据验证指标选择。",
]

raw_dataset = Dataset.from_dict({"text": texts})
tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token

def tokenize(batch: dict) -> dict:
    # 不在此处补齐,由数据整理器按当前批次动态处理。
    return tokenizer(
        batch["text"],
        truncation=True,
        max_length=64,
    )

tokenized = raw_dataset.map(
    tokenize,
    batched=True,
    remove_columns=["text"],
)
train_dataset = tokenized.select(range(4))
eval_dataset = tokenized.select(range(4, 6))

model = AutoModelForCausalLM.from_pretrained(MODEL_NAME)
model.config.pad_token_id = tokenizer.pad_token_id
data_collator = DataCollatorForLanguageModeling(
    tokenizer=tokenizer,
    mlm=False,
)

def preprocess_logits_for_metrics(logits, labels):
    # 先转为词元编号,避免评估阶段长期保留完整词表 logits。
    if isinstance(logits, tuple):
        logits = logits[0]
    return logits.argmax(dim=-1)

def compute_metrics(eval_pred) -> dict:
    predictions, labels = eval_pred
    predictions = predictions[:, :-1]
    labels = labels[:, 1:]
    valid = labels != -100

    accuracy = 0.0
    if np.any(valid):
        accuracy = float((predictions[valid] == labels[valid]).mean())
    return {"token_accuracy": accuracy}

training_args = TrainingArguments(
    output_dir="./trainer-output",
    per_device_train_batch_size=2,
    per_device_eval_batch_size=2,
    num_train_epochs=1,
    learning_rate=5e-5,
    eval_strategy="epoch",
    save_strategy="epoch",
    load_best_model_at_end=True,
    metric_for_best_model="eval_loss",
    greater_is_better=False,
    save_total_limit=1,
    logging_strategy="no",
    report_to="none",
    disable_tqdm=True,
    seed=42,
)

trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=train_dataset,
    eval_dataset=eval_dataset,
    data_collator=data_collator,
    processing_class=tokenizer,
    compute_metrics=compute_metrics,
    preprocess_logits_for_metrics=preprocess_logits_for_metrics,
)
trainer.remove_callback(PrinterCallback)

train_result = trainer.train()
metrics = trainer.evaluate()

print("训练步数有效:", train_result.global_step > 0)
print("包含验证损失:", "eval_loss" in metrics)
print("包含词元准确率:", "eval_token_accuracy" in metrics)
print(
    "最佳检查点存在:",
    trainer.state.best_model_checkpoint is not None,
)
预期输出
训练步数有效: True
包含验证损失: True
包含词元准确率: True
最佳检查点存在: True训练结束后,metrics 中的具体损失和准确率会随设备、依赖版本与浮点计算而变化,因此示例只验证关键字段是否存在。输出目录中会保留一个检查点;实际目录名包含动态步数,可通过 trainer.state.best_model_checkpoint 获取,不应在业务代码中写死。
读取结果并判断训练是否正常
首先观察 eval_loss 是否为有限数值,再比较多个评估周期的变化趋势。单次损失下降不能证明生成质量提升,但损失为 nan、持续剧烈上升或长时间不变,通常意味着数据、学习率、标签或数值精度存在问题。
eval_token_accuracy 只统计验证集中未被屏蔽的位置。自然语言生成存在多个合理答案,因此准确率偏低并不一定表示模型不可用。项目验收还应固定一组提示词,对训练前后输出做一致条件下的对比,并保留人工检查记录。
常见配置错误
- 只传训练集却配置评估策略,导致评估阶段缺少
eval_dataset - 开启最佳模型加载,但评估和保存策略不一致
- 自定义指标未忽略
-100,把补齐位置错误计入结果 - 保存频率过高且没有设置数量上限,导致输出目录持续增长
出现异常时,应按“数据字段、整理器输出、模型损失、评估指标、检查点状态”的顺序定位。先检查一个批次是否正确,再扩大到完整训练,通常比直接修改学习率更有效。
本课总结
- Trainer 统一协调模型、参数、数据、整理器和评估函数
- 评估策略与保存策略应对齐,才能可靠恢复最佳检查点
- 训练验收既要检查损失和指标,也要确认检查点与推理效果
下一课预告
下一课将围绕训练产物的保存、重新加载和推理验证,建立从训练脚本到可复用模型目录的完整交付流程。