
大模型原理与训练 / 系统课时
序列建模解决什么问题
序列建模解决什么问题
序列建模要解决的核心问题,是让模型不仅看到“有哪些数据”,还理解“这些数据按什么顺序出现”。学完本课,你将能识别文本、语音和时间序列中的顺序依赖,并判断任务的输入、输出与建模目标。
学习目标
- 理解序列数据与普通表格数据的区别
- 识别局部依赖、长距离依赖和上下文关系
- 判断常见序列任务的输入输出形式
序列数据与依赖关系
序列数据由一组按先后顺序排列的元素组成。元素可能是词、字符、音频帧、传感器读数,也可能是用户连续发生的行为。与普通表格数据相比,序列中的位置不能随意交换,因为顺序往往直接决定含义。
例如,“我喜欢这部电影”和“这部电影喜欢我”包含相近的词,但语义完全不同。温度记录也是如此:连续升温与连续降温即使数值集合相同,代表的趋势也不同。
模型还要判断不同位置之间的依赖。局部依赖常见于短语、音节和短期波动;长距离依赖可能跨越多个句子或较长时间窗口,例如文章开头的主体会影响后文代词的指代,设备数小时前的异常也可能解释当前故障。
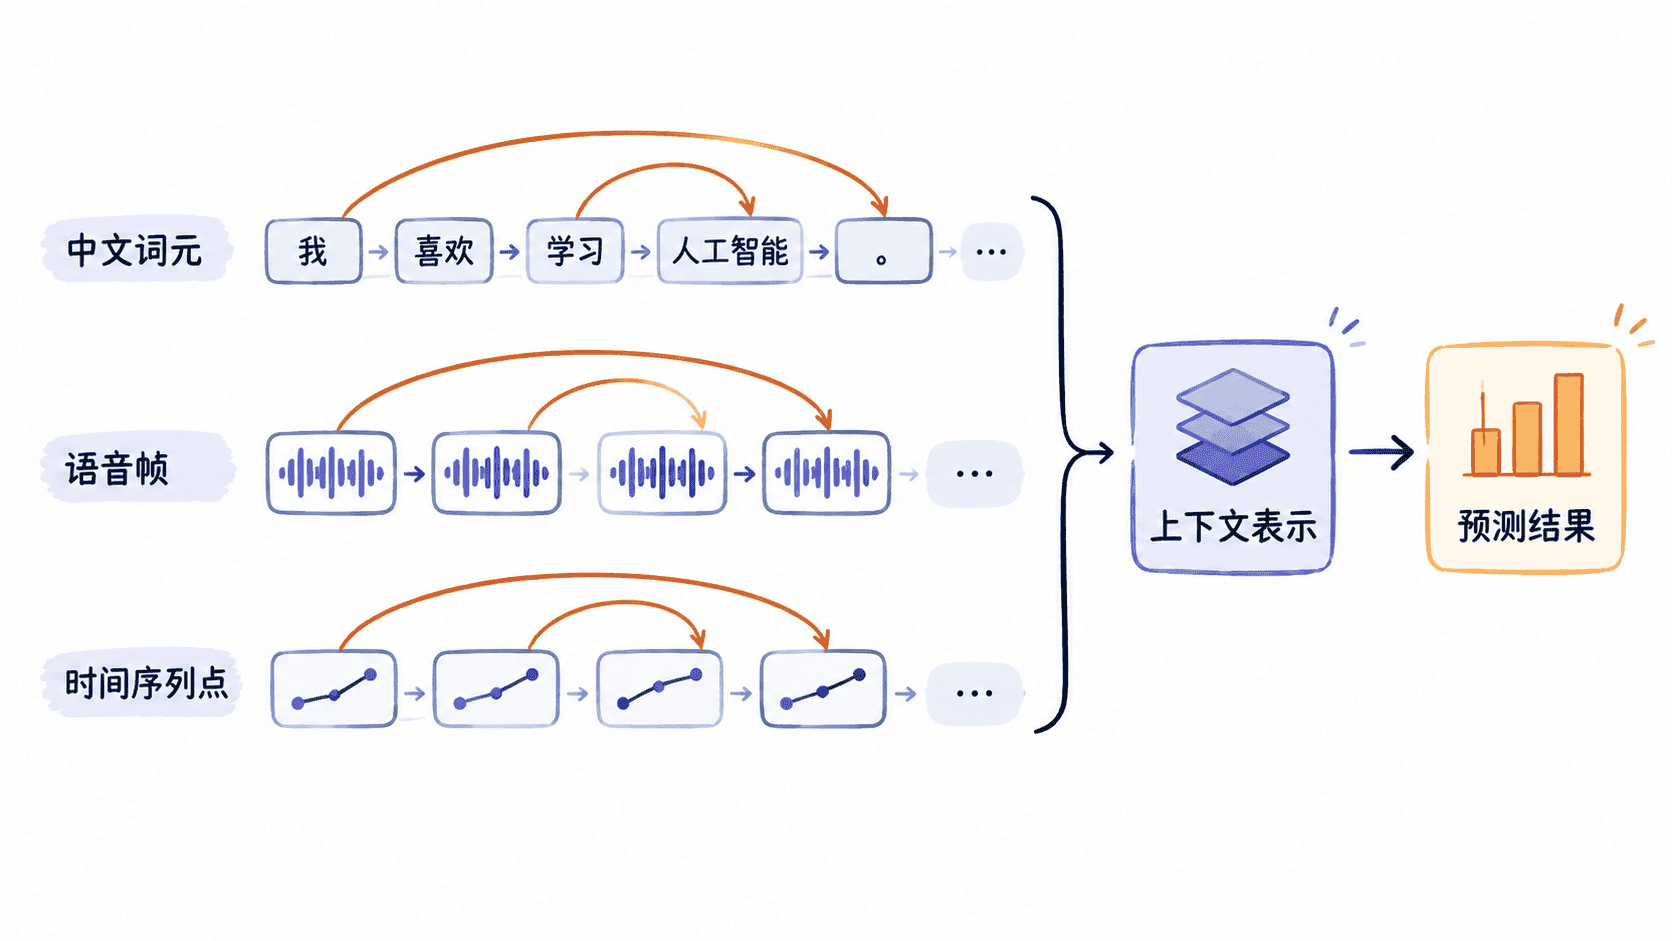
输入输出形态
多对一任务接收完整序列后输出一个结果,例如根据评论判断情感。多对多任务为多个位置分别生成结果,例如给每个词标注词性。序列到序列任务把一个序列转换为另一个序列,例如机器翻译和语音识别。
还有一类常见方式是自回归生成:模型根据已有内容预测下一个元素,再把新结果加入输入继续预测。文本生成、代码补全和时间序列滚动预测都采用这一基本思路。
无论输出形式如何,模型都需要把分散的元素组合成上下文表示,再利用该表示完成分类、标注、转换或预测。
典型应用与判断方法
判断一个问题是否需要序列建模,可以依次检查三个条件:数据是否存在稳定顺序,交换位置是否会改变含义,当前输出是否依赖前面或后面的信息。只要这些条件明显成立,就需要显式处理顺序与上下文。
文本任务关注词和句子的组合关系;语音任务关注连续声学帧的变化;时间序列任务关注趋势、周期和突发波动;行为序列则关注用户动作之间的前后影响。它们的数据形式不同,但共同目标都是从顺序中提取可用于预测的结构。
本课总结
- 序列建模同时关注元素内容、位置顺序和上下文依赖
- 序列任务可表现为多对一、多对多或序列到序列
- 是否需要序列模型,关键看顺序改变后语义或结果是否变化
下一课预告
下一课将比较 RNN 与 CNN 在序列任务中的处理方式,重点分析它们面对长距离依赖和并行计算时的限制。