
大模型原理与训练 / 系统课时
贪心与束搜索
贪心与束搜索
自回归模型每次只预测下一个词元,但最终质量取决于整条序列。本文用同一组概率演示贪心解码与束搜索如何保留候选、为何可能得到不同结果,以及应怎样在生成质量与计算成本之间取舍。
学习目标
- 说清贪心解码与束搜索的候选保留机制
- 根据束宽判断搜索质量、延迟和显存开销
- 用可运行示例验证局部最优不一定等于序列最优
两种方法在搜索什么
设模型在第 步根据已有前缀 给出下一个词元的条件概率。完整序列的概率是各步条件概率的乘积:
实际实现通常累加对数概率,避免大量小数相乘造成下溢。解码器的任务不是修改模型参数,而是在每一步给出的词表概率中决定保留哪些前缀,直到生成结束标记或达到长度上限。
贪心解码:每步只留第一名
贪心解码在每一步选择当前概率最大的词元,然后永久丢弃其他候选。它只维护一条前缀,因此实现简单、搜索开销低,输出也完全确定。
问题在于早期选择无法撤销。某个词元当前概率最高,不代表它接上后续词元后的整条序列概率最高。对格式固定、答案较短或延迟敏感的任务,贪心解码通常足够;对翻译、摘要等需要全局连贯性的任务,它可能过早锁定次优路径。
束搜索:同时保留多条前缀
束搜索用束宽 控制每一步保留的候选数量。每轮先扩展现有的 条前缀,再按累计对数概率排序,只留下分数最高的 条。遇到结束标记的候选可以进入完成集合,未结束候选继续扩展。
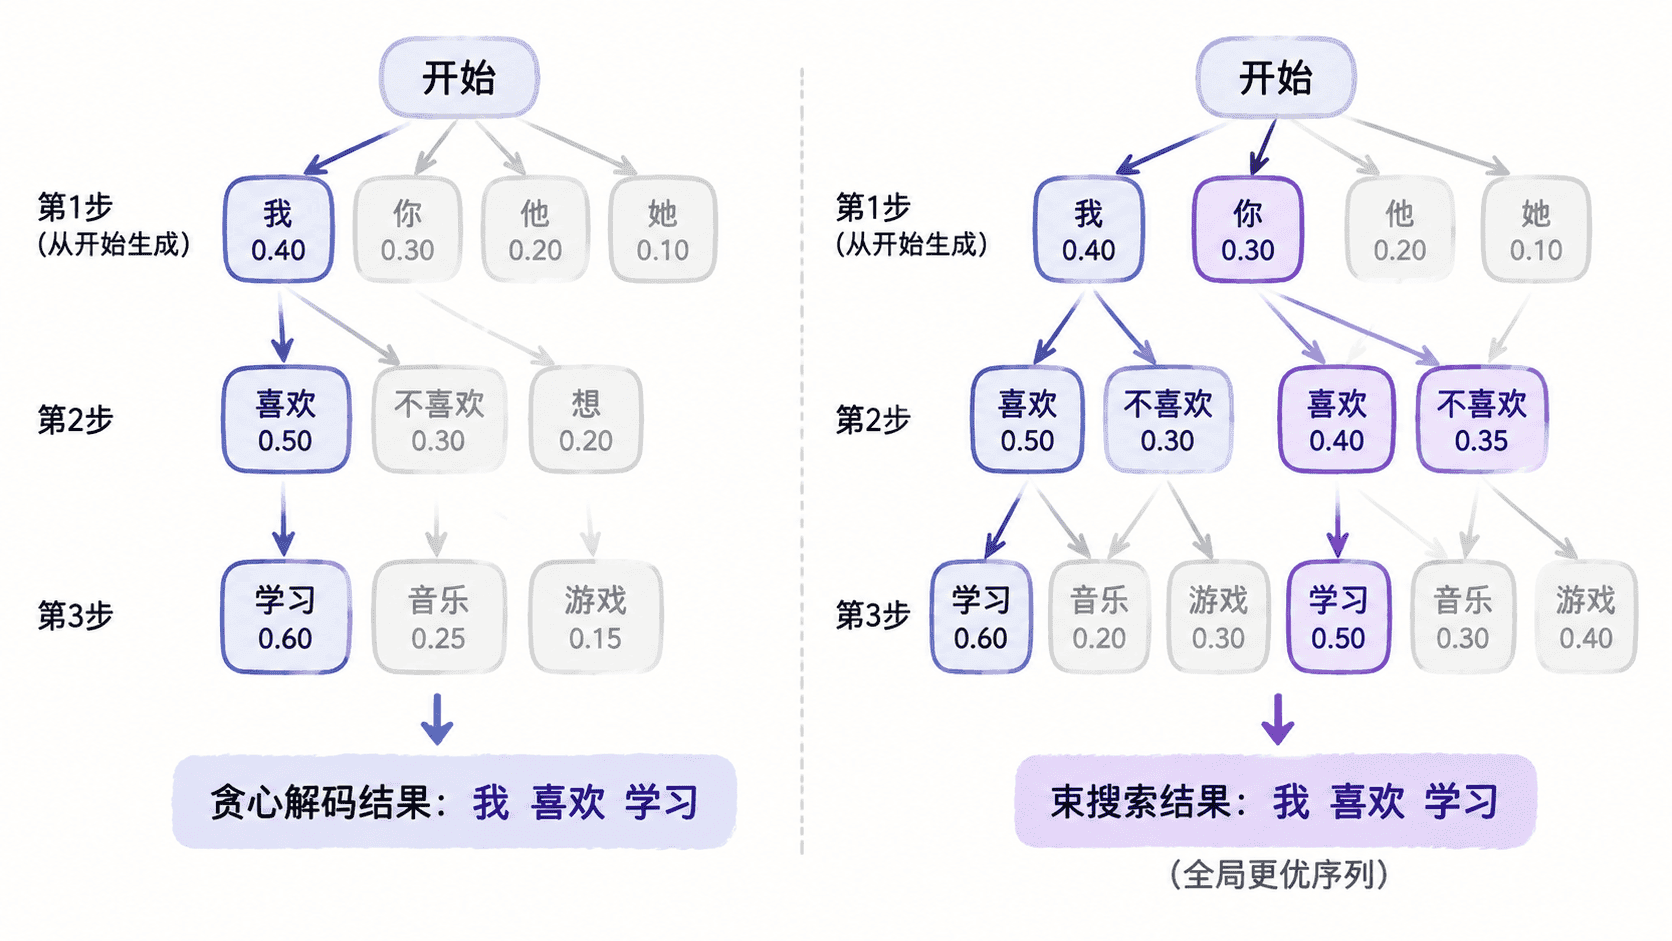
束宽越大,搜索覆盖越广,但每一步需要评估和排序更多候选。束搜索还常配合长度惩罚,否则累计对数概率会天然偏向较短序列。束宽增大也不保证质量无限提升,过宽可能让输出更保守、重复或缺少多样性。
可运行示例:局部最优与序列最优
下面的概率表故意让首步的 A 略高于 B,但 B 后续接 X 的概率更高。代码只依赖 Python 标准库。
import math

PROB_TABLE = {
    "": {"A": 0.55, "B": 0.45},
    "A": {"X": 0.51, "Y": 0.49},
    "B": {"X": 0.90, "Y": 0.10},
    "AX": {"<eos>": 1.0},
    "AY": {"<eos>": 1.0},
    "BX": {"<eos>": 1.0},
    "BY": {"<eos>": 1.0},
}

def greedy_decode(max_steps: int = 3) -> tuple[str, float]:
    prefix = ""
    log_score = 0.0

    for _ in range(max_steps):
        token, probability = max(
            PROB_TABLE[prefix].items(),
            key=lambda item: item[1],
        )
        log_score += math.log(probability)
        if token == "<eos>":
            break
        prefix += token

    return prefix, math.exp(log_score)

def beam_search(beam_width: int = 2, max_steps: int = 3) -> tuple[str, float]:
    beams = [("", 0.0, False)]

    for _ in range(max_steps):
        candidates = []
        for prefix, log_score, finished in beams:
            if finished:
                candidates.append((prefix, log_score, True))
                continue

            # 扩展当前束中的每一条前缀,再按累计分数统一竞争。
            for token, probability in PROB_TABLE[prefix].items():
                next_prefix = prefix if token == "<eos>" else prefix + token
                candidates.append(
                    (
                        next_prefix,
                        log_score + math.log(probability),
                        token == "<eos>",
                    )
                )

        beams = sorted(
            candidates,
            key=lambda item: item[1],
            reverse=True,
        )[:beam_width]

        if all(finished for _, _, finished in beams):
            break

    best_prefix, best_log_score, _ = beams[0]
    return best_prefix, math.exp(best_log_score)

greedy_text, greedy_score = greedy_decode()
beam_text, beam_score = beam_search()

print(f"greedy: {greedy_text}, probability={greedy_score:.4f}")
print(f"beam:   {beam_text}, probability={beam_score:.4f}")
预期输出:
greedy: AX, probability=0.2805
beam:   BX, probability=0.4050
贪心解码首步选择 A 后无法回退,最终得到 AX。束宽为 2 时,A 和 B 都被保留,因此第二步能够发现累计概率更高的 BX。
质量、成本与选择建议
| 维度 | 贪心解码 | 束搜索 |
|---|---|---|
| 候选数量 | 每步 1 条 | 每步最多 条 |
| 确定性 | 相同输入得到相同输出 | 相同输入和参数得到相同输出 |
| 搜索开销 | 约为 | 约为 |
| 典型特点 | 快,但容易陷入局部最优 | 更重视整体分数,但延迟更高 |
其中 是生成长度, 是词表规模。真实系统通常会用批量矩阵计算和 KV Cache 降低重复计算,但束宽增加仍会近似线性提高解码阶段的计算量与缓存占用。
低延迟问答、分类式输出或严格确定性场景可优先使用贪心解码。机器翻译、语音识别和结构化候选生成可以从较小束宽开始,例如 2~5,再结合离线指标和线上延迟决定是否扩大。开放式创作通常不宜只靠束搜索,因为它更偏向高概率、保守的表达。
本课总结
- 贪心解码只保留当前最优词元,速度快,但无法纠正早期错误
- 束搜索保留多条高分前缀,可能找到更优序列,同时增加计算和缓存开销
- 束宽不是越大越好,应结合任务类型、长度惩罚、质量指标和延迟共同调节
下一课预告
下一课将从确定性搜索转向随机采样,学习温度、Top-k 和 Top-p 如何控制输出的稳定性与多样性。