
大模型原理与训练 / 系统课时
数据清洗与划分
数据清洗与划分
本课把一份原始文本分类数据整理成可训练、可验证、可测试的标准数据集。最终会得到去重、过滤异常、处理标签冲突后的三个 CSV 文件,并通过分层抽样保证各标签比例基本稳定。
学习目标
- 识别空文本、非法标签、重复样本和标签冲突。
- 使用固定随机种子完成训练集、验证集和测试集划分。
- 验证三个数据集之间无重复、标签分布可接受。
先定义输入与验收标准
假设原始文件为 data/raw.csv,至少包含 id、text、label 三列。id 用于追踪原始记录,text 是模型输入,label 是分类标签。清洗后只保留非空文本和允许标签,并把文本中的连续空白统一为单个空格。
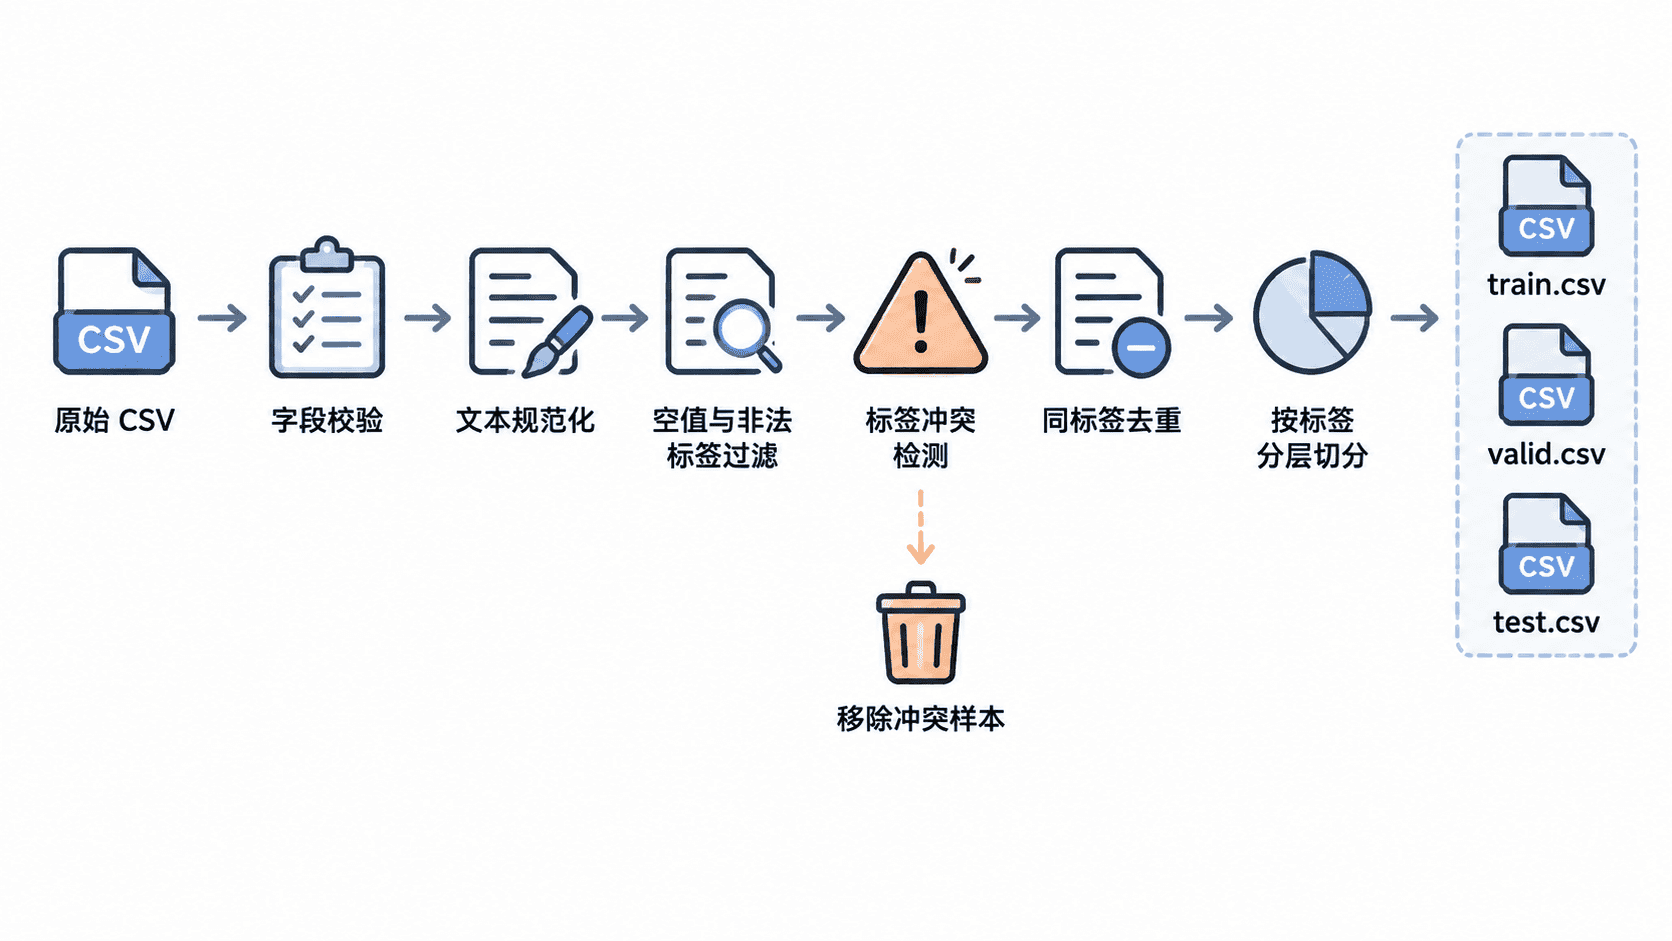
划分采用 80% 训练集、10% 验证集、10% 测试集。三份数据必须互不重叠;同一规范化文本若对应多个标签,应整体移除,而不是随意保留其中一个标签。
清洗与划分实现
下面的脚本会创建输出目录,检查列名和标签,移除冲突样本,再使用固定随机种子进行两次分层切分。为避免小样本标签导致分层失败,脚本要求每个标签至少有 10 条有效记录。
from pathlib import Path
import re

import pandas as pd
from sklearn.model_selection import train_test_split

RAW_PATH = Path("data/raw.csv")
OUTPUT_DIR = Path("data/processed")
ALLOWED_LABELS = {"positive", "negative", "neutral"}
RANDOM_SEED = 42

def normalize_text(value: object) -> str:
    text = "" if pd.isna(value) else str(value)
    return re.sub(r"\s+", " ", text).strip()

def main() -> None:
    df = pd.read_csv(RAW_PATH)
    required = {"id", "text", "label"}
    missing = required - set(df.columns)
    if missing:
        raise ValueError(f"缺少字段: {sorted(missing)}")

    raw_rows = len(df)
    df = df.loc[:, ["id", "text", "label"]].copy()
    df["text"] = df["text"].map(normalize_text)
    df["label"] = df["label"].astype(str).str.strip()

    # 先过滤空文本和非法标签,再处理重复与冲突。
    df = df[(df["text"] != "") & df["label"].isin(ALLOWED_LABELS)]

    label_counts_per_text = df.groupby("text")["label"].nunique()
    conflict_texts = set(label_counts_per_text[label_counts_per_text > 1].index)
    df = df[~df["text"].isin(conflict_texts)]
    df = df.drop_duplicates(subset=["text", "label"], keep="first")

    counts = df["label"].value_counts()
    too_small = counts[counts < 10]
    if not too_small.empty:
        raise ValueError(f"以下标签样本不足 10 条: {too_small.to_dict()}")

    train_df, temp_df = train_test_split(
        df,
        test_size=0.2,
        random_state=RANDOM_SEED,
        stratify=df["label"],
    )
    valid_df, test_df = train_test_split(
        temp_df,
        test_size=0.5,
        random_state=RANDOM_SEED,
        stratify=temp_df["label"],
    )

    # 划分后再次确认规范化文本没有跨集合泄漏。
    train_texts = set(train_df["text"])
    valid_texts = set(valid_df["text"])
    test_texts = set(test_df["text"])
    assert train_texts.isdisjoint(valid_texts)
    assert train_texts.isdisjoint(test_texts)
    assert valid_texts.isdisjoint(test_texts)

    OUTPUT_DIR.mkdir(parents=True, exist_ok=True)
    train_df.to_csv(OUTPUT_DIR / "train.csv", index=False)
    valid_df.to_csv(OUTPUT_DIR / "valid.csv", index=False)
    test_df.to_csv(OUTPUT_DIR / "test.csv", index=False)

    print(f"raw={raw_rows}, cleaned={len(df)}, conflicts={len(conflict_texts)}")
    print(f"train={len(train_df)}, valid={len(valid_df)}, test={len(test_df)}")

if __name__ == "__main__":
    main()
预期输出如下,尖括号中的数量会随实际数据变化:
raw=<RAW_ROWS>, cleaned=<CLEANED_ROWS>, conflicts=<CONFLICT_TEXTS>
train=<TRAIN_ROWS>, valid=<VALID_ROWS>, test=<TEST_ROWS>脚本执行完成后,data/processed 目录中应出现 train.csv、valid.csv 和 test.csv。三个文件保留相同字段,后续训练脚本可以直接读取。
验证切分质量
除了确认文件存在,还要检查标签比例。训练集、验证集和测试集中每个标签的占比不必完全相同,但应接近总体分布。若某个标签在验证集或测试集中缺失,通常说明该标签样本太少,不能直接依赖随机划分。
还应保存随机种子、允许标签集合和原始数据版本。数据内容变化后,即使随机种子相同,划分结果也可能变化,因此实验记录需要同时标明输入文件版本或校验值。
常见失败与修复
train_test_split 报分层样本不足时,不要关闭 stratify 直接继续。应先补充稀有标签数据、合并不合理标签,或采用按业务规则构造验证集。若清洗后样本骤减,则优先统计非法标签、空文本和冲突文本数量,确认过滤规则是否过严。
同一文本跨集合出现会造成数据泄漏,使验证指标虚高。去重必须发生在划分之前,而且比较依据应使用规范化后的文本,而不是未经处理的原始字符串。
本课总结
- 清洗顺序应为字段校验、文本规范化、异常过滤、冲突处理、去重和分层划分。
- 固定随机种子只能保证同一输入数据上的可复现,不能替代数据版本记录。
- 划分完成后必须验证集合互斥和标签分布,防止数据泄漏与评估失真。
下一课预告
下一课将基于这三份数据建立可复现的基线训练流程,记录验证集与测试集指标,并保存模型和实验元数据。