
大模型原理与训练 / 系统课时
损失不下降排查
损失不下降排查
本课解决 Transformer 训练中损失几乎不变、持续震荡或直接变成异常值的问题。你将建立一条从输入数据到参数更新的排查链路,并用单批过拟合测试快速判断故障位于数据、前向计算还是反向传播。
学习目标
- 区分损失停滞、震荡、发散和数值异常
- 按固定顺序检查标签、掩码、学习率、梯度与模型连接
- 使用单批过拟合测试验证完整训练链路
先判断是哪一种“不下降”
先观察曲线形态,不要只看某一个 step。损失保持在随机猜测附近,通常表示标签、输入或参数更新链路失效;大幅震荡多与学习率、批次或异常样本有关;持续升高说明优化方向不稳定;出现 NaN 或 Inf 则优先检查数值溢出、非法标签和混合精度。
还要确认记录的是训练损失还是验证损失。训练损失下降而验证损失不降,通常是过拟合或数据分布差异,不属于“模型完全学不动”。
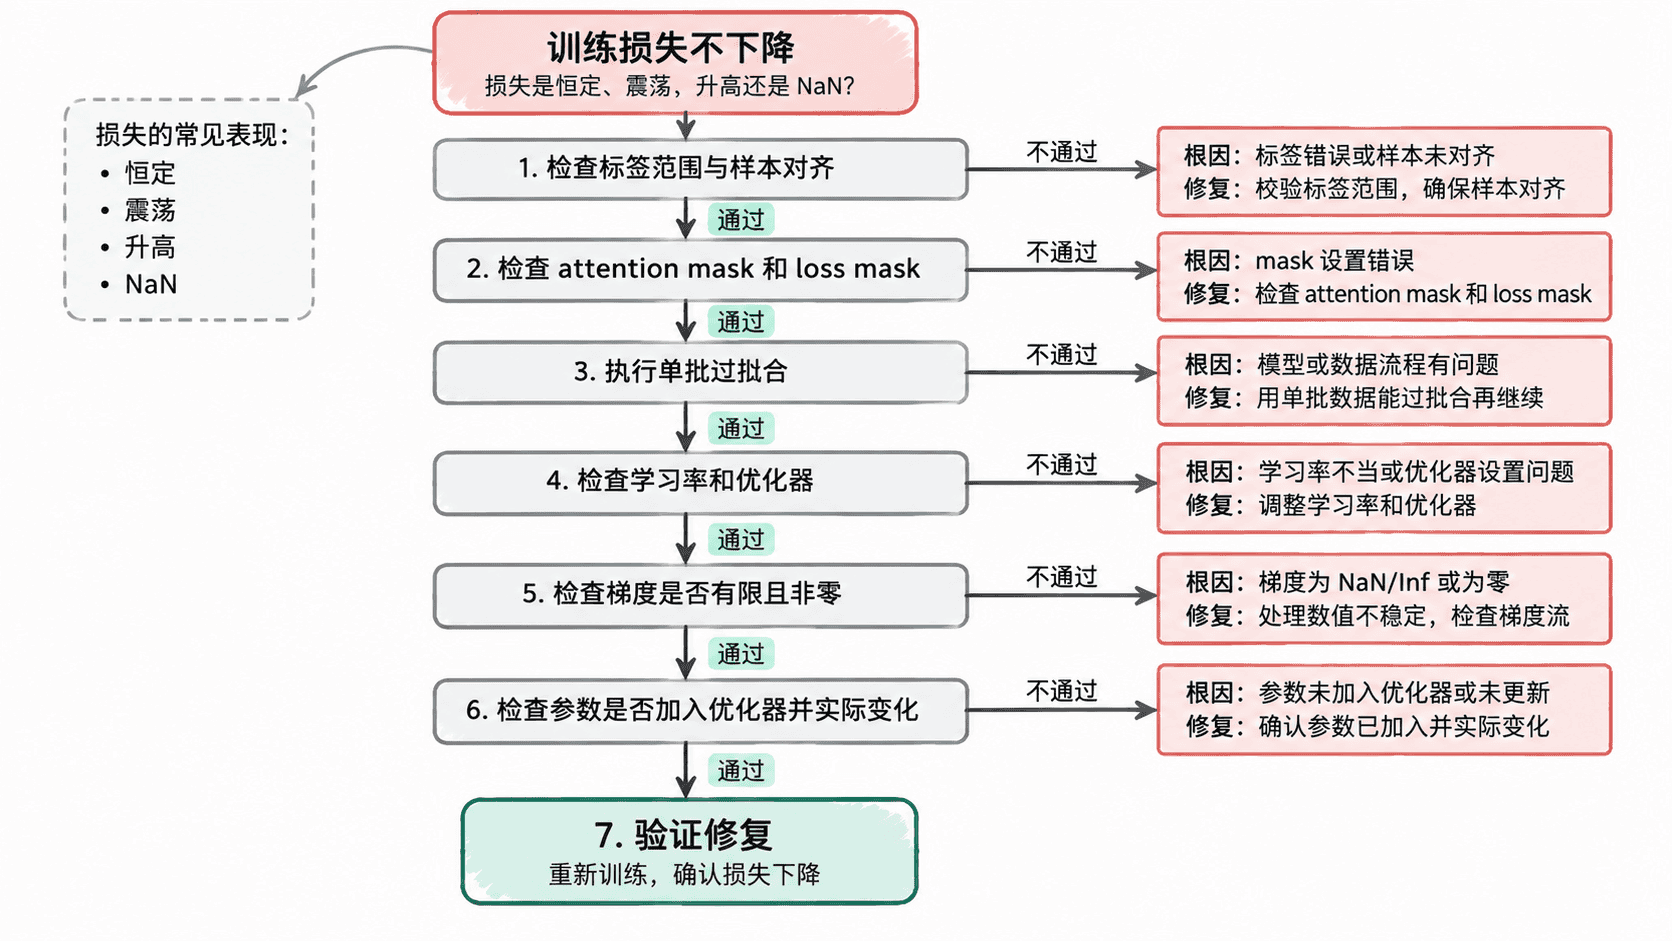
按数据到参数的顺序定位
排查顺序应沿训练链路前进,避免一开始就盲目改学习率。先确认输入和标签,再确认掩码与损失,接着检查反向传播,最后检查优化器是否真的更新了目标参数。
| 检查点 | 正常表现 | 常见根因 |
|---|---|---|
| 标签 | 分类标签位于 [0, num_classes),与样本一一对应 |
标签偏移、错位、全部相同 |
| 掩码 | 有效 token 为 1,填充位置为 0,损失忽略填充标签 |
掩码取反、全零、广播维度错误 |
| 学习率 | 前几十步损失总体下降且不爆炸 | 过小不动、过大震荡 |
| 梯度 | 主要参数梯度有限且至少部分非零 | detach、no_grad、被冻结 |
| 参数更新 | optimizer.step() 后参数发生变化 |
参数未加入优化器、漏掉 step() |
| 模型连接 | logits 由当前批次和可训练层计算得到 | 错接缓存、分类头未使用 |
用单批过拟合验证训练链路
单批过拟合是最有效的定位方法之一:固定一个很小的批次,关闭随机增强,反复训练几十到几百步。正常模型应能把这批样本的损失明显压低;如果做不到,优先怀疑实现错误,而不是模型容量不足。
下面脚本同时检查标签范围、有效掩码比例、梯度范数和参数变化。它使用一个带掩码平均池化的最小分类模型,可直接运行并验证排查方法。
import copy
import math

import torch
from torch import nn

class MaskedClassifier(nn.Module):
    def __init__(self, vocab_size: int = 50, hidden_size: int = 32, num_classes: int = 2):
        super().__init__()
        self.embedding = nn.Embedding(vocab_size, hidden_size, padding_idx=0)
        self.classifier = nn.Linear(hidden_size, num_classes)

    def forward(self, input_ids: torch.Tensor, attention_mask: torch.Tensor) -> torch.Tensor:
        hidden = self.embedding(input_ids)
        weights = attention_mask.unsqueeze(-1).float()
        # 分母至少为 1,避免全填充样本产生除零
        pooled = (hidden * weights).sum(dim=1) / weights.sum(dim=1).clamp_min(1.0)
        return self.classifier(pooled)

def total_grad_norm(model: nn.Module) -> float:
    squared_sum = 0.0
    for parameter in model.parameters():
        if parameter.grad is not None:
            squared_sum += parameter.grad.detach().pow(2).sum().item()
    return math.sqrt(squared_sum)

def parameters_changed(before: dict[str, torch.Tensor], model: nn.Module) -> bool:
    return any(
        not torch.equal(before[name], parameter.detach())
        for name, parameter in model.named_parameters()
    )

def main() -> None:
    torch.manual_seed(7)
    input_ids = torch.tensor(
        [
            [1, 2, 3, 0, 0],
            [4, 5, 6, 7, 0],
            [8, 9, 0, 0, 0],
            [10, 11, 12, 13, 14],
        ],
        dtype=torch.long,
    )
    attention_mask = (input_ids != 0).long()
    labels = torch.tensor([0, 1, 0, 1], dtype=torch.long)

    model = MaskedClassifier()
    loss_fn = nn.CrossEntropyLoss()
    optimizer = torch.optim.AdamW(model.parameters(), lr=0.05)
    initial_parameters = {
        name: copy.deepcopy(parameter.detach())
        for name, parameter in model.named_parameters()
    }

    assert labels.min().item() >= 0
    assert labels.max().item() < 2
    assert attention_mask.shape == input_ids.shape
    print(f"valid_token_ratio={attention_mask.float().mean().item():.2f}")

    first_loss = None
    last_grad_norm = 0.0
    for step in range(101):
        optimizer.zero_grad()
        logits = model(input_ids, attention_mask)
        loss = loss_fn(logits, labels)
        if first_loss is None:
            first_loss = loss.item()
        loss.backward()
        last_grad_norm = total_grad_norm(model)
        optimizer.step()
        if step in {0, 20, 100}:
            print(f"step={step} loss={loss.item():.4f}")

    print(f"grad_norm_finite={math.isfinite(last_grad_norm)}")
    print(f"parameters_changed={parameters_changed(initial_parameters, model)}")
    print(f"loss_decreased={loss.item() < first_loss}")

if __name__ == "__main__":
    main()
运行脚本:
python diagnose_loss.py预期结果是损失在固定批次上明显下降,梯度有限且参数发生变化。具体损失数值会因 PyTorch 版本略有差异。
valid_token_ratio=0.70
step=0 loss=<INITIAL_LOSS>
step=20 loss=<LOWER_LOSS>
step=100 loss=<NEAR_ZERO_LOSS>
grad_norm_finite=True
parameters_changed=True
loss_decreased=True
根据诊断结果锁定根因
如果标签断言失败,先检查类别编号是否从 0 开始、标签是否在分词或批处理后发生错位,以及生成任务中被忽略的位置是否使用了正确的忽略值。标签全相同也会让模型看似快速收敛,但没有真实学习价值。
如果有效 token 比例异常接近 0,重点检查 attention_mask 是否被取反、是否在维度扩展时广播错误,以及填充 token 是否与真实 token 共用编号。生成任务还要单独检查 loss mask,确保提示词或填充位置没有被错误计入损失。
如果梯度为零或不存在,检查前向结果是否经过 detach()、是否误用了 torch.no_grad()、目标层是否被冻结,以及损失是否真的由当前 logits 计算。梯度为 NaN 或 Inf 时,应先降低学习率、关闭混合精度并检查输入中是否存在异常值。
如果梯度正常但参数不变,检查优化器参数列表、optimizer.step() 的调用位置,以及是否在每步之后重新加载了旧权重。使用参数高效微调时,还要确认 LoRA 或 Adapter 参数确实设置为 requires_grad=True。
如果单批能够过拟合,而完整数据仍不下降,训练链路大概率正常。此时再检查数据噪声、类别不平衡、学习率计划、批次构成和训练集难度,避免把数据问题误判成代码故障。
修复后如何验收
修复后先重复单批过拟合,确认损失持续下降、梯度有限且参数变化。随后恢复小规模真实数据运行几十个 step,观察训练损失总体趋势,并抽查预测是否随输入变化。
最后再恢复完整训练配置。一次只恢复一个可能引发问题的功能,例如混合精度、梯度累积、分布式训练或复杂数据增强;这样问题复现时可以明确归因。
本课总结
- 损失不下降应沿标签、掩码、损失、梯度、优化器和参数更新的顺序排查
- 单批过拟合能快速区分训练链路故障与数据规模、泛化或任务难度问题
- 梯度存在不等于参数已更新,还必须确认目标参数进入优化器并在
step()后发生变化
下一课预告
下一课将进一步处理训练中的显存溢出、数值不稳定和吞吐下降,并建立资源与性能联合排查方法。