
大模型原理与训练 / 系统课时
手写自注意力层
手写自注意力层
本课将使用 PyTorch 从零实现单头自注意力模块,把输入依次投影为查询、键和值,并通过形状检查与权重行和验证模块是否正确工作。
学习目标
- 理解单头自注意力层内部各张量的职责与形状
- 使用
nn.Module实现查询、键、值和输出投影 - 验证输出形状、注意力权重形状及概率归一化结果
模块要完成什么
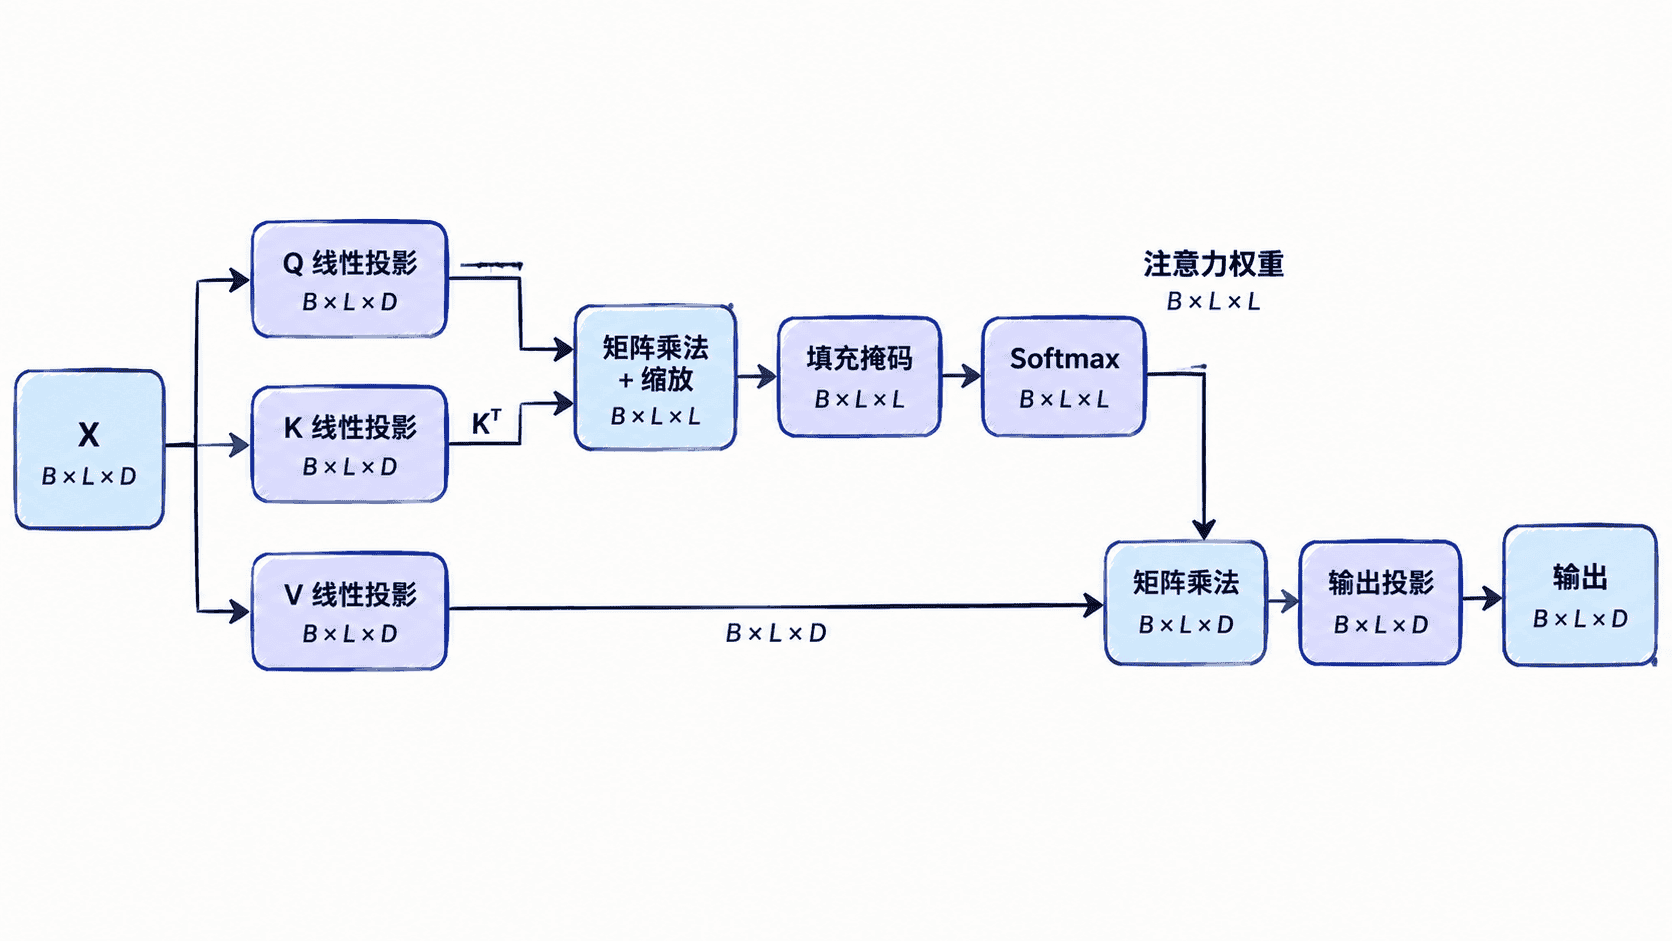
输入张量形状约定为 [batch_size, sequence_length, d_model]。自注意力层先通过三个独立线性层得到 、、,再计算缩放点积分数、应用可选填充掩码、执行 Softmax,最后用注意力权重对 做加权求和。
单头实现中,下面的示例让查询、键和值的维度都等于 d_model。这不是唯一设计,但能让数据流最直观。输出投影用于把注意力结果重新映射到模型维度,也为后续扩展多头注意力保留一致接口。
完整实现
下面实现一个可直接运行的 SingleHeadSelfAttention。为了让预期输出稳定,示例把四个线性层的权重都设置为单位矩阵;真实训练时应保留 PyTorch 的随机初始化并由反向传播学习参数。
import math

import torch
from torch import nn

class SingleHeadSelfAttention(nn.Module):
    def __init__(self, d_model: int) -> None:
        super().__init__()
        self.d_model = d_model

        # 四个投影层保持相同模型维度,便于残差连接
        self.q_proj = nn.Linear(d_model, d_model, bias=False)
        self.k_proj = nn.Linear(d_model, d_model, bias=False)
        self.v_proj = nn.Linear(d_model, d_model, bias=False)
        self.out_proj = nn.Linear(d_model, d_model, bias=False)

    def forward(
        self,
        x: torch.Tensor,
        key_padding_mask: torch.Tensor | None = None,
    ) -> tuple[torch.Tensor, torch.Tensor]:
        q = self.q_proj(x)
        k = self.k_proj(x)
        v = self.v_proj(x)

        scores = q @ k.transpose(-2, -1)
        scores = scores / math.sqrt(self.d_model)

        if key_padding_mask is not None:
            # True 表示有效键,False 表示需要屏蔽的填充键
            scores = scores.masked_fill(
                ~key_padding_mask[:, None, :],
                float("-inf"),
            )

        weights = torch.softmax(scores, dim=-1)
        context = weights @ v
        output = self.out_proj(context)
        return output, weights

torch.set_printoptions(precision=4, sci_mode=False)

layer = SingleHeadSelfAttention(d_model=4)
identity = torch.eye(4)

with torch.no_grad():
    for projection in (
        layer.q_proj,
        layer.k_proj,
        layer.v_proj,
        layer.out_proj,
    ):
        projection.weight.copy_(identity)

x = torch.tensor([[
    [1.0, 0.0, 0.0, 0.0],
    [0.0, 1.0, 0.0, 0.0],
    [1.0, 1.0, 0.0, 0.0],
]])
valid_tokens = torch.tensor([[True, True, True]])

output, weights = layer(x, valid_tokens)

print("output shape:", output.shape)
print("weights shape:", weights.shape)
print("row sums:", weights.sum(dim=-1).detach())
print("weights:")
print(weights.detach())
预期输出:
output shape: torch.Size([1, 3, 4])
weights shape: torch.Size([1, 3, 3])
row sums: tensor([[1., 1., 1.]])
weights:
tensor([[[0.3837, 0.2327, 0.3837],
         [0.2327, 0.3837, 0.3837],
         [0.2741, 0.2741, 0.4519]]])
输出仍保持 [1, 3, 4],说明每个词元都得到一个新的四维表示。权重形状为 [1, 3, 3],表示三个查询分别对三个键分配概率;每一行之和为 1,说明 Softmax 归一化正确。
读懂形状变化
设批量大小为 、序列长度为 、模型维度为 。三个投影后的形状仍是 。k.transpose(-2, -1) 将键变为 ,因此分数矩阵形状为 。
分数矩阵的倒数第二维对应查询位置,最后一维对应键位置。Softmax 必须沿最后一维执行,才能让每个查询对全部键的权重和为 1。若误写到其他维度,代码仍可能运行,但注意力语义已经改变。
实现边界与扩展
这个模块只包含注意力核心,没有加入 Dropout、残差连接和 LayerNorm。完整 Transformer 编码器通常在注意力层外组合这些结构,因此不要把它直接等同于整个编码器层。
当查询和键的投影维度改为 时,缩放因子也应改为 ,而不是固定使用 d_model。扩展为多头注意力时,还需要把通道拆分为多个头并在计算后重新拼接;但每个头内部仍遵循本课的同一套步骤。
本课总结
- 单头自注意力由 Q、K、V 投影、缩放点积、Softmax、加权求和和输出投影组成
- 正确实现必须重点检查分数矩阵形状和 Softmax 所在维度
- 权重每行和为 1、输出维度保持不变,是最基本的验收条件
下一课预告
下一课将进一步引入因果掩码,使当前位置只能关注自身及之前的词元,为自回归生成建立信息边界。