
大模型原理与训练 / 系统课时
解码器层实现
解码器层实现
本课把解码器的三个核心子层组合成一个可运行模块:先用因果自注意力处理目标序列,再读取编码器记忆,最后通过前馈网络变换,并用残差连接和层归一化稳定训练。
学习目标
- 按正确顺序组合因果自注意力、交叉注意力和前馈网络
- 正确传递目标掩码与编码器填充掩码
- 通过张量形状和有限值检查验证实现
层结构与数据流
这里采用 Pre-LN 结构:每个子层在计算前先做层归一化,子层输出经过 Dropout 后再与残差相加。其执行顺序为:
- 目标序列归一化后进入因果自注意力
- 更新后的目标状态作为查询,编码器输出作为键和值进入交叉注意力
- 再次归一化后进入逐位置前馈网络
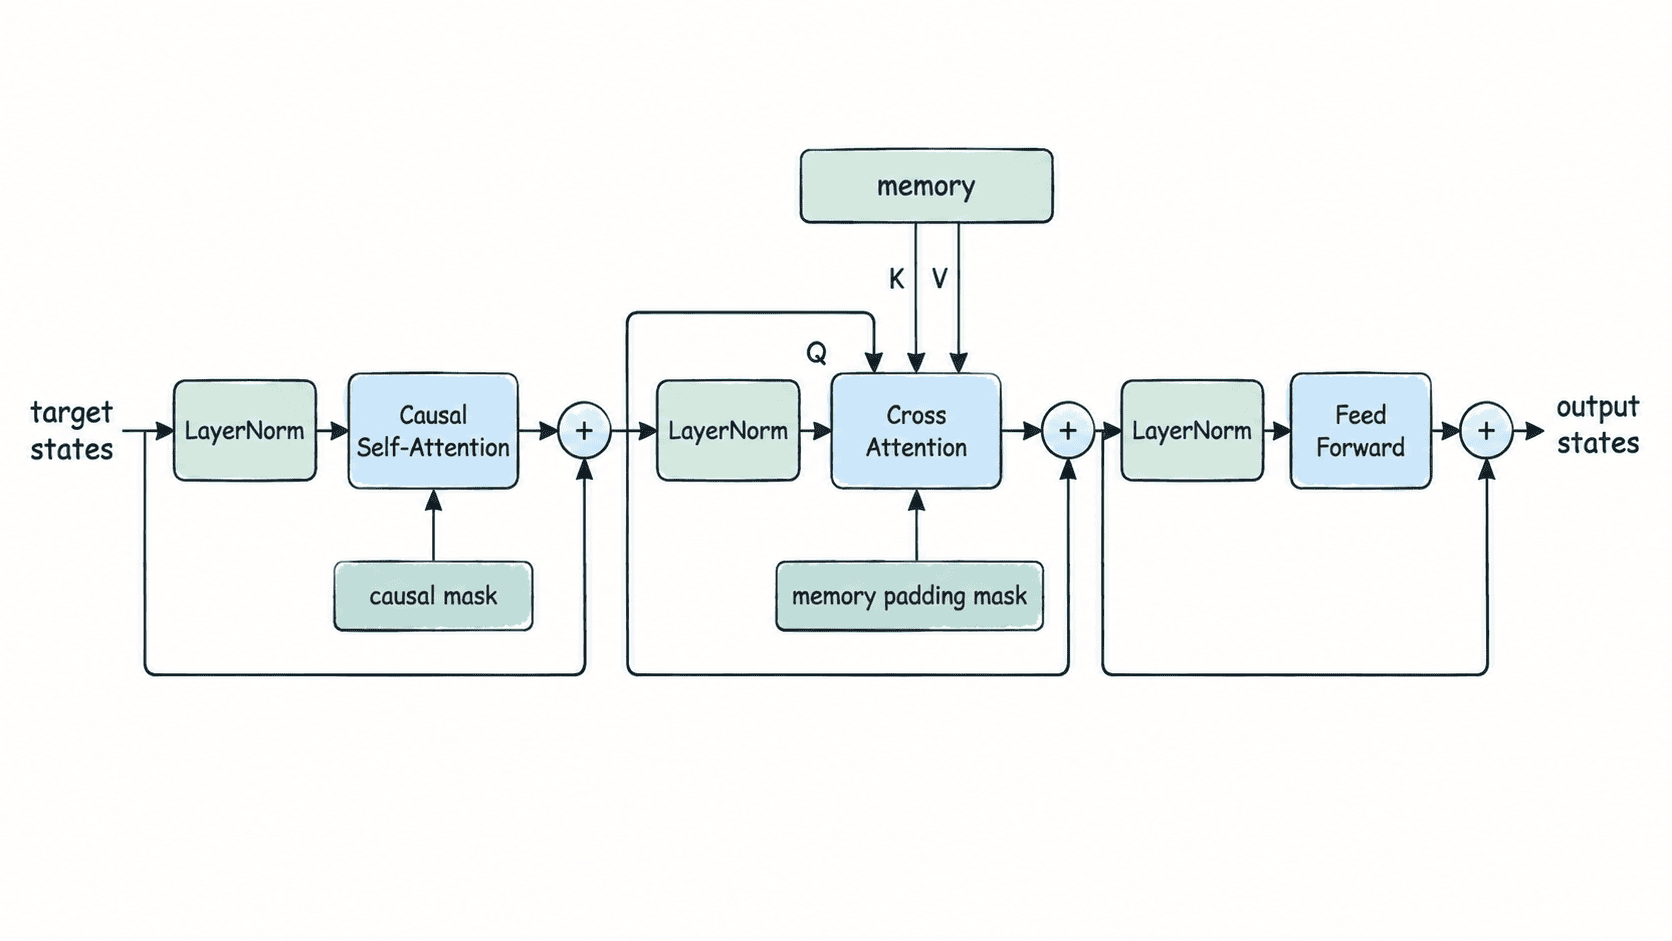
三个残差分支都要求输入与输出最后一维保持为 d_model。多头注意力内部可以拆分为多个头,但经过输出投影后必须恢复到原维度,才能执行逐元素相加。
完整实现
下面示例使用 PyTorch 的 nn.MultiheadAttention,并返回交叉注意力权重,便于后续观察每个目标位置关注了哪些源位置。
python
import torch
from torch import nn

class DecoderLayer(nn.Module):
    def __init__(
        self,
        d_model: int,
        num_heads: int,
        dim_feedforward: int,
        dropout: float = 0.1,
    ) -> None:
        super().__init__()
        self.self_attn = nn.MultiheadAttention(
            d_model, num_heads, dropout=dropout, batch_first=True
        )
        self.cross_attn = nn.MultiheadAttention(
            d_model, num_heads, dropout=dropout, batch_first=True
        )

        self.ffn = nn.Sequential(
            nn.Linear(d_model, dim_feedforward),
            nn.GELU(),
            nn.Dropout(dropout),
            nn.Linear(dim_feedforward, d_model),
        )

        self.norm1 = nn.LayerNorm(d_model)
        self.norm2 = nn.LayerNorm(d_model)
        self.norm3 = nn.LayerNorm(d_model)
        self.dropout = nn.Dropout(dropout)

    def forward(
        self,
        x: torch.Tensor,
        memory: torch.Tensor,
        tgt_mask: torch.Tensor,
        tgt_key_padding_mask: torch.Tensor | None = None,
        memory_key_padding_mask: torch.Tensor | None = None,
    ) -> tuple[torch.Tensor, torch.Tensor]:
        # 子层一:目标序列只能关注当前位置及其之前的位置
        y = self.norm1(x)
        self_attn_out, _ = self.self_attn(
            y,
            y,
            y,
            attn_mask=tgt_mask,
            key_padding_mask=tgt_key_padding_mask,
            need_weights=False,
        )
        x = x + self.dropout(self_attn_out)

        # 子层二:查询来自解码器,键和值来自编码器输出
        y = self.norm2(x)
        cross_attn_out, cross_weights = self.cross_attn(
            y,
            memory,
            memory,
            key_padding_mask=memory_key_padding_mask,
            need_weights=True,
            average_attn_weights=False,
        )
        x = x + self.dropout(cross_attn_out)

        # 子层三:前馈网络逐位置独立处理,不改变序列长度
        y = self.norm3(x)
        x = x + self.dropout(self.ffn(y))
        return x, cross_weights

def causal_mask(length: int) -> torch.Tensor:
    # True 表示该注意力位置被屏蔽
    return torch.triu(
        torch.ones(length, length, dtype=torch.bool),
        diagonal=1,
    )

def main() -> None:
    torch.manual_seed(7)

    batch_size = 2
    target_length = 4
    source_length = 6
    d_model = 8

    layer = DecoderLayer(
        d_model=d_model,
        num_heads=2,
        dim_feedforward=32,
        dropout=0.0,
    )

    target = torch.randn(batch_size, target_length, d_model)
    memory = torch.randn(batch_size, source_length, d_model)
    output, cross_weights = layer(
        target,
        memory,
        tgt_mask=causal_mask(target_length),
    )

    print('decoder output:', tuple(output.shape))
    print('cross attention:', tuple(cross_weights.shape))
    print('all finite:', bool(torch.isfinite(output).all()))

if __name__ == '__main__':
    main()
预期输出:
text
decoder output: (2, 4, 8)
cross attention: (2, 2, 4, 6)
all finite: True
随机初始化会改变具体数值,但张量形状应保持一致。交叉注意力权重的四个维度依次是批次、注意力头、目标位置和源位置。
验证方法与关键边界
运行代码后,先检查输出形状仍为 [B,T,d_model],再确认所有值都是有限数。若形状不一致,残差相加会立即报错;若出现 NaN,应优先检查掩码是否把某一整行全部屏蔽。
| 参数 | 典型形状 | 作用 |
|---|---|---|
tgt_mask |
[T,T] |
屏蔽未来目标位置 |
tgt_key_padding_mask |
[B,T] |
屏蔽目标序列补齐位置 |
memory_key_padding_mask |
[B,S] |
屏蔽编码器输出中的补齐位置 |
布尔掩码在此 API 中以 True 表示禁止关注。不要把 [B,S] 的编码器填充掩码误传给目标自注意力,也不要用因果掩码限制编码器记忆,否则解码器将无法读取完整输入。
本实现采用 Pre-LN,因此每个子层看到的是归一化后的输入,而残差主干保留未归一化值。若改成 Post-LN,归一化位置和训练特性都会变化,不能只移动一行代码而忽略整个残差顺序。
本课总结
- 解码器层按因果自注意力、交叉注意力、前馈网络的顺序更新目标状态
- 三个子层都通过残差连接保持
d_model不变,并分别进行层归一化 - 掩码必须按目标长度和源长度分别构造,验证时重点检查形状与有限值
下一课预告
下一课将把多个解码器层堆叠起来,并连接词表输出层,形成能够逐步生成词元的完整解码器。
按自己的节奏,确认真正理解。