
大模型原理与训练 / 系统课时
全量微调的成本
全量微调的成本
全量微调会更新模型中的每一个参数,因此成本不只是一份模型权重,还包括梯度、优化器状态、激活值和检查点。本课将用可计算的方法估算这些开销,并给出是否采用全量微调的判断标准。
学习目标
- 拆分全量微调的显存与存储构成
- 根据参数规模快速估算最低资源需求
- 判断全量微调与参数高效微调的适用边界
成本由哪些部分组成
训练时显存通常包含四类数据:模型参数、参数梯度、优化器状态和前向激活。前面三类主要随参数量增长,激活值则更受批量大小、序列长度、隐藏维度和是否启用梯度检查点影响。
以常见的 AdamW 混合精度训练为例,每个参数可能需要约 16 字节:半精度权重 2 字节、半精度梯度 2 字节、FP32 主权重 4 字节,以及一阶和二阶动量共 8 字节。于是仅模型状态可近似为 字节,尚未计入激活值和临时缓冲区。
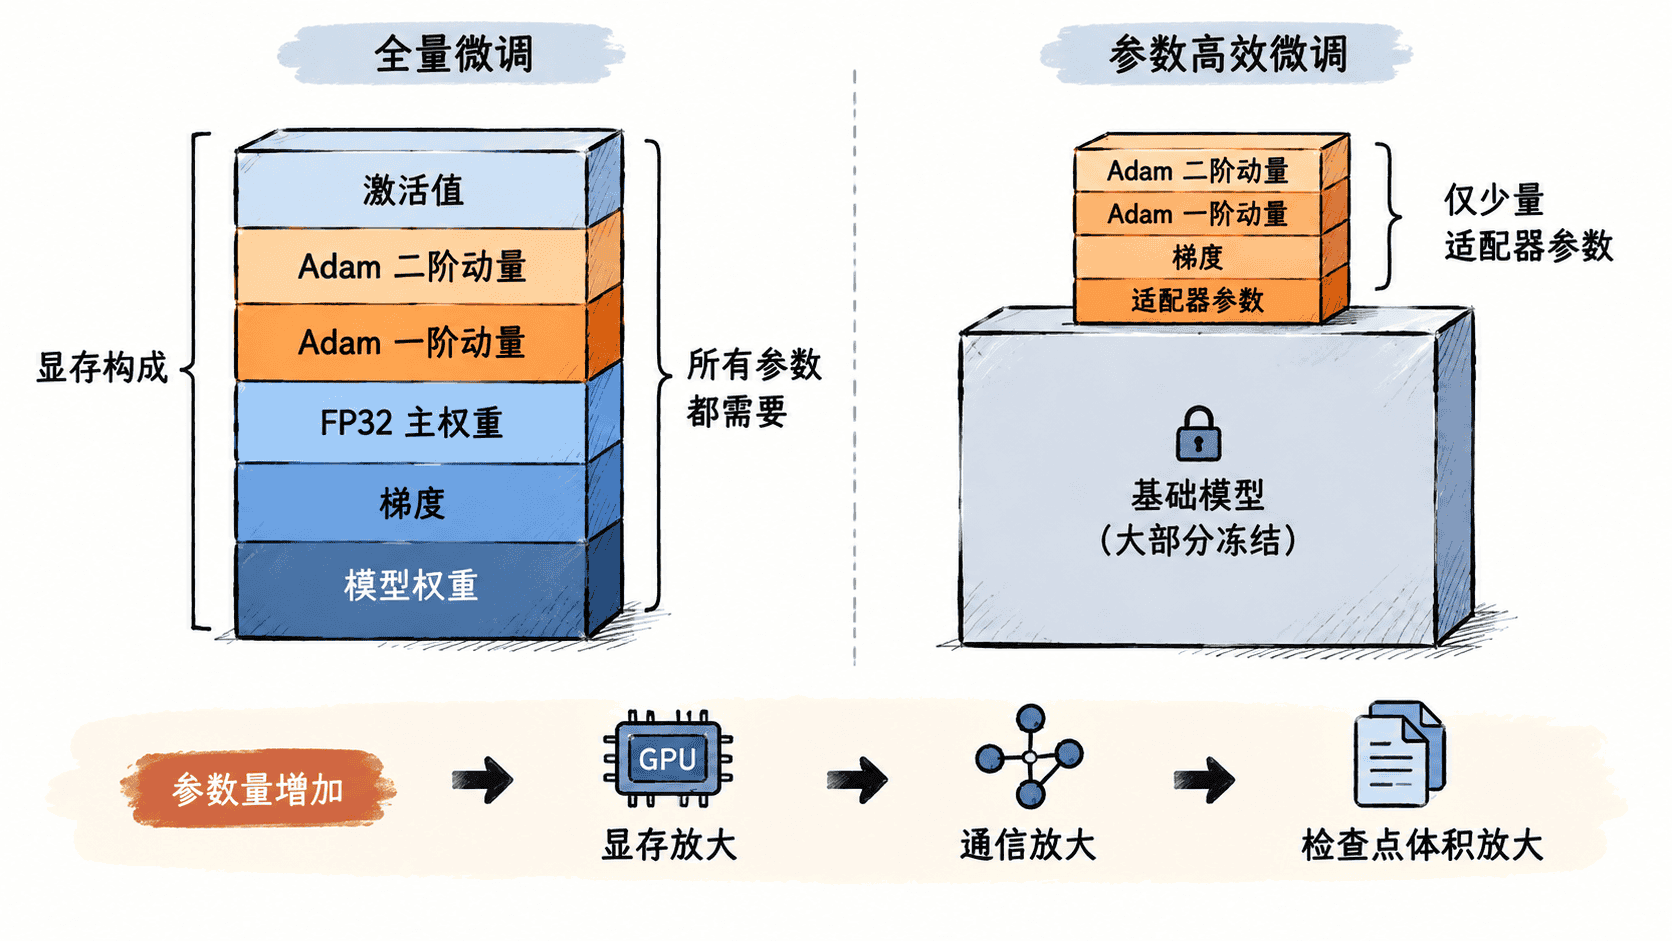
这张图强调了一个关键事实:冻结参数不等于模型权重消失。参数高效微调仍需加载基础模型,但不再为绝大多数参数保存梯度和优化器状态,因此训练侧节省最明显。
用脚本快速估算
下面的脚本按十进制 GB 估算训练状态和一份 FP16 权重文件。它不包含激活值、框架缓存、通信缓冲区和显存碎片,因此只能作为资源规划的下限。
def estimate_cost(parameters_billion: float) -> tuple[float, float]:
    parameters = parameters_billion * 1_000_000_000
    training_state_gb = parameters * 16 / 1_000_000_000
    fp16_checkpoint_gb = parameters * 2 / 1_000_000_000
    return training_state_gb, fp16_checkpoint_gb

def main():
    for size in (0.11, 1.30, 7.00):
        state_gb, checkpoint_gb = estimate_cost(size)
        print(
            f"{size:.2f}B: "
            f"training_states={state_gb:.2f} GB, "
            f"fp16_weights={checkpoint_gb:.2f} GB"
        )

if __name__ == "__main__":
    main()
预期输出
0.11B: training_states=1.76 GB, fp16_weights=0.22 GB
1.30B: training_states=20.80 GB, fp16_weights=2.60 GB
7.00B: training_states=112.00 GB, fp16_weights=14.00 GB
7B 模型仅训练状态就约 112 GB,实际还要叠加激活值和运行时开销,通常无法直接放入单张消费级显卡。采用 ZeRO、FSDP 或张量并行可以把状态拆到多张卡上,但总资源消耗并没有消失,只是被分摊并增加了通信成本。
计算、通信与存储开销
全量微调的反向传播需要为全部参数计算梯度,单步计算量显著高于只训练少量适配器参数的方案。多卡训练还要同步或分片这些梯度,网络带宽不足时,GPU 会等待通信,扩容后不一定获得线性加速。
存储成本也常被低估。一份 FP16 的 7B 权重约 14 GB;若每轮都保存完整模型,并保留多个版本,磁盘和对象存储会迅速增长。为了断点续训,检查点还可能包含优化器状态、调度器状态和随机数状态,体积远大于仅用于推理的权重文件。
何时值得全量微调
当数据量充足、任务与基础模型差异明显,并且必须获得最高任务上限时,全量微调更有价值。它允许所有层共同适配新分布,也便于做持续预训练或领域迁移。
若数据量有限、需要同时维护多个任务版本,或资源主要集中在单机少量 GPU,应优先考虑 LoRA、Adapter 或只训练分类头。它们通常能以更低成本获得接近全量微调的效果,并显著降低每个任务的保存体积。
实际决策应同时检查四项:可用显存是否覆盖模型状态与激活值、训练时长是否可接受、多卡通信是否稳定、模型版本数量是否会放大存储成本。任何一项成为硬约束,都说明全量微调可能不是最经济的选择。
本课总结
- 全量微调的主要成本来自参数、梯度、优化器状态、激活值与通信
- AdamW 混合精度训练可先按每参数约 16 字节估算模型状态下限
- 资源、数据和效果上限同时满足时,全量微调才更值得采用
下一课预告
下一课将进入参数高效微调,说明 LoRA 如何用低秩矩阵减少可训练参数,并比较它与全量微调的训练行为。