
大模型原理与训练 / 系统课时
实现贪心解码
实现贪心解码
本课将把训练完成的 Transformer 接入逐步生成循环:从起始词元开始,每一步选择当前概率最高的词元,并在生成结束词元或达到长度上限时停止。完成后,你会得到一个可直接替换真实模型接口的基础解码器。
学习目标
- 理解训练阶段并行输入与推理阶段逐词生成的差异
- 实现支持批量输入、因果掩码和提前停止的贪心解码
- 正确处理起始词元、结束词元和最大生成长度
贪心解码的执行过程
训练时,解码器通常一次接收右移后的完整目标序列;推理时没有真实目标,只能把已经生成的词元重新送入解码器。第 步得到词表分数后,贪心策略选择 对应的词元,并把它追加到序列末尾。
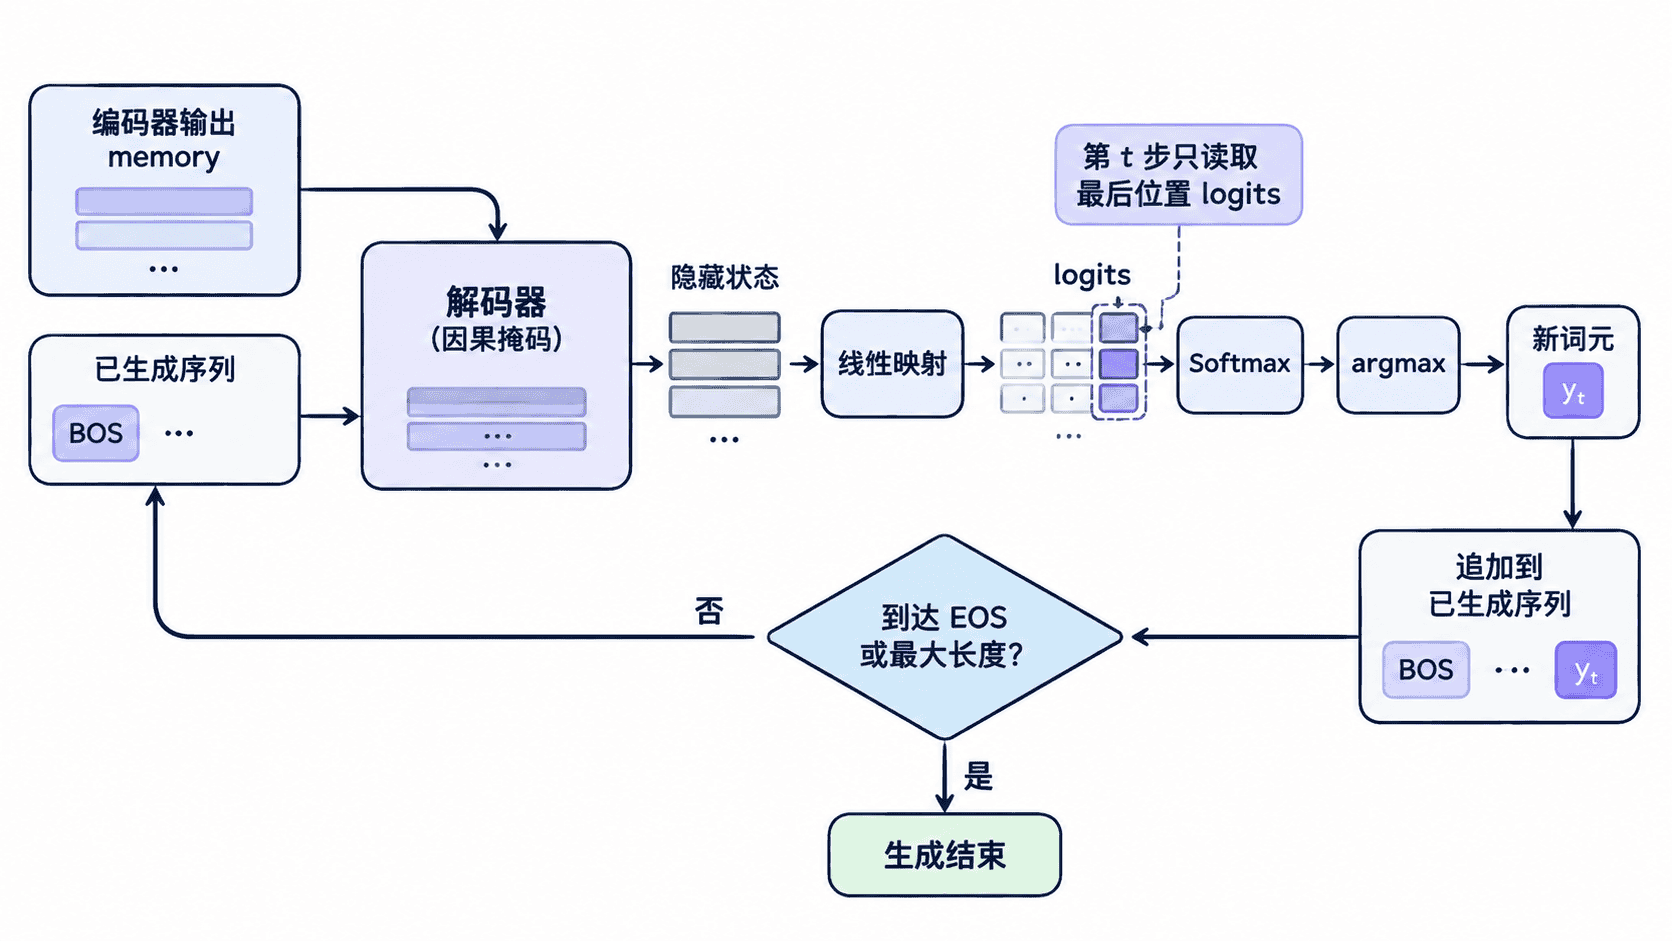
贪心解码每一步只保留一个候选,因此实现简单、速度快,但无法回退。它适合验证模型能否生成合理序列,也常作为后续束搜索和采样解码的基线。
模型接口约定
下面的实现假设模型暴露三个接口:encode 计算源序列表示,decode 根据当前目标前缀计算解码器隐藏状态,generator 把最后一个位置的隐藏状态映射为词表 logits。若你的实现把这些步骤封装在 forward 中,只需调整调用位置,循环逻辑保持不变。
源序列形状约定为 [batch_size, src_len],返回结果形状为 [batch_size, generated_len]。布尔因果掩码中,True 表示该位置不可见,这与 PyTorch nn.Transformer 的约定一致。
完整实现
下面的脚本包含可复用的 greedy_decode,并用一个确定性演示模型验证循环。演示模型会依次生成词元 3、4、EOS;接入真实 Transformer 时,保留解码函数并替换 DemoModel 即可。
import torch
from torch import nn

class DemoModel(nn.Module):
    def encode(
        self,
        src: torch.Tensor,
        src_key_padding_mask: torch.Tensor | None = None,
    ) -> torch.Tensor:
        return src

    def decode(
        self,
        tgt: torch.Tensor,
        memory: torch.Tensor,
        tgt_mask: torch.Tensor | None = None,
    ) -> torch.Tensor:
        batch_size, tgt_len = tgt.shape
        # 用当前前缀长度构造隐藏状态,便于稳定验证生成循环。
        return torch.full(
            (batch_size, tgt_len, 1),
            float(tgt_len),
            device=tgt.device,
        )

    def generator(self, last_hidden: torch.Tensor) -> torch.Tensor:
        step = last_hidden[:, 0].long()
        logits = torch.full(
            (last_hidden.size(0), 6),
            -10.0,
            device=last_hidden.device,
        )
        # 第 1、2 步生成普通词元,之后生成 EOS。
        next_ids = torch.where(
            step.eq(1),
            torch.tensor(3, device=step.device),
            torch.where(
                step.eq(2),
                torch.tensor(4, device=step.device),
                torch.tensor(2, device=step.device),
            ),
        )
        logits.scatter_(1, next_ids.unsqueeze(1), 10.0)
        return logits

@torch.no_grad()
def greedy_decode(
    model: nn.Module,
    src: torch.Tensor,
    bos_id: int,
    eos_id: int,
    max_new_tokens: int,
    src_key_padding_mask: torch.Tensor | None = None,
) -> torch.Tensor:
    model.eval()
    memory = model.encode(
        src,
        src_key_padding_mask=src_key_padding_mask,
    )
    generated = torch.full(
        (src.size(0), 1),
        bos_id,
        dtype=torch.long,
        device=src.device,
    )
    finished = torch.zeros(
        src.size(0),
        dtype=torch.bool,
        device=src.device,
    )

    for _ in range(max_new_tokens):
        tgt_len = generated.size(1)
        # 上三角区域为 True,阻止当前位置读取未来词元。
        causal_mask = torch.triu(
            torch.ones(
                tgt_len,
                tgt_len,
                dtype=torch.bool,
                device=src.device,
            ),
            diagonal=1,
        )
        decoder_output = model.decode(
            generated,
            memory,
            tgt_mask=causal_mask,
        )
        next_logits = model.generator(
            decoder_output[:, -1, :]
        )
        next_token = next_logits.argmax(dim=-1)

        # 已结束样本持续写入 EOS,避免批量解码时长度错位。
        next_token = torch.where(
            finished,
            torch.full_like(next_token, eos_id),
            next_token,
        )
        generated = torch.cat(
            [generated, next_token.unsqueeze(1)],
            dim=1,
        )
        finished |= next_token.eq(eos_id)
        if finished.all():
            break

    return generated

if __name__ == "__main__":
    model = DemoModel()
    source = torch.tensor([[9, 8, 7]], dtype=torch.long)
    result = greedy_decode(
        model,
        source,
        bos_id=1,
        eos_id=2,
        max_new_tokens=5,
    )
    print(result.tolist())
预期输出
[[1, 3, 4, 2]]结果中的 1 是 BOS,2 是 EOS。虽然 max_new_tokens 为 5,但循环在全部样本生成 EOS 后提前结束,因此最终只追加了三个词元。
接入真实模型时的边界
max_new_tokens 表示最多追加多少个词元,不包含初始 BOS。若业务限制的是结果总长度,应把循环次数改为 max_length - 1,并确保该值不小于 1。
批量解码时,不同样本可能在不同步骤结束。代码通过 finished 记录状态;已经结束的样本继续补 EOS,尚未结束的样本继续生成。若后续需要还原文本,可在解码后截断每行第一个 EOS 之后的内容。
源序列包含 PAD 时,应把形状为 [batch_size, src_len] 的 src_key_padding_mask 传给编码器。真实模型若还要求目标填充掩码,也应根据 generated 动态构造,但单条无填充生成通常只需要因果掩码。
提示: 贪心解码比较的是 logits,直接使用
argmax即可,不必先计算 Softmax。Softmax 不会改变最大值所在位置,省略它可以减少一次计算。
本课总结
- 贪心解码从 BOS 开始,每一步只选择最后位置 logits 中分数最高的词元
- 因果掩码保证当前位置看不到未来,EOS 和长度上限共同决定停止条件
- 批量生成必须单独记录每个样本是否结束,不能因某一条生成 EOS 就停止全部样本
下一课预告
下一课将通过形状断言、小样本过拟合和注意力权重检查,系统验证从零实现的 Transformer 是否真的正确。