
大模型原理与训练 / 系统课时
梯度裁剪与累积
梯度裁剪与累积
显存不足和梯度突然变大是 Transformer 训练中的两类常见问题。本课将把梯度裁剪与梯度累积放进同一条训练循环,说明它们的执行顺序、参数含义和验证方法,并通过可运行示例观察真实更新结果。
学习目标
- 理解梯度裁剪控制的对象以及正确执行时机
- 使用梯度累积计算有效批次大小并减少显存占用
- 编写包含反向传播、裁剪、更新和清零的完整训练步骤
两种技术分别解决什么问题
梯度裁剪用于限制一次参数更新前的梯度规模。当梯度范数突然增大时,它按比例缩小所有梯度,避免一次异常更新破坏已经学到的参数。它不会修复错误数据或不合理的学习率,只是为训练增加一道稳定性保护。
梯度累积用于把多个微批次的梯度先累加,再执行一次优化器更新。有效批次大小可写成“单卡微批次大小 × 累积步数 × 数据并行卡数”。它减少单次前向与反向传播占用的显存,但不会减少完成同样样本量所需的总计算。
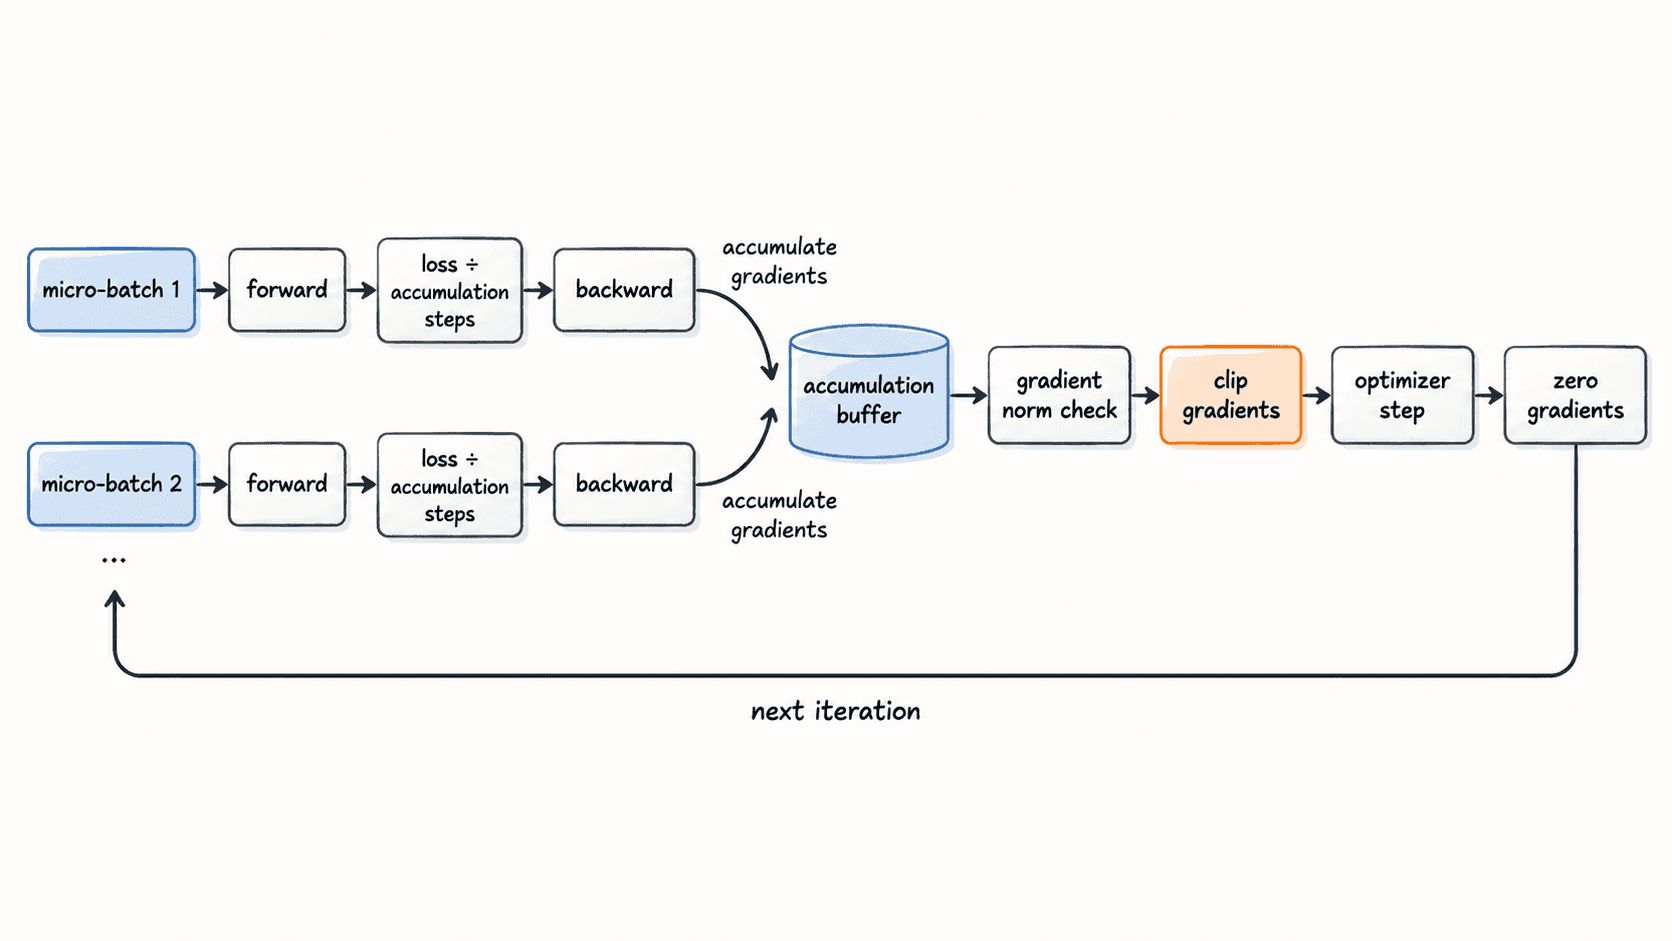
梯度裁剪如何生效
最常见的是按全局范数裁剪。先计算全部参数梯度组成的整体范数;若它超过阈值 max_norm,就按相同比例缩小各参数梯度。这样能保留梯度方向,同时限制总更新幅度。
执行位置必须是 backward() 之后、optimizer.step() 之前。若使用自动混合精度,应先把缩放后的梯度还原,再裁剪;否则裁剪的是放大后的数值,阈值将失去实际意义。裁剪函数返回的通常是裁剪前范数,可用于日志监控。
梯度累积如何模拟大批次
假设显存一次只能容纳 8 个样本,希望模拟批次 32,可把 accumulation_steps 设为 4。每个微批次都执行反向传播,但前 3 次不更新参数,也不清空梯度;第 4 次完成后再统一裁剪和更新。
每个微批次的损失通常要除以累积步数,使累积后的梯度与一次处理完整大批次时的平均梯度尺度一致。若不做除法,梯度会被放大,等价于改变了学习率。
可运行示例
下面使用一个只有单个权重的 PyTorch 线性模型。四个样本按两个微批次累积一次更新,并在每次更新前把全局梯度范数裁剪到 5。
import torch
from torch import nn

model = nn.Linear(1, 1, bias=False)
with torch.no_grad():
    model.weight.fill_(1.0)

optimizer = torch.optim.SGD(model.parameters(), lr=0.1)
inputs = torch.tensor([[10.0], [20.0], [30.0], [40.0]])
targets = torch.zeros_like(inputs)

accumulation_steps = 2
max_norm = 5.0
optimizer.zero_grad()

for index, (x, y) in enumerate(zip(inputs, targets), start=1):
    prediction = model(x)
    # 除以累积步数,保持平均梯度尺度不变
    loss = nn.functional.mse_loss(prediction, y) / accumulation_steps
    loss.backward()

    if index % accumulation_steps == 0:
        # 先裁剪,再更新;返回值是裁剪前的全局范数
        norm_before_clip = torch.nn.utils.clip_grad_norm_(
            model.parameters(),
            max_norm,
        )
        optimizer.step()
        optimizer.zero_grad()

        print(
            f"update={index // accumulation_steps}, "
            f"norm_before_clip={norm_before_clip.item():.2f}, "
            f"weight={model.weight.item():.4f}"
        )
预期输出
update=1, norm_before_clip=500.00, weight=0.5000
update=2, norm_before_clip=1250.00, weight=-0.0000
输出中的范数远大于 5,但权重每次只按裁剪后的梯度更新。第二次结果显示为 -0.0000,只是浮点数格式化产生的负零表示,数值实际非常接近 0。
正确的训练循环顺序
一个累积周期应按固定顺序执行:先清零梯度,再对每个微批次完成前向传播、缩放损失和反向传播;达到累积步数后执行梯度还原、梯度裁剪、优化器更新、学习率调度和再次清零。
学习率调度器应只在 optimizer.step() 后推进一次。若每个微批次都推进,学习率会比预期更快衰减。训练集样本数不能被累积步数整除时,最后不足一组的微批次也要执行一次更新,否则对应样本的梯度会被丢弃。
验证与边界
训练日志至少记录裁剪前梯度范数、当前学习率、累积计数和是否执行了参数更新。若范数长期远高于阈值,说明裁剪一直在强行压制更新,应继续检查学习率、数据异常和损失缩放,而不是只调大阈值。
梯度累积只能近似大批次训练。含有批次统计的层、随机失活以及分布式通信时,微批次执行过程与真正的大批次并不完全相同。对 Transformer 常见的 LayerNorm 而言影响通常较小,但仍应以验证集结果判断是否需要调整学习率。
本课总结
- 梯度裁剪在反向传播后、参数更新前限制异常梯度,保护训练稳定性
- 梯度累积通过延迟更新模拟更大有效批次,损失通常需除以累积步数
- 裁剪、调度器推进和梯度清零都应以真实优化器更新为边界
下一课预告
下一课将继续完善训练流程,结合验证集指标、检查点保存和早停策略,判断模型何时真正收敛并保留最佳参数。