
大模型原理与训练 / 系统课时
LoRA 基本原理
LoRA 基本原理
LoRA 解决的是“模型很大,但任务适配只需要少量变化”的问题。它冻结原有权重,只训练一条低秩更新分支,从而显著减少显存占用、可训练参数和模型副本体积。
学习目标
- 理解 LoRA 为什么把权重更新拆成两个低秩矩阵
- 会估算 LoRA 相比全量微调节省的参数量
- 区分秩、缩放系数、目标层与合并操作的职责
为什么全量微调代价高
设某个线性层的预训练权重为 。全量微调会直接更新 中的全部元素,因此优化器还要为这些参数保存梯度和状态。模型越大,训练显存、保存空间和多任务模型副本的成本越高。
LoRA 的基本假设是:面对一个具体下游任务,模型所需的权重变化通常集中在较低维的方向上。既然有效更新不一定需要覆盖整个高维空间,就可以用更小的矩阵表示这部分变化。
低秩更新的核心结构
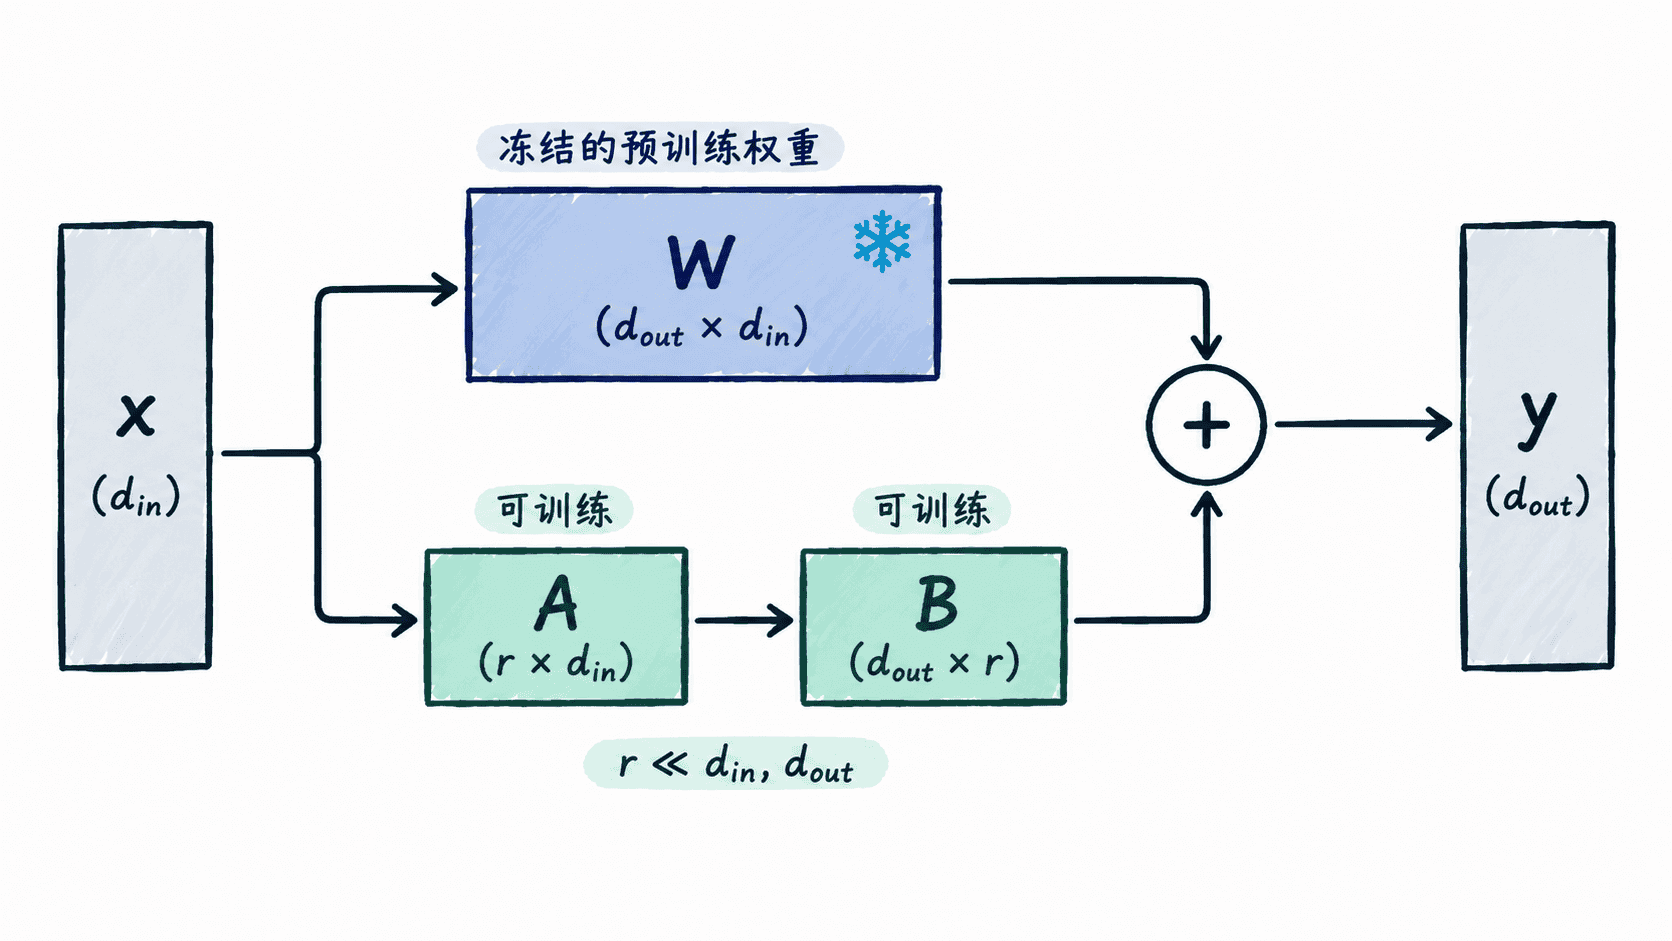
LoRA 不改写原权重,而是把新的有效权重写成:
其中 在训练期间保持冻结, 和 是可训练矩阵。若原权重尺寸为 ,则:
秩 远小于输入和输出维度。前向计算时,输入既经过冻结的主路径,也经过“先降维、再升维”的低秩分支,两个结果相加后送往后续网络。
实际实现通常还会使用缩放系数:
控制低秩分支的整体强度。常见初始化方式是让 使用随机初始化、 初始化为零,使训练刚开始时 ,模型输出与原模型保持一致,再逐步学习任务增量。
参数量为什么会下降
全量更新一个矩阵需要训练 个参数,而 LoRA 只需训练:
例如,一个 的权重矩阵包含 16,777,216 个参数。取 时,LoRA 只新增 65,536 个参数,约为原矩阵参数量的 0.39%。实际模型会在多个目标层上挂载 LoRA,因此总量还要乘以目标层数量,但通常仍远小于全量微调。
参数减少还会连带降低梯度和优化器状态的显存开销。需要注意,冻结参数仍要参与前向和反向传播中的计算,所以 LoRA 主要节省训练状态与存储成本,并不会按相同比例减少所有计算量。
训练与推理如何衔接
训练时,基础模型参数被冻结,优化器只更新 、,以及显式指定的额外模块。保存时通常只保存适配器权重和配置,一个基础模型可以配套多个任务适配器。
推理时有两种方式:一是同时加载基础模型和适配器,便于切换任务;二是把 合并进 ,得到可独立部署的普通模型。合并不会提升适配器质量,它只是改变部署形态,而且会生成接近完整模型大小的新权重文件。
容易混淆的四个参数
| 参数或操作 | 实际职责 | 常见误区 |
|---|---|---|
r |
决定低秩空间容量与参数量 | 越大不一定越好,过大可能增加过拟合和显存开销 |
lora_alpha |
缩放低秩更新的幅度 | 它不是第二个秩,也不会直接增加矩阵尺寸 |
target_modules |
决定在哪些层挂载 LoRA | 模块名依赖模型架构,不能跨模型机械复制 |
| 合并 | 把适配器增量写回基础权重 | 合并是部署选择,不是继续训练的必要步骤 |
本课总结
- LoRA 用 表示任务相关更新,并冻结原始权重
- 可训练参数量由 降为
- 秩、缩放系数、目标层和是否合并分别控制容量、幅度、作用范围与部署方式
下一课预告
下一课将使用 PEFT 完成一次可运行的 LoRA 微调,并依次验证目标层选择、适配器保存、重新加载和权重合并。