
大模型原理与训练 / 系统课时
层归一化位置
层归一化位置
本课解决一个常见但容易混淆的问题:层归一化究竟应放在残差相加之前还是之后。你将通过结构、公式和梯度路径理解 Pre-LN 与 Post-LN 的差异,并能根据网络深度和训练条件做出选择。
学习目标
- 识别 Pre-LN 与 Post-LN 的计算顺序
- 理解归一化位置对梯度传播和训练稳定性的影响
- 根据训练规模与收敛需求选择合适结构
两种归一化位置
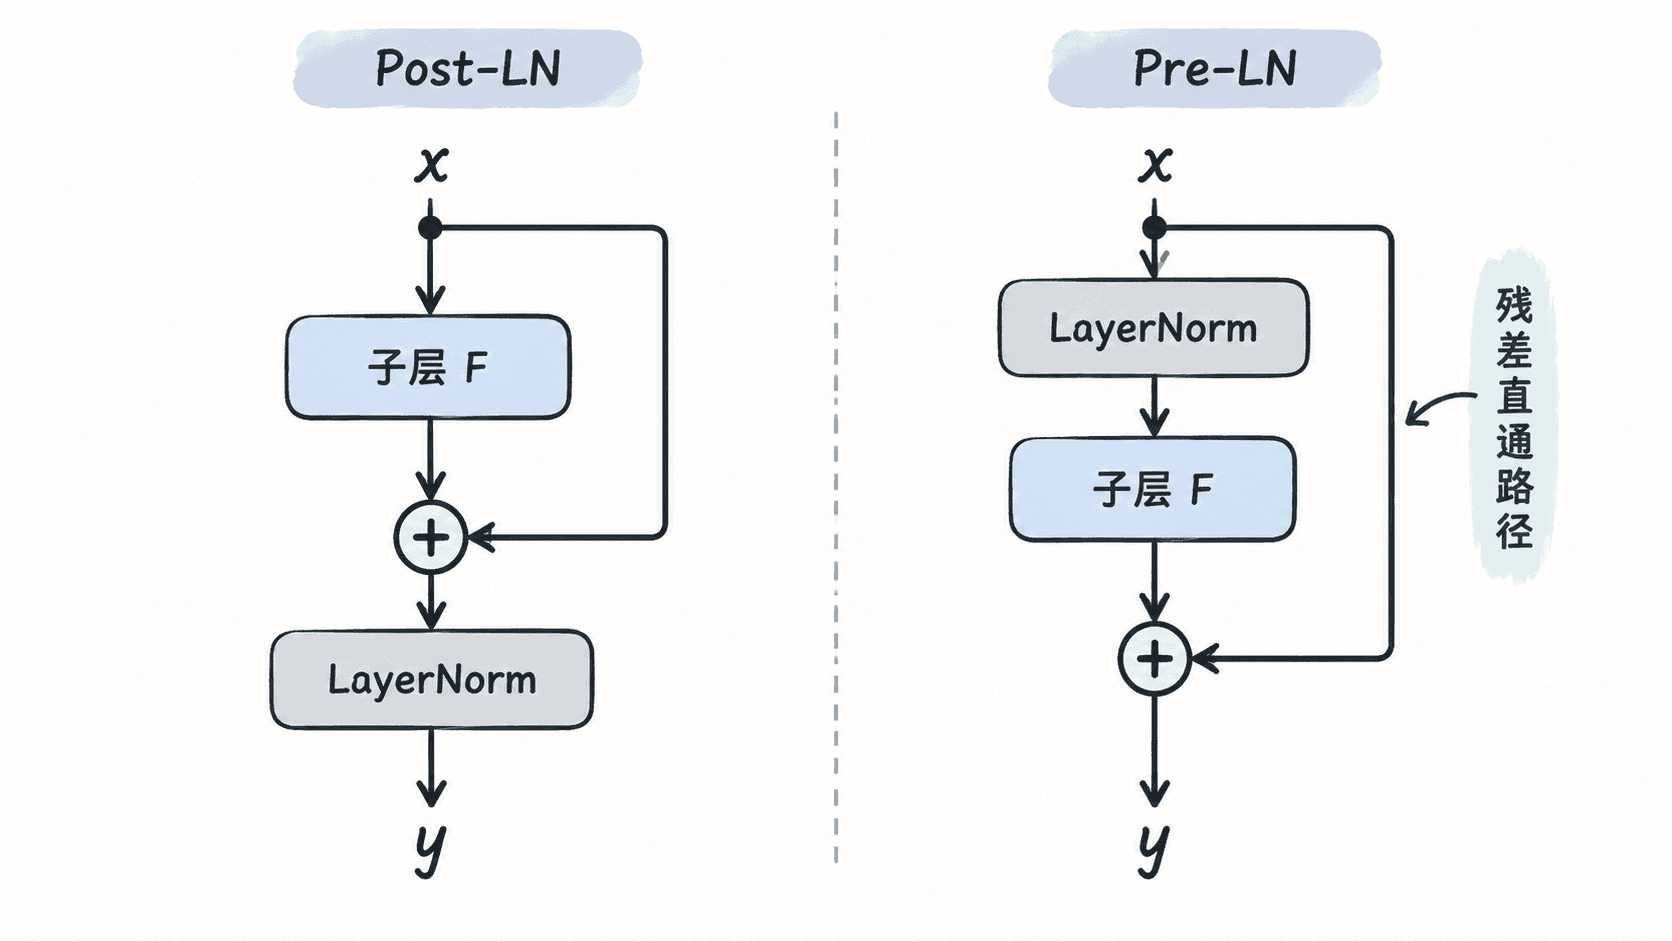
设输入为 ,子层为 。Post-LN 先执行子层与残差相加,再做层归一化:
Pre-LN 则先归一化输入,再送入子层,最后与原输入相加:
两者使用的模块相同,区别只在归一化与残差连接的先后顺序,但这一变化会直接改变深层网络中的信息与梯度路径。
训练稳定性为什么不同
在 Post-LN 中,每个子层输出都必须经过层归一化后才能进入下一层。网络较深时,梯度需要连续穿过多个归一化与子层变换,初始化或学习率不合适时更容易出现训练不稳定,因此经典 Transformer 通常依赖学习率预热。
Pre-LN 把归一化放到子层入口,残差支路可近似形成从高层直接回到低层的恒等路径。梯度有更顺畅的传播通道,深层模型通常更容易启动训练,也往往能减少对长时间预热的依赖。
稳定并不等于最终效果一定更好。Post-LN 在某些设置下可能获得更充分的层间变换,而 Pre-LN 的深层表示有时会出现相邻层变化较小的问题。实际结果仍受初始化、优化器、学习率、层数和数据规模共同影响。
选择时看什么
| 关注点 | Pre-LN | Post-LN |
|---|---|---|
| 深层训练稳定性 | 通常更好 | 更依赖初始化与预热 |
| 梯度直通路径 | 更清晰 | 需要穿过归一化 |
| 复现经典结构 | 需确认实现 | 原始 Transformer 常用 |
| 工程默认选择 | 深层模型中常见 | 有成熟训练配方时可用 |
阅读代码时不要只看是否存在 LayerNorm,而要追踪它相对子层和残差加法的位置。不同框架还可能用 norm_first、pre_norm 或相反含义的开关表示这一选择。
层归一化不会替代残差连接,两者职责不同:残差连接保留并传递原始表示,层归一化控制每个位置特征维度上的数值分布。调整归一化位置时,也不能漏掉注意力子层和前馈子层各自对应的归一化操作。
本课总结
- Post-LN 先残差相加再归一化,Pre-LN 先归一化再进入子层
- Pre-LN 提供更直接的残差与梯度通路,深层训练通常更稳定
- 结构选择应与层数、学习率预热和既有训练配方一起评估
下一课预告
下一课将把多头注意力、前馈网络、残差连接与层归一化组合成一个可运行的编码器层,并验证输入输出形状与掩码行为。