
大模型原理与训练 / 系统课时
项目模块划分
项目模块划分
从零实现 Transformer 时,最先要解决的不是某一层公式,而是让配置、数据、模型、训练和推理各自承担单一职责。合理的模块边界能避免循环依赖,也让后续替换分词器、训练策略或解码方式时不必改动整个项目。
学习目标
- 划分五个核心模块的职责与输入输出
- 建立单向、可验证的模块依赖关系
- 搭建能够继续扩展的最小项目骨架
模块职责与目录
五个模块应围绕稳定的数据契约协作,而不是彼此读取内部变量。配置模块提供不可变参数;数据模块产出批次张量;模型模块只负责前向计算;训练模块组织损失、反向传播和保存;推理模块加载权重并执行解码。
| 模块 | 主要职责 | 不应承担的职责 |
|---|---|---|
config |
保存模型与训练参数 | 读取数据、执行训练 |
data |
分词、样本构造、批处理 | 创建优化器 |
model |
网络结构与前向传播 | 控制训练轮次 |
train |
训练循环、评估、检查点 | 实现分词规则 |
infer |
加载权重、生成与后处理 | 修改训练状态 |
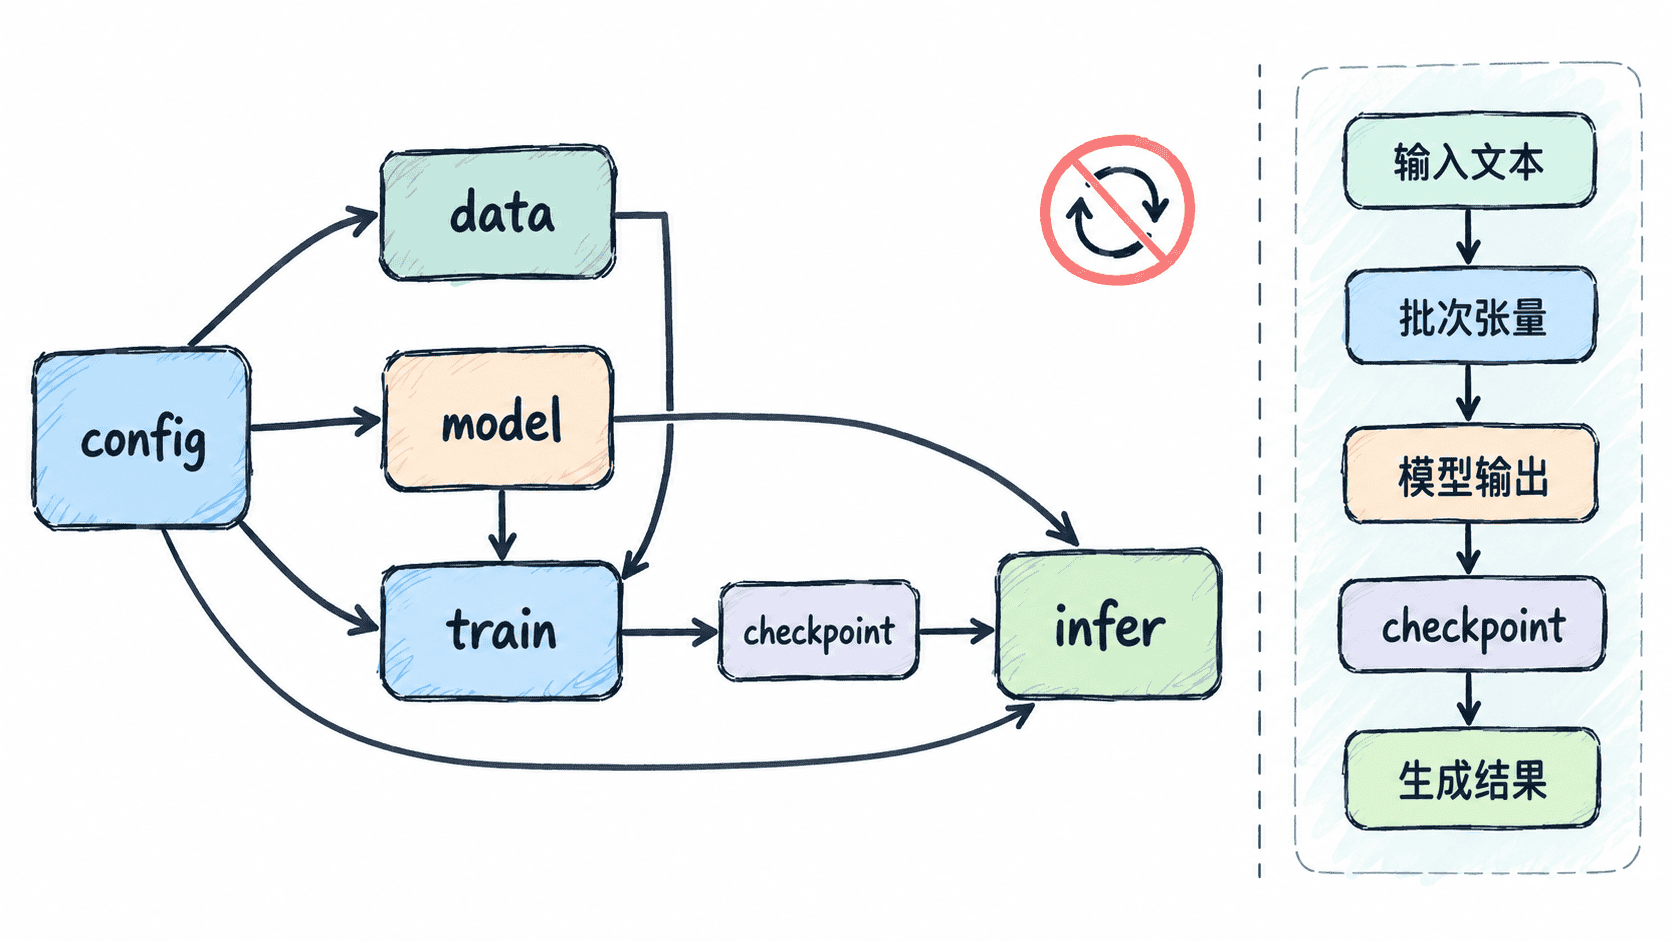
推荐先建立以下目录。src 是 Python 包,测试目录与实现目录分离,检查点和运行日志不提交到源码包中。
text
transformer_project/
├── src/
│   ├── __init__.py
│   ├── config.py
│   ├── data.py
│   ├── model.py
│   ├── train.py
│   └── infer.py
├── tests/
└── checkpoints/
最小接口示例
片段示例:以下代码应分别保存到注释标出的文件中。它只固定模块接口与依赖方向,不包含完整 Transformer 结构。
python
# src/config.py
from dataclasses import dataclass

@dataclass(frozen=True)
class ModelConfig:
    d_model: int = 512
    num_layers: int = 6

# src/data.py
class TokenDataset:
    def __init__(self, token_ids: list[list[int]]) -> None:
        self.token_ids = token_ids

# src/model.py
from .config import ModelConfig

class TransformerModel:
    def __init__(self, config: ModelConfig) -> None:
        self.config = config

# src/train.py
from .config import ModelConfig
from .data import TokenDataset
from .model import TransformerModel

def build_training() -> dict[str, object]:
    config = ModelConfig()
    dataset = TokenDataset([[1, 2, 3]])
    model = TransformerModel(config)
    return {
        'model': type(model).__name__,
        'dataset': type(dataset).__name__,
        'layers': config.num_layers,
    }

# src/infer.py
from .config import ModelConfig
from .model import TransformerModel

def load_model() -> TransformerModel:
    return TransformerModel(ModelConfig())
依赖规则与验证
依赖应保持从基础模块流向编排模块:config 位于最底层,data 与 model 不互相调用,train 可以组合前三者,infer 只依赖配置和模型。检查点属于训练产物,应通过文件路径或明确接口交给推理模块,而不是让模型模块反向调用训练代码。
将片段拆分到对应文件并补充空的 src/__init__.py 后,在项目根目录执行以下命令。第一段检查语法,第二段验证训练编排模块能够正常导入并组合对象。
bash
python -m compileall -q src && python -c 'from src.train import build_training; print(build_training())'预期输出如下;若出现循环导入或模块路径错误,命令会在打印结果前失败。
text
{'model': 'TransformerModel', 'dataset': 'TokenDataset', 'layers': 6}本课总结
- 模块划分的核心是单一职责、稳定接口和单向依赖
config、data、model提供基础能力,train与infer负责编排- 先验证导入关系和最小数据流,再逐步填充完整 Transformer 实现
下一课预告
下一课将从配置对象开始,定义模型维度、层数、注意力头数和训练超参数,并为后续模块提供统一参数来源。
按自己的节奏,确认真正理解。