
大模型原理与训练 / 系统课时
序列标注微调
序列标注微调
本课将以命名实体识别为例,把逐词 BIO 标签对齐到分词后的子词序列,完成编码器序列标注模型的训练、评估与逐词推理。
学习目标
- 理解序列标注与整句分类在输出粒度上的区别
- 掌握特殊词元、子词切分与标签对齐规则
- 能使用 BIO 标签训练并验证命名实体识别模型
定义 BIO 标注数据
序列标注要求模型为输入序列中的每个有效位置输出一个类别。命名实体识别常用 BIO 体系:B-PER 表示人名开始,I-PER 表示人名内部,B-LOC 表示地点开始,O 表示不属于任何实体。每条样本应保存词语列表和等长标签列表。
例如“张三在北京工作”可以先按业务词语组织为 ["张三", "在", "北京", "工作"],对应标签为 ["B-PER", "O", "B-LOC", "O"]。这里的“词语”是数据标注单位,不一定等于模型分词器最终产生的词元。
对齐词语与子词标签
预训练分词器可能把一个标注词语拆成多个子词,还会插入 [CLS]、[SEP] 等特殊词元。模型损失却要求标签序列与分词结果等长,因此必须建立从词元位置到原始词语位置的映射。
本课采用“只监督每个词语的第一个子词”策略:第一个子词继承原标签,后续子词和特殊词元统一设为 -100。PyTorch 的交叉熵损失默认忽略 -100,这样既避免重复计算一个词语的标签,也能在评估时恢复逐词结果。
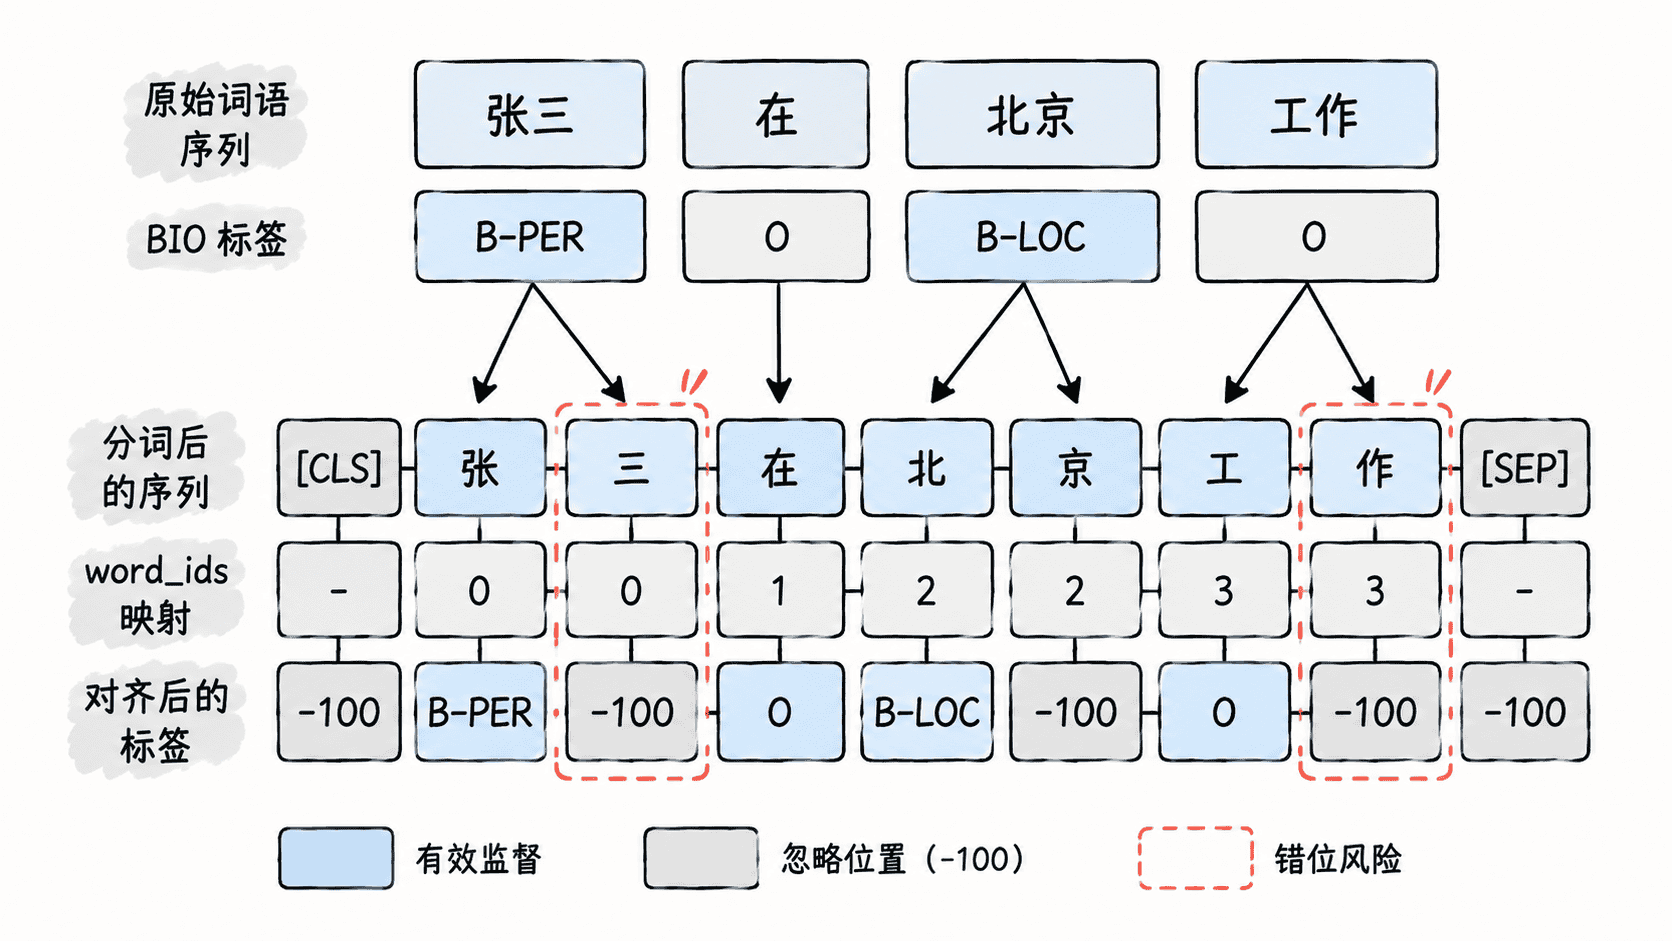
对齐错误通常不会立即报错。只要标签数量与词元数量相同,训练仍可继续,但实体边界会被悄悄破坏。因此不要根据字符串长度猜测位置,而应使用快速分词器返回的 word_ids()。
完成一次序列标注微调
先安装依赖:
python -m pip install torch transformers datasets accelerate seqeval预期结果:
Successfully installed <PACKAGES><PACKAGES> 的版本和安装日志会随本机环境变化。
将以下代码保存为 train_token_classifier.py。示例数据仅用于验证流程,正式训练应使用更大的人工标注语料,并保留独立测试集。
import numpy as np
import torch
from datasets import Dataset
from seqeval.metrics import accuracy_score, f1_score, precision_score, recall_score
from transformers import (
    AutoModelForTokenClassification,
    AutoTokenizer,
    DataCollatorForTokenClassification,
    Trainer,
    TrainingArguments,
    set_seed,
)

MODEL_NAME = "bert-base-chinese"
LABELS = ["O", "B-PER", "I-PER", "B-LOC", "I-LOC", "B-ORG", "I-ORG"]
ID2LABEL = {index: label for index, label in enumerate(LABELS)}
LABEL2ID = {label: index for index, label in ID2LABEL.items()}

def build_dataset():
    samples = {
        "tokens": [
            ["张三", "在", "北京", "工作"],
            ["李四", "加入", "阿里巴巴"],
            ["王五", "来自", "上海"],
            ["赵六", "就职", "腾讯"],
            ["陈晨", "前往", "深圳"],
            ["刘洋", "访问", "杭州"],
            ["周敏", "入职", "百度"],
            ["吴迪", "居住", "广州"],
        ],
        "ner_tags": [
            [1, 0, 3, 0],
            [1, 0, 5],
            [1, 0, 3],
            [1, 0, 5],
            [1, 0, 3],
            [1, 0, 3],
            [1, 0, 5],
            [1, 0, 3],
        ],
    }
    return Dataset.from_dict(samples).train_test_split(test_size=0.25, seed=42)

def align_labels(batch, tokenizer):
    tokenized = tokenizer(
        batch["tokens"],
        truncation=True,
        is_split_into_words=True,
        max_length=128,
    )
    aligned_batch = []

    for batch_index, word_labels in enumerate(batch["ner_tags"]):
        word_ids = tokenized.word_ids(batch_index=batch_index)
        previous_word_id = None
        aligned_labels = []

        for word_id in word_ids:
            if word_id is None or word_id == previous_word_id:
                aligned_labels.append(-100)
            else:
                aligned_labels.append(word_labels[word_id])
            previous_word_id = word_id

        aligned_batch.append(aligned_labels)

    tokenized["labels"] = aligned_batch
    return tokenized

def compute_metrics(eval_pred):
    logits, labels = eval_pred
    predictions = np.argmax(logits, axis=-1)
    true_predictions = []
    true_labels = []

    for prediction_row, label_row in zip(predictions, labels):
        predicted_tags = []
        gold_tags = []

        for prediction, label in zip(prediction_row, label_row):
            if label == -100:
                continue
            predicted_tags.append(ID2LABEL[int(prediction)])
            gold_tags.append(ID2LABEL[int(label)])

        true_predictions.append(predicted_tags)
        true_labels.append(gold_tags)

    return {
        "precision": precision_score(true_labels, true_predictions, zero_division=0),
        "recall": recall_score(true_labels, true_predictions, zero_division=0),
        "f1": f1_score(true_labels, true_predictions, zero_division=0),
        "accuracy": accuracy_score(true_labels, true_predictions),
    }

def main():
    set_seed(42)
    dataset = build_dataset()
    tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME, use_fast=True)

    tokenized = dataset.map(
        lambda batch: align_labels(batch, tokenizer),
        batched=True,
        remove_columns=dataset["train"].column_names,
    )

    model = AutoModelForTokenClassification.from_pretrained(
        MODEL_NAME,
        num_labels=len(LABELS),
        id2label=ID2LABEL,
        label2id=LABEL2ID,
    )

    args = TrainingArguments(
        output_dir="./token-classifier-output",
        learning_rate=2e-5,
        per_device_train_batch_size=4,
        per_device_eval_batch_size=4,
        num_train_epochs=3,
        weight_decay=0.01,
        eval_strategy="epoch",
        save_strategy="no",
        logging_strategy="no",
        disable_tqdm=True,
        report_to="none",
    )

    trainer = Trainer(
        model=model,
        args=args,
        train_dataset=tokenized["train"],
        eval_dataset=tokenized["test"],
        data_collator=DataCollatorForTokenClassification(tokenizer=tokenizer),
        processing_class=tokenizer,
        compute_metrics=compute_metrics,
    )

    trainer.train()
    metrics = trainer.evaluate()
    print(f"eval_f1={metrics['eval_f1']:.4f}")

    words = ["小明", "去了", "深圳"]
    encoded = tokenizer(
        words,
        is_split_into_words=True,
        return_tensors="pt",
        truncation=True,
        max_length=128,
    )
    word_ids = encoded.word_ids(batch_index=0)
    model_inputs = {
        name: value.to(trainer.model.device)
        for name, value in encoded.items()
    }

    trainer.model.eval()
    with torch.no_grad():
        predictions = trainer.model(**model_inputs).logits.argmax(dim=-1)[0].tolist()

    seen_word_ids = set()
    for token_index, word_id in enumerate(word_ids):
        if word_id is None or word_id in seen_word_ids:
            continue
        seen_word_ids.add(word_id)
        print(f"{words[word_id]}\t{ID2LABEL[predictions[token_index]]}")

if __name__ == "__main__":
    main()
预期输出:
eval_f1=<F1>
小明    <BIO_LABEL>
去了    <BIO_LABEL>
深圳    <BIO_LABEL>
<F1> 和 <BIO_LABEL> 由实际训练结果决定,标签应来自代码中的 LABELS。示例样本极少,输出主要用于确认训练、评估和逐词聚合链路能够运行,不应用它判断模型是否达到业务精度。
评估实体而不是只看词元
命名实体识别更关注完整实体是否被正确识别。预测出“北”为 B-LOC、却漏掉“京”,词元准确率可能仍不低,但实体“北京”已经识别失败。因此评估通常应按实体边界计算精确率、召回率和 F1,而不是只看逐词准确率。
BIO 序列还要检查结构合法性,例如 I-ORG 不应无条件出现在句首,也不应直接跟在 B-PER 后。若业务要求严格,可在推理后增加合法性修正,或使用带条件随机场的分类头建模标签转移约束。
常见错位与验收方法
第一类错误是忘记为特殊词元填充 -100,导致标签整体偏移;第二类错误是把一个词语拆成多个子词后重复复制 B- 标签,造成多个虚假实体开始;第三类错误是训练与推理采用不同分词器,使 word_ids 映射失效。
验收时应人工挑选包含单字词、多字词、英文缩写、数字和标点的样本,打印原始词语、词元、word_ids 与对齐标签。确认每个原始词语只有一个受监督位置后,再开始长时间训练。
本课总结
- 序列标注的核心难点是让原始标注单位与模型子词位置准确对齐
- 特殊词元和非首子词可设为
-100,从损失与评估中排除 - NER 应优先使用实体级精确率、召回率和 F1 验收边界质量
下一课预告
下一课将进一步讨论预训练模型在真实应用中的推理封装、批量处理与模型保存,让微调结果能够稳定接入业务服务。