
大模型原理与训练 / 系统课时
编码器堆叠
编码器堆叠
单个编码器层只能完成一次“注意力聚合与特征变换”。本课将多个结构相同但参数独立的编码器层串联起来,并通过可运行示例说明层数、隐藏维度与注意力头数之间必须满足的约束。
学习目标
- 理解编码器层堆叠后信息如何逐层更新
- 掌握
num_layers、d_model与nhead的约束 - 能用 PyTorch 构建并验证多层编码器
为什么要堆叠编码器层
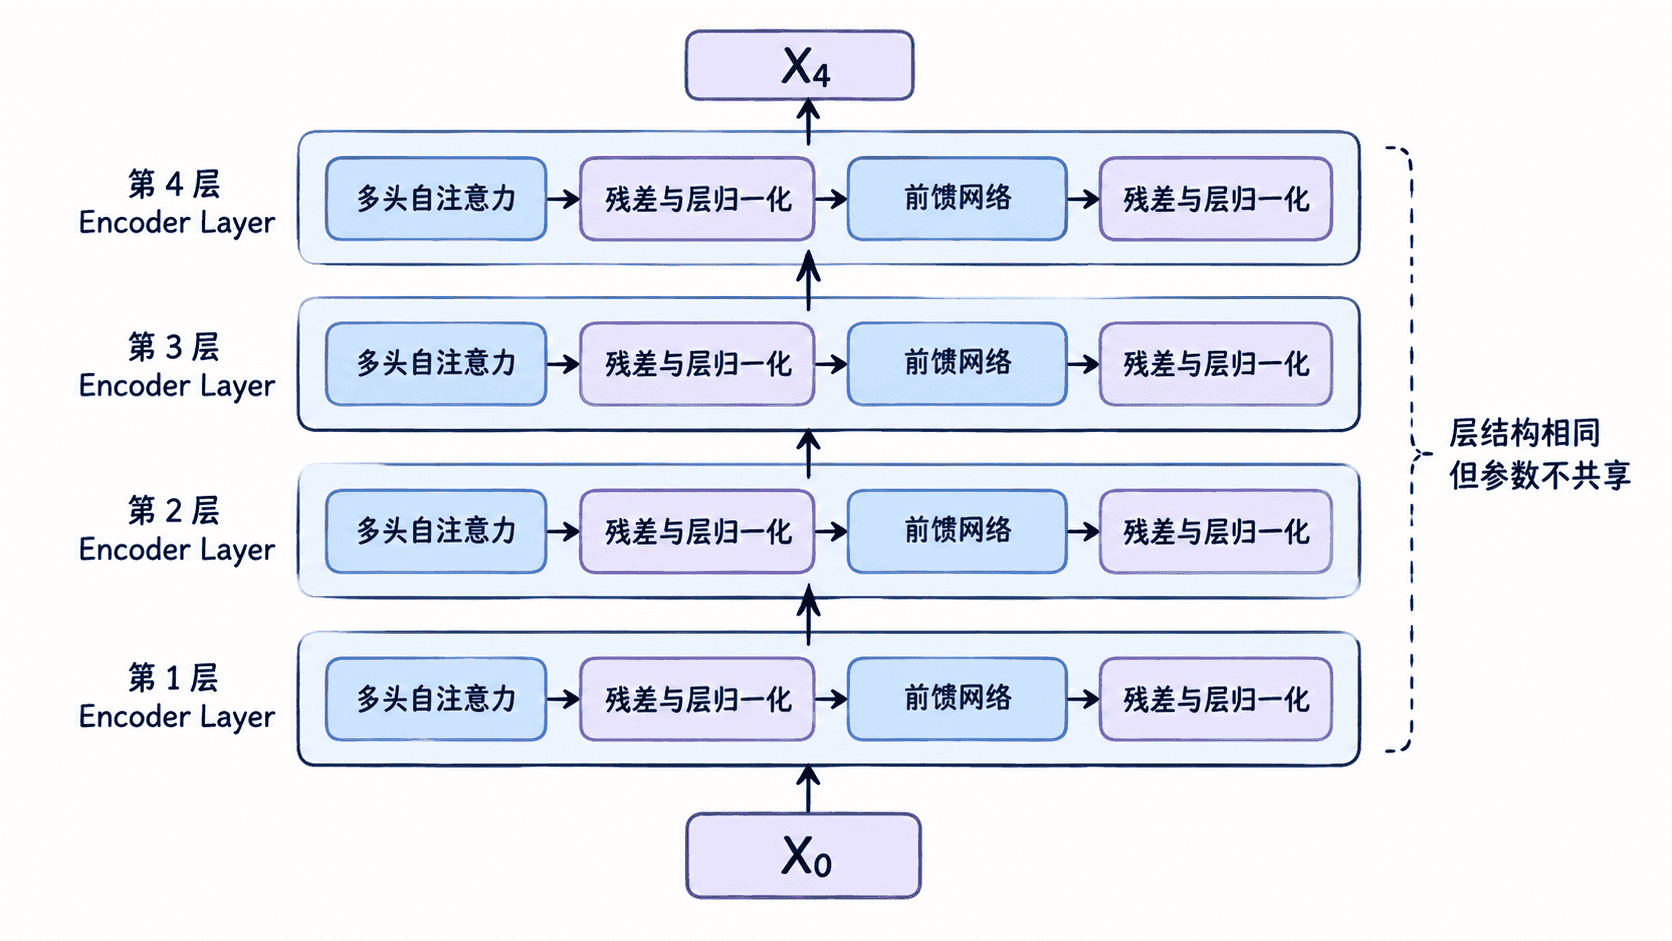
每个编码器层都包含多头自注意力和前馈网络。第一层更容易组合局部或直接相关的信息,后续层继续在上一层表示上建模,使一个词元能够间接吸收更远、更抽象的上下文。
堆叠并不是复制同一份计算结果。各层结构相同,但权重参数彼此独立。设输入为 ,第 层的输出会成为下一层输入:
三个关键参数及约束
d_model 是每个词元向量的总维度,nhead 是并行注意力头数,单头维度为:
因此 d_model 必须能被 nhead 整除。例如 d_model=256、nhead=8 时,每个头处理 32 维;若设为 250 和 8,框架会直接报错。
dim_feedforward 是前馈网络的中间维度,通常大于 d_model。num_layers 决定编码器深度,会同时增加计算量、参数量和训练难度,但不会改变输出张量的形状。
| 参数 | 作用 | 主要约束 |
|---|---|---|
d_model |
词元隐藏维度 | 与输入嵌入维度一致 |
nhead |
注意力头数 | d_model % nhead == 0 |
num_layers |
编码器层数 | 正整数,越深开销越大 |
dim_feedforward |
前馈中间维度 | 通常大于 d_model |
构建多层编码器
下面的示例创建 4 层编码器。输入批次包含 2 条序列,每条长度为 6,每个词元使用 32 维表示。
import torch
from torch import nn

torch.manual_seed(0)

batch_size = 2
seq_len = 6
d_model = 32
nhead = 4

encoder_layer = nn.TransformerEncoderLayer(
    d_model=d_model,
    nhead=nhead,
    dim_feedforward=64,
    batch_first=True,
    norm_first=True,
)
encoder = nn.TransformerEncoder(
    encoder_layer=encoder_layer,
    num_layers=4,
)

# 每层保持 [批次, 序列长度, 隐藏维度] 不变
x = torch.randn(batch_size, seq_len, d_model)
output = encoder(x)

print("input shape:", tuple(x.shape))
print("output shape:", tuple(output.shape))
print("layer count:", len(encoder.layers))
预期输出:
input shape: (2, 6, 32)
output shape: (2, 6, 32)
layer count: 4
虽然输入与输出形状一致,但输出数值已经经历 4 次上下文聚合与非线性变换。实际运行时,PyTorch 版本可能打印额外警告,但上述三行形状结果不变。
层数如何选择
层数不是越多越好。浅层模型训练更快,适合小数据集、短序列或教学验证;更深模型表达能力更强,但需要更稳定的优化、更多显存和更充分的数据。
增加层数前应先固定 d_model、头数和训练配置,再比较验证集效果。若训练损失下降而验证效果不升,问题通常是过拟合,而不是继续加层就能解决。
常见错误是把“层数增加”和“隐藏维度增加”混为一谈。增加层数提升的是变换深度;增加 d_model 扩大的是每个词元的表示容量,两者影响不同。
本课总结
- 编码器堆叠通过多次上下文聚合逐层形成更抽象的表示
- 各层结构相同但参数独立,输出形状通常保持
[B, L, D] d_model必须能被nhead整除,层数应根据数据与计算预算选择
下一课预告
下一课将分析编码器最终输出的含义,并说明同一个 [B, L, D] 张量如何服务于分类、序列标注和特征提取。