
大模型原理与训练 / 系统课时
批量推理
批量推理
本课把逐条预测改造成可控的批量推理流程。你将使用动态填充避免所有请求都补到固定最大长度,再通过长度分组和批次上限提高设备利用率,同时保留原始请求顺序,便于直接接入在线服务。
学习目标
- 使用动态填充把每个批次补齐到本批最长序列
- 通过长度分组降低填充浪费并提升吞吐量
- 在批量执行后恢复请求顺序并设置延迟保护参数
批量推理的核心取舍
批量越大,GPU 一次可并行处理的样本越多,单位样本开销通常越低;但请求需要等待凑批,单条延迟可能上升。另一方面,Transformer 的计算量与序列长度密切相关,若一个很长的样本和多个短样本放在同一批次,短样本也会被填充到相同长度。
因此,批量推理不能只设置 batch_size。在线系统至少还要同时限制最大等待时间和每批总词元数,离线任务则可以优先追求吞吐量,并使用更大的批次和更积极的长度排序。
动态填充与批次调度
动态填充只把样本补齐到当前批次的最长长度;长度分组则先把长度接近的请求放在一起。两者组合后,可明显减少 Padding 参与注意力计算的比例。为了不改变调用方看到的顺序,调度前要记录原始索引,推理后再按索引写回结果。
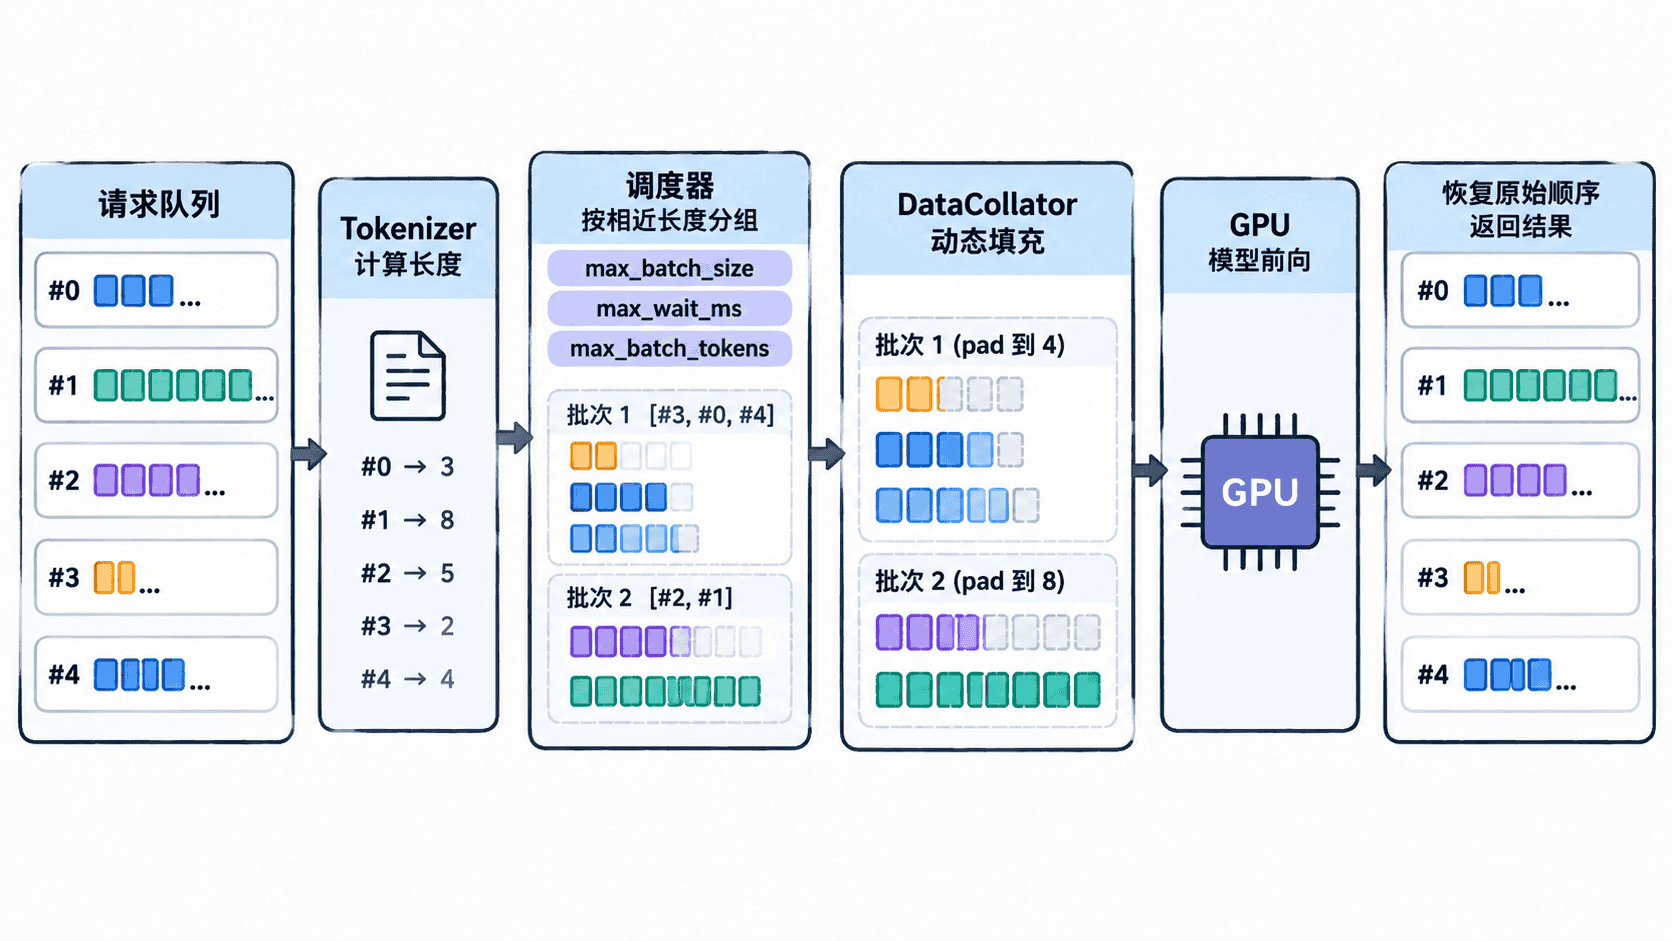
在线调度通常采用短时间窗口收集请求,再在窗口内按长度分桶。窗口过小会导致批次填不满,过大则会增加排队延迟。生产环境应通过压测寻找稳定点,而不是直接照搬训练阶段的批大小。
完整批量推理示例
下面的示例使用 DataCollatorWithPadding 完成动态填充,并在组批前按词元长度排序。模型只提取隐藏状态,因此示例不依赖具体分类标签;运行结果重点验证批次数、动态长度和返回顺序。
import torch
from transformers import AutoModel, AutoTokenizer, DataCollatorWithPadding

MODEL_NAME = "distilbert-base-uncased"
BATCH_SIZE = 3
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

requests = [
    {"id": "r1", "text": "A short request."},
    {"id": "r2", "text": "This request contains a few more words for testing."},
    {"id": "r3", "text": "Tiny input."},
    {"id": "r4", "text": "A considerably longer request used to demonstrate dynamic padding inside a batch."},
    {"id": "r5", "text": "Medium length text for inference."},
]

tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)
model = AutoModel.from_pretrained(MODEL_NAME).to(device)
model.eval()
collator = DataCollatorWithPadding(tokenizer=tokenizer, return_tensors="pt")

encoded_items = []
for original_index, item in enumerate(requests):
    encoded = tokenizer(item["text"], truncation=True, max_length=128)
    encoded_items.append(
        {
            "original_index": original_index,
            "request_id": item["id"],
            "features": encoded,
            "token_length": len(encoded["input_ids"]),
        }
    )

# 将长度接近的请求放入同一批次,减少无效 Padding。
encoded_items.sort(key=lambda item: item["token_length"])
results = [None] * len(requests)

for batch_no, start in enumerate(range(0, len(encoded_items), BATCH_SIZE), start=1):
    chunk = encoded_items[start : start + BATCH_SIZE]
    batch = collator([item["features"] for item in chunk])
    padded_length = int(batch["input_ids"].shape[1])
    batch = {name: tensor.to(device) for name, tensor in batch.items()}

    with torch.inference_mode():
        hidden = model(**batch).last_hidden_state

    # 按原始索引写回,避免长度排序改变接口返回顺序。
    for row, item in enumerate(chunk):
        results[item["original_index"]] = {
            "id": item["request_id"],
            "hidden_shape": tuple(hidden[row].shape),
        }

    print(f"batch={batch_no},size={len(chunk)},padded_length={padded_length}")

print(f"result_order={[item['id'] for item in results]}")
print(f"processed={len(results)}")预期输出如下。padded_length 取决于分词器版本和输入文本,实际值可能不同;批次数、批大小和恢复后的请求顺序应保持一致。
batch=1,size=3,padded_length=<TOKENS>
batch=2,size=2,padded_length=<TOKENS>
result_order=['r1', 'r2', 'r3', 'r4', 'r5']
processed=5
生产参数与验收
在线批处理建议同时设置三个边界:max_batch_size 限制样本数,max_wait_ms 限制排队时间,max_batch_tokens 限制本批总词元量。只限制样本数时,几个超长请求仍可能造成显存峰值;只限制词元数时,又可能产生过多极小请求。
验收时应分别记录吞吐量、端到端延迟分位数和 Padding 占比。若吞吐量提高但 P95 延迟明显恶化,应缩短等待窗口或为短请求设置独立队列;若频繁显存溢出,应先降低总词元上限,再检查是否存在异常长文本未截断。
本课总结
- 动态填充按批次最长序列补齐,长度分组进一步减少无效计算
- 批量调度要同时约束样本数、等待时间和总词元数,不能只看
batch_size - 调度前保存原始索引,推理后按索引写回,才能兼顾吞吐量与接口顺序
下一课预告
下一课将继续优化部署链路,分析模型量化如何降低显存和计算成本,以及量化后需要重点验证的精度与算子兼容性。