
大模型原理与训练 / 系统课时
子词分词算法
子词分词算法
子词分词算法要解决的核心问题,是在有限词表中选择一组可复用片段,使常见文本切得更短,罕见词又能被拆解。本课比较 BPE、WordPiece 和 Unigram 的基本思想,并用一个简化 BPE 过程观察词表如何逐步形成。
学习目标
- 说明 BPE、WordPiece 和 Unigram 的核心决策方式
- 理解子词词表从初始单元到稳定片段的构建过程
- 根据训练目标判断三种算法的主要差异
子词词表要优化什么
若词表只包含字符,任何词都能表示,但序列较长;若词表保存所有完整单词,序列会缩短,却难以覆盖新词。子词算法因此在语料统计与词表上限之间寻找折中。
训练阶段会读取大量文本,统计片段出现方式,并反复更新候选词元。得到词表后,推理阶段只执行切分与查表,不会再根据单条输入重新训练词表。
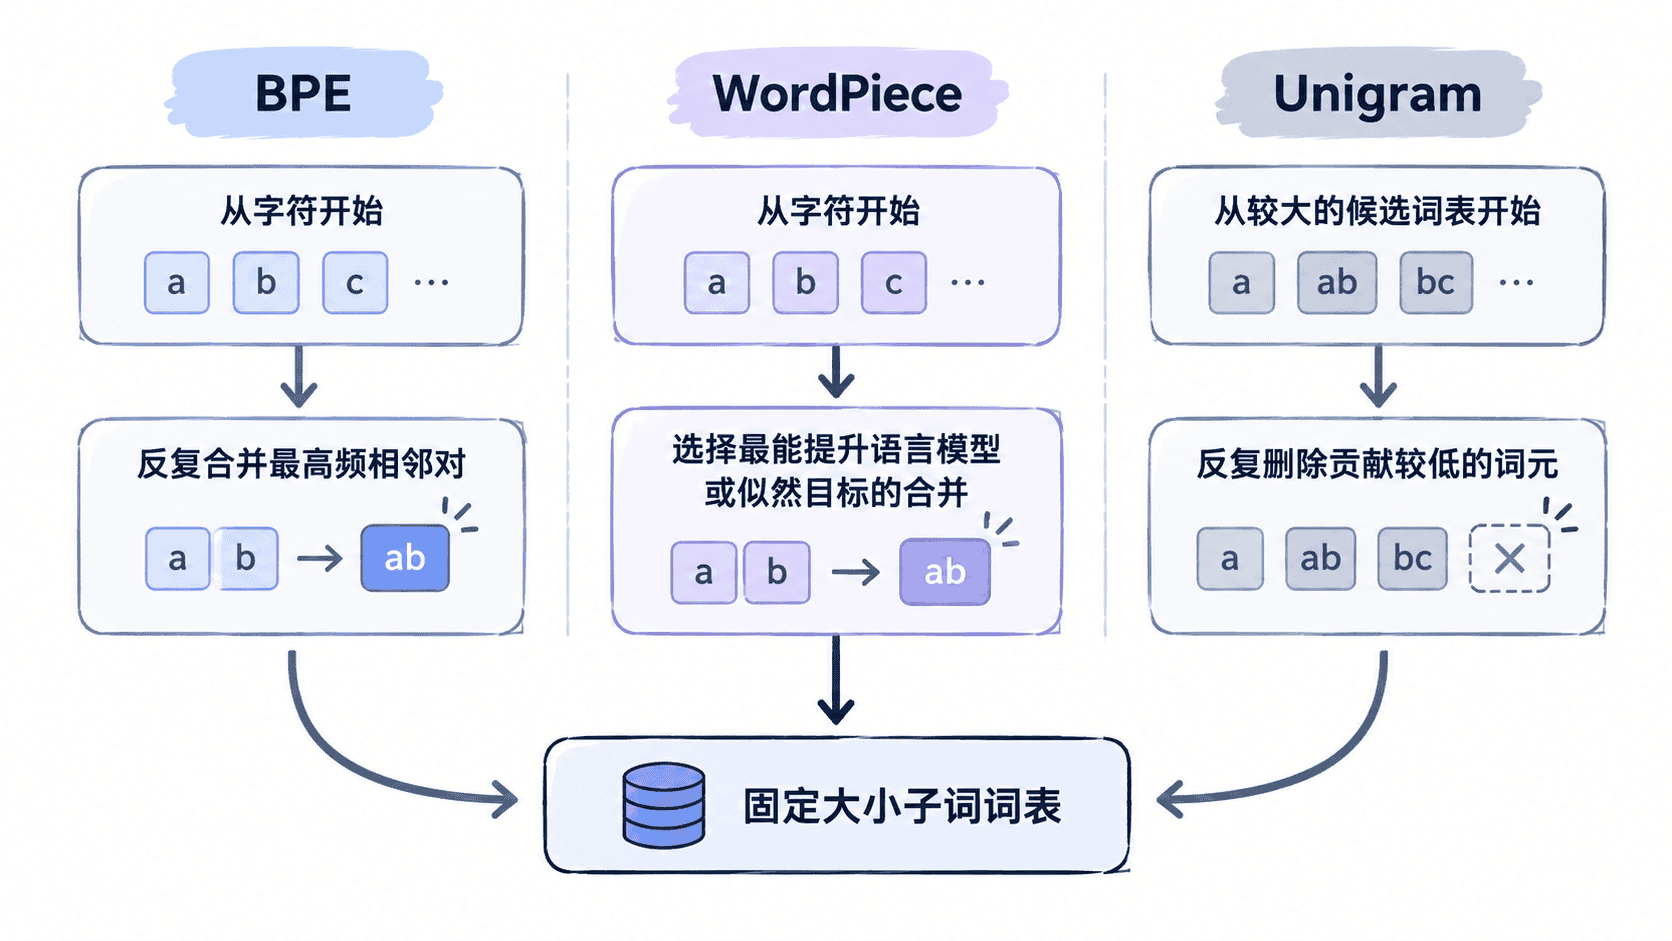
BPE:反复合并高频相邻对
BPE 通常从字符或字节级单元开始。每一轮统计所有相邻词元对,找到频率最高的一对,将它合并成新词元;重复这一过程,直到词表达到目标大小。
假设语料中 l o w、l o w e r 和 n e w e r 多次出现,算法可能先合并高频的 e r,再合并 l o 或 lo w。最终词表会保留在语料中反复出现的片段。
下面实现一个简化版本,只展示单轮“统计并合并最高频词元对”的过程。
from collections import Counter

def most_frequent_pair(words: list[list[str]]) -> tuple[str, str]:
    counts: Counter[tuple[str, str]] = Counter()
    for word in words:
        counts.update(zip(word, word[1:]))
    return counts.most_common(1)[0][0]

def merge_pair(words: list[list[str]], pair: tuple[str, str]) -> list[list[str]]:
    merged_words: list[list[str]] = []
    for word in words:
        result: list[str] = []
        index = 0
        while index < len(word):
            # 相邻位置命中目标词元对时,将它们替换为一个新词元。
            if index + 1 < len(word) and (word[index], word[index + 1]) == pair:
                result.append(word[index] + word[index + 1])
                index += 2
            else:
                result.append(word[index])
                index += 1
        merged_words.append(result)
    return merged_words

def main() -> None:
    words = [
        list("low"),
        list("low"),
        list("lower"),
        list("newer"),
    ]
    pair = most_frequent_pair(words)
    print("最高频词元对:", pair)
    print("合并结果:", merge_pair(words, pair))

if __name__ == "__main__":
    main()
预期输出:
最高频词元对: ('l', 'o')
合并结果: [['lo', 'w'], ['lo', 'w'], ['lo', 'w', 'e', 'r'], ['n', 'e', 'w', 'e', 'r']]
这里 ('l', 'o') 在示例语料中出现三次,因此先被合并。真实 BPE 会按词频加权、处理词边界,并连续执行多轮。
WordPiece:选择收益更高的合并
WordPiece 也常从较小单元开始并逐步扩展词表,但它不只看相邻对的原始频率。其典型思想是评估某次合并对训练目标的改善,优先选择能更好解释语料的片段。
因此,一个相邻对即使出现次数较多,也不一定最先被选中;如果两个组成部分本身已经非常常见,这次合并带来的额外收益可能有限。不同实现对评分公式和预处理细节会有所差异,但核心仍是“按目标收益选择词元”。
在编码结果中,WordPiece 常用特殊形式标记“词中续接片段”,例如 play 与 ##ing。这种标记是词表约定,不代表 Markdown 标题。
Unigram:从大词表逐步删减
Unigram 的方向与前两者不同。它先准备一个较大的候选子词集合,为每个词元分配概率,再反复删除对整体语料似然贡献较低的词元,直到词表缩减到目标规模。
同一个单词可能存在多种合法切分路径,训练时会比较这些路径的概率。由于它保留了概率模型,Unigram 也便于进行子词正则化:训练阶段可以随机采样不同切分,减少模型对单一边界的依赖。
三种算法如何选择
| 算法 | 初始方向 | 主要决策依据 | 直观特征 |
|---|---|---|---|
| BPE | 小词表逐步扩大 | 高频相邻对 | 规则直观,实现简单 |
| WordPiece | 小词表逐步扩大 | 合并对目标的收益 | 强调语料解释能力 |
| Unigram | 大候选词表逐步缩小 | 删除后的概率损失 | 支持多路径概率切分 |
实际模型还会结合文本规范化、字节回退、特殊词元和多语言策略。判断分词器能力时,应同时查看算法、训练语料与词表配置,而不能只根据算法名称下结论。
本课总结
- BPE 通过反复合并高频相邻对扩展词表
- WordPiece 更关注候选合并对训练目标带来的收益
- Unigram 从大候选集合出发,通过概率模型逐步删除低贡献词元
下一课预告
下一课将把词元编号转换为可训练的连续向量,理解嵌入矩阵如何为每个词元提供初始表示。