
大模型原理与训练 / 系统课时
实现训练循环
实现训练循环
本课把已经定义好的 Transformer 接入一个可运行的训练循环,完成批次读取、前向计算、损失反传、梯度裁剪、参数更新、学习率调度和日志记录,并说明这些步骤为什么必须保持固定顺序。
学习目标
- 能写出完整且可运行的 PyTorch 训练循环
- 能正确安排反向传播、参数更新与学习率调度顺序
- 能通过损失、学习率和梯度状态判断训练是否正常
训练循环的固定顺序
一次参数更新由一组相互依赖的步骤组成。先清空上一批梯度,再执行前向计算与损失计算;随后反向传播得到当前梯度,必要时做梯度裁剪,最后更新参数并推进学习率调度器。
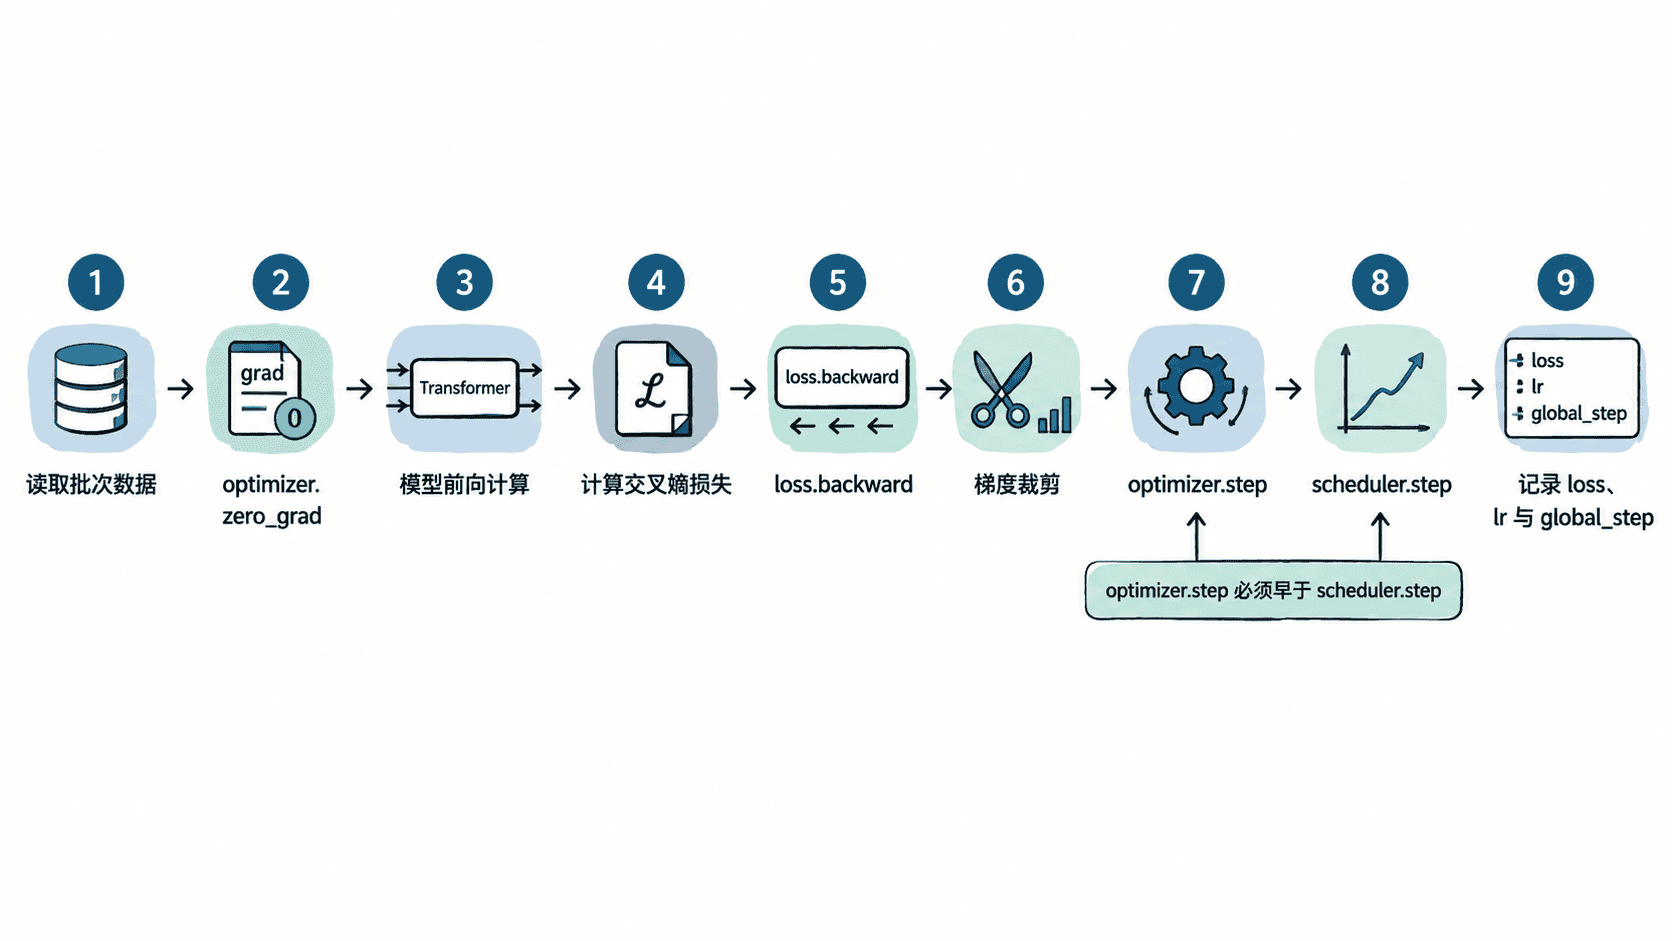
最常见的错误是遗漏 zero_grad(),导致不同批次的梯度不断累加;另一类错误是先调用调度器再更新参数,使学习率时间点整体偏移。除非明确实现梯度累积,否则应保持图中的顺序。
完整可运行示例
下面使用一个小型自回归语言模型演示训练循环。模型接收长度为 12 的词元序列,预测每个位置的下一个词元;数据是人工构造的递增序列,因此无需下载外部数据集。
import random

import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

class TinyLanguageModel(nn.Module):
    def __init__(self, vocab_size: int, seq_len: int, d_model: int = 32) -> None:
        super().__init__()
        self.token_embedding = nn.Embedding(vocab_size, d_model)
        self.position_embedding = nn.Embedding(seq_len, d_model)
        encoder_layer = nn.TransformerEncoderLayer(
            d_model=d_model,
            nhead=4,
            dim_feedforward=64,
            dropout=0.0,
            batch_first=True,
        )
        self.encoder = nn.TransformerEncoder(encoder_layer, num_layers=2)
        self.output = nn.Linear(d_model, vocab_size)

    def forward(self, token_ids: torch.Tensor) -> torch.Tensor:
        _, seq_len = token_ids.shape
        positions = torch.arange(seq_len, device=token_ids.device)
        hidden = self.token_embedding(token_ids)
        hidden = hidden + self.position_embedding(positions)

        # 上三角区域为 True,阻止当前位置看到未来词元。
        causal_mask = torch.triu(
            torch.ones(seq_len, seq_len, dtype=torch.bool, device=token_ids.device),
            diagonal=1,
        )
        encoded = self.encoder(hidden, mask=causal_mask)
        return self.output(encoded)

def build_dataset(vocab_size: int, sample_count: int, seq_len: int) -> TensorDataset:
    starts = torch.arange(sample_count) % vocab_size
    offsets = torch.arange(seq_len + 1)
    sequences = (starts[:, None] + offsets[None, :]) % vocab_size
    return TensorDataset(sequences[:, :-1], sequences[:, 1:])

def main() -> None:
    random.seed(7)
    torch.manual_seed(7)

    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
    vocab_size = 50
    seq_len = 12
    epochs = 3

    dataset = build_dataset(vocab_size, sample_count=64, seq_len=seq_len)
    loader = DataLoader(dataset, batch_size=8, shuffle=True)
    model = TinyLanguageModel(vocab_size, seq_len).to(device)

    optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3, weight_decay=0.01)
    criterion = nn.CrossEntropyLoss()
    total_steps = epochs * len(loader)
    warmup_steps = 5

    def lr_scale(step: int) -> float:
        if step < warmup_steps:
            return step / max(1, warmup_steps)
        return max(0.0, (total_steps - step) / max(1, total_steps - warmup_steps))

    scheduler = torch.optim.lr_scheduler.LambdaLR(optimizer, lr_scale)
    global_step = 0
    model.train()

    for epoch in range(epochs):
        for input_ids, target_ids in loader:
            input_ids = input_ids.to(device)
            target_ids = target_ids.to(device)

            optimizer.zero_grad(set_to_none=True)
            logits = model(input_ids)
            loss = criterion(
                logits.reshape(-1, vocab_size),
                target_ids.reshape(-1),
            )

            loss.backward()
            grad_norm = nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
            optimizer.step()
            scheduler.step()
            global_step += 1

            if global_step == 1 or global_step % len(loader) == 0:
                lr = scheduler.get_last_lr()[0]
                print(
                    f"step={global_step:02d}/{total_steps} "
                    f"epoch={epoch + 1} loss={loss.item():.4f} "
                    f"grad_norm={float(grad_norm):.4f} lr={lr:.6f}"
                )

if __name__ == "__main__":
    main()
预期输出
step=01/24 epoch=1 loss=<LOSS> grad_norm=<GRAD_NORM> lr=0.000200
step=08/24 epoch=1 loss=<LOSS> grad_norm=<GRAD_NORM> lr=0.000842
step=16/24 epoch=2 loss=<LOSS> grad_norm=<GRAD_NORM> lr=0.000421
step=24/24 epoch=3 loss=<LOSS> grad_norm=<GRAD_NORM> lr=0.000000
<LOSS> 与 <GRAD_NORM> 会随 PyTorch 版本、设备和底层算子略有差异,但应为有限数值。学习率则按照 5 步预热、随后线性衰减的规则变化,最后降到 0。
关键状态如何检查
训练时至少记录 global_step、当前损失、学习率和梯度范数。损失长期不下降时,先确认目标序列是否右移正确,再检查学习率是否过大;梯度范数持续为 nan 或异常增大时,应降低学习率并检查输入、掩码和损失计算。
model.train() 会启用 Dropout 等训练行为。验证阶段应切换到 model.eval(),并在 torch.no_grad() 中执行,避免构建无用的计算图。验证结束后,再显式切回训练模式。
常见边界
显存不足时,可缩小批次或使用梯度累积。梯度累积要求把损失除以累积步数,并且只在边界步执行 optimizer.step()、scheduler.step() 和 zero_grad(),不能直接复制普通训练循环。
学习率调度器通常按参数更新次数推进,而不是按读取批次数推进。若某个批次因无效数据被跳过,就不应推进调度器,否则学习率会在没有更新参数的情况下继续衰减。
本课总结
- 标准训练步的核心顺序是清梯度、前向、反向、裁剪、更新参数、更新学习率
- 日志至少应包含损失、学习率、梯度范数和全局步数
- 学习率调度器必须与真正发生的参数更新保持同步
下一课预告
下一课将把模型参数、优化器、调度器和训练进度一起保存为检查点,并实现进程中断后的断点续训。