
大模型原理与训练 / 系统课时
RNN 与 CNN 的局限
RNN 与 CNN 的局限
RNN 和 CNN 都能处理序列,但它们在信息传递路径、长距离依赖和并行效率上存在明显限制。本课将从计算过程解释这些瓶颈,为后续理解 Transformer 为什么使用注意力机制建立基础。
学习目标
- 理解 RNN 顺序计算带来的效率和记忆问题
- 理解 CNN 扩大感受野所付出的结构成本
- 能根据依赖距离和并行需求判断两类模型的局限
RNN 的顺序计算瓶颈
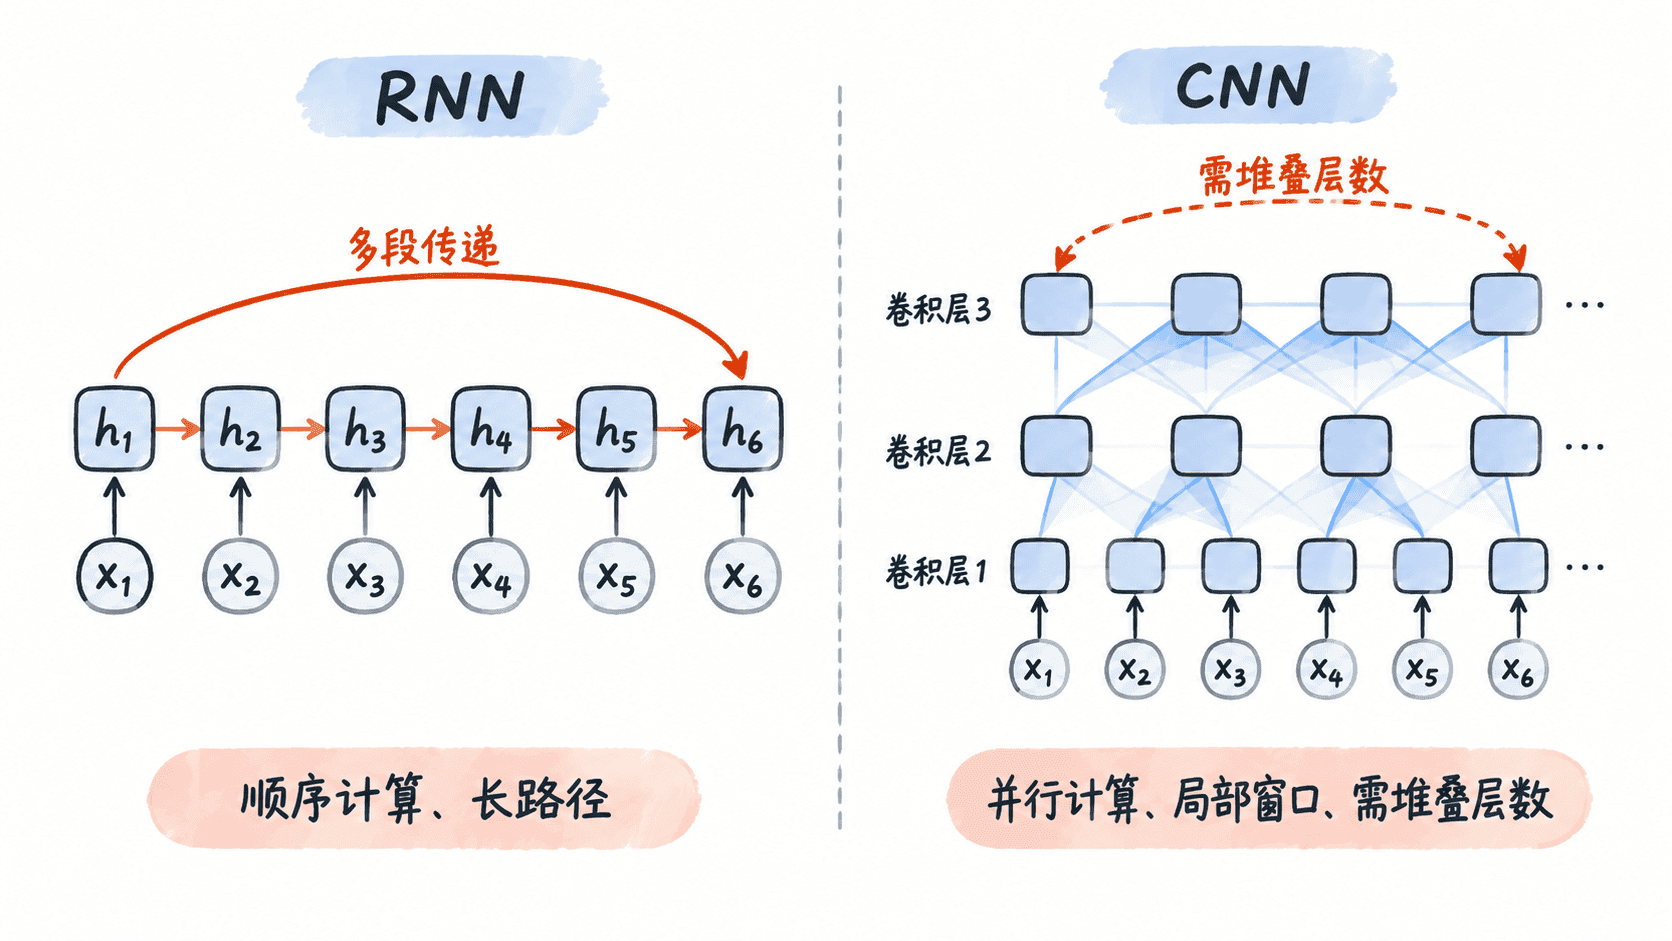
RNN 按时间步逐个处理序列。第 个位置的隐藏状态依赖第 个位置,因此后一个位置必须等待前一个位置完成计算。即使硬件拥有大量并行单元,单条序列内部仍存在严格的先后依赖。
当序列很长时,这种链式计算会增加训练时间。早期信息还必须经过许多次状态更新才能影响后面的输出,传递路径越长,信息越容易被削弱或覆盖。
训练时,梯度需要沿时间方向反复相乘,容易出现梯度消失或梯度爆炸。LSTM 和 GRU 通过门控结构缓解了问题,但没有消除顺序执行和长路径传递的根本限制。
CNN 的局部窗口限制
CNN 通过卷积核同时扫描多个位置,单层计算可以并行完成,因此训练效率通常优于传统 RNN。卷积天然擅长捕捉局部模式,例如相邻词组、短音频片段或短期波动。
但单层卷积只能看到有限窗口。若要让相距很远的两个位置交换信息,就需要堆叠更多卷积层、增大卷积核,或使用空洞卷积。这样虽然能扩大感受野,却会增加网络深度、结构设计和优化难度。
共同瓶颈与改进方向
RNN 的优势是状态天然按时间推进,代价是序列内部难以并行,远距离信息必须经过很长的传递链。CNN 的优势是局部计算可并行,代价是远距离依赖需要通过更深网络间接建立。
因此,问题不在于它们完全不能处理长序列,而在于远距离位置之间缺少直接、高效的信息交互。序列越长,模型越需要在计算效率、网络深度和信息保真之间权衡。
理想的序列模型应让任意位置直接交换信息,允许整段序列并行计算,并自动判断哪些位置更重要。注意力机制围绕这些目标设计,而 Transformer 进一步用注意力替代循环传递,缩短长距离依赖的信息路径。
本课总结
- RNN 的主要瓶颈是顺序执行和长距离信息的链式传递
- CNN 可以并行处理局部模式,但扩大感受野通常需要更深结构
- 两类模型都缺少直接、高效的全局信息交互方式
下一课预告
下一课将进入 Transformer 的整体结构,认识编码器、解码器、注意力层和前馈网络如何协同完成序列建模。