
大模型原理与训练 / 系统课时
注意力权重聚合
注意力权重聚合
本课解释注意力权重如何真正生成新表示。你将把 Softmax 得到的权重与 Value 向量对应相乘并求和,理解输出为何会随当前查询改变,以及矩阵形式 中每个维度承担的职责。
学习目标
- 写出注意力权重聚合的向量与矩阵公式
- 解释 Key、Value 和注意力权重的不同职责
- 根据给定权重计算上下文向量
从权重到上下文表示
对第 个查询,Softmax 会产生一组权重 。这些权重均不小于 0,且总和为 1。输出向量是所有 Value 向量的加权和:
权重越大,对应 Value 对输出的贡献越大。由于不同查询会产生不同权重,同一组 Value 可以被聚合成不同的上下文表示。
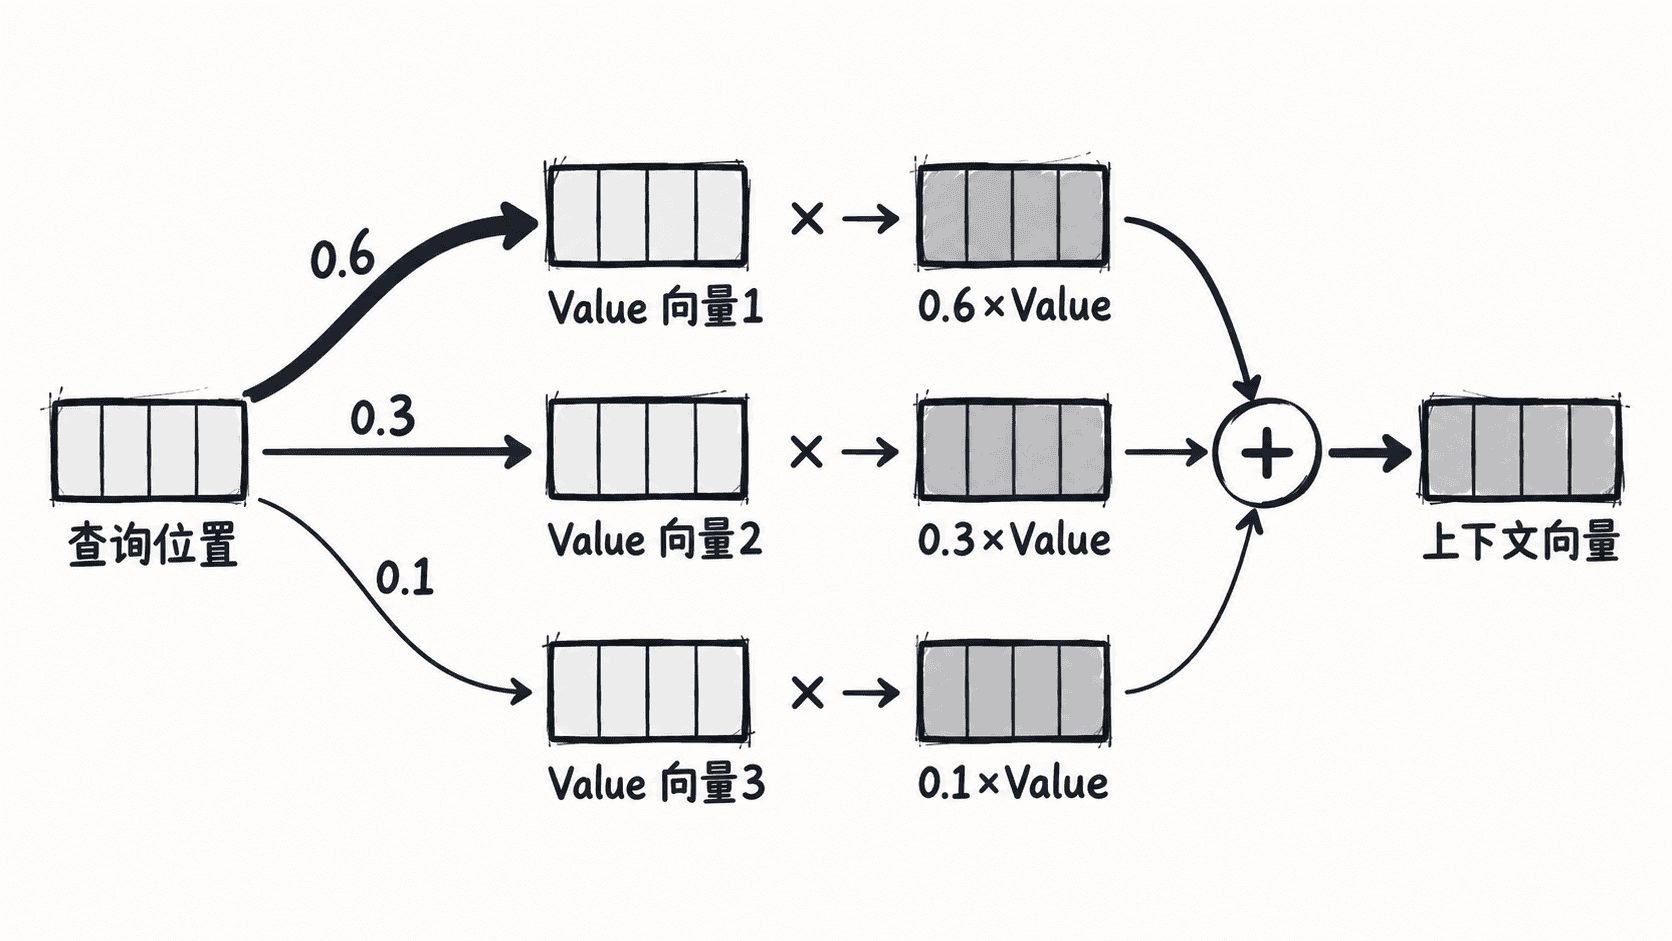
Key 决定“关注哪个位置”,Value 决定“从该位置取出什么信息”。注意力权重是二者之间的桥梁,它不会直接复制某个 Value,而是形成按相关性混合后的结果。
矩阵计算与示例
设注意力权重矩阵为 ,Value 矩阵为 ,则聚合结果为:
矩阵 的每一行对应一个查询,矩阵 的每一行对应一个键位置的 Value。内侧维度 必须一致,输出会保留查询数量和 Value 特征维度。
下面计算一组权重对三个二维 Value 的聚合结果:
python
def weighted_sum(weights, values):
    dimension = len(values[0])
    result = [0.0] * dimension

    # 每个权重控制对应 Value 对结果的贡献比例。
    for weight, value in zip(weights, values):
        for index in range(dimension):
            result[index] += weight * value[index]

    return result

def main():
    weights = [0.6, 0.3, 0.1]
    values = [
        [1.0, 0.0],
        [0.0, 2.0],
        [3.0, 1.0],
    ]

    context = weighted_sum(weights, values)
    print([round(number, 2) for number in context])

if __name__ == "__main__":
    main()
预期输出:
text
[0.9, 0.7]第一维为 ,第二维为 。结果不是任一原始 Value,而是由当前查询决定的上下文混合表示。
关键边界
- 权重矩阵通常按行归一化,每一行独立描述一个查询的关注分布
- 被遮蔽位置应在 Softmax 前加入掩码,使其最终权重接近 0
- 聚合使用 Value,而不是再次使用 Key;Key 用于匹配,Value 用于承载内容
- 所有 Value 必须具有相同的特征维度,否则无法组成矩阵并参与乘法
本课总结
- 注意力输出是 Value 的加权和,权重来自当前查询与各 Key 的匹配结果
- 矩阵形式 同时完成所有查询位置的上下文聚合
- 输出保留查询数量,并以 作为每个位置的特征维度
下一课预告
下一课将把单组注意力扩展为多头注意力,理解不同头如何在不同表示子空间中并行提取关系。
按自己的节奏,确认真正理解。